
헤르메스 에이전트를 위한 후견지명: 로컬 LLM을 활용한 셀프호스트드 메모리
자체 하드웨어에서 지속되는 Hermes 메모리.
자체 호스팅 AI 에이전트는 긴 컨텍스트 윈도우만으로는 충분하지 않습니다. 유용한 사실을 보존하고, 이전 결정을 검색하며, 프로젝트가 발전함에 따라 자신이 알고 있다고 생각하는 것을 재수정할 수 있는 방식이 필요합니다.
Hermes Agent에는 기본 내장 메모리 파일이 제공되지만, 외부 프로바이더를 사용하면 세션 간 훨씬 풍부한 검색이 가능합니다. Hindsight는 해당 분야에서 가장 흥미로운 선택지 중 하나입니다. 이 가이드는 클라우드 추론 없이 Hindsight를 Hermes용으로 설치하는 방법을 안내하며, 먼저 올인원 Docker 컨테이너로 시작하고, 이후 개별 로컬 모델 엔드포인트와 기존 PostgreSQL 서버를 함께 사용하는 방식으로 진행합니다.
이 가이드는 배포, 로컬 임베딩, 리랭킹, 생성형 모델 선택 및 연결, auto-retain이 뱅크에 기록하는 내용 제어, Hermes 연결, 그리고 운영 계층인 백업, 내장 뱅크를 전용 PostgreSQL 서버로 이전, 일상적인 뱅크 관리를 다룹니다. 예제에는 의도적인 포트 스킴이 사용됩니다 — 메인 llama.cpp 서버는 8080, 임베딩은 8081, 리랭킹은 8082, Ollama는 11434 — 따라서 이미 사용 중인 포트로 변경하고 작은 서버들을 메인 모델의 포트와 겹치지 않도록 하세요.
Hindsight의 기능
Hindsight는 지속적 에이전트 메모리 엔진으로 세 가지 주요 작업을 수행합니다: retain(보관), recall(회상), reflect(반성). Retain는 정보를 추출하여 저장하고, recall은 의미론적, 키워드, 그래프, 시간적 검색을 결합하며, reflect는 축적된 메모리로부터 답변을 종합합니다. 백그라운드 통합(consolidation)은 중복된 관찰 사항을 더 유용한 지식 계층으로 변환할 수 있습니다.
이것은 단순히 임베딩 데이터베이스가 아닙니다. 벡터 스토어는 유사한 구문을 위치할 수 있지만, 메모리 시스템은 또한 연대기, 프로젝트 경계, 모순되는 증거, 결정의 변화를 보존해야 합니다. 이러한 실패 모드는 자가 강화 메모리 루프에서 다루어집니다. 에이전트 메모리는 모델 추론을 미래의 증거로 변질시킬 수 있습니다. 이러한 루프가 형성되는 방법, 왜 중요한지, 그리고 어떤 쓰기 경로 제어 기능이 이를 제한하는지 확인해 보세요.
더 넓은 시장 환경에 대해서는 에이전트 메모리 프로바이더 비교를 참고하세요. 10개의 메모리 백엔드에 대한 캡처 정책, 의존성, Hermes 활성화 정보를 제공합니다. Hermes의 기본 내장 MEMORY.md, USER.md 및 메모리 모드는 Hermes Agent 메모리 시스템 가이드에서 다루므로, 이 기사는 내장 계층의 작동 방식을 이미 알고 있다고 가정합니다.
Mnemosyne를 넘어선 이유
Mnemosyne for Hermes는 SQLite 저장 및 하이브리드 검색을 포함한 매력적인 로컬 우선 아이디어를 제안합니다. 로컬 Hermes 메모리 프로바이더로 Mnemosyne를 설치하고, 회상 및 보관을 구성하며, SQLite 스토어를 검사하는 방법을 안내합니다. 그러나 실제로는 설치 제약, 버전 호환성, 쓰기 승인 동작, 4.0 사전 릴리스 주변의 급격한 변화로 인해 예측 가능하게 운영하기 어려울 수 있습니다. 이는 운영상의 우려일 뿐, Mnemosyne의 메모리 모델이 근본적으로 flawed하다는 증거는 아닙니다.
Hindsight도 의존성이 전혀 없는 것은 아닙니다: Docker 이미지와 로컬 모델은 상당한 디스크 공간을 소모할 수 있습니다. 그 API를 독립적 서비스로 실행하고, 추론은 다른 곳에서 수행하면 에이전트 자체로부터 업그레이드와 문제 해결을 분리할 수 있습니다.
배포 방식 선택
| 구성 요소 | A: 올인원 컨테이너 | B: 기존 PostgreSQL 서버 |
|---|---|---|
| Hindsight API 및 UI | Docker 컨테이너 | Docker 컨테이너 |
| PostgreSQL | 컨테이너 내장 pg0 |
기존 PostgreSQL 머신 |
| 생성형 LLM | 외부 llama.cpp | 외부 llama.cpp |
| 임베딩 | 기본 로컬 또는 외부 | 외부 Ollama 또는 llama.cpp |
| 리랭킹 | 기본 로컬 또는 외부 | 외부 리랭 서버 |
| 적합한 용도 | 빠른 평가 | 장기 실행, 격리된 설치 |
여기서 “올인원"은 Hindsight API, UI, 데이터베이스가 하나의 컨테이너 내에 있다는 뜻이며, 추론 LLM은 여전히 다른 곳에서 호스팅됩니다. 이는 의도적인 것입니다: Docker의 공식 Hindsight 이미지에는 바로 사용 가능한 로컬 생성형 llama.cpp 서버가 번들되지 않아서입니다.
다른 호스트에서 실행 중인 서비스에 대한 주소는 localhost가 아닌 LAN에서 도달 가능한 주소를 사용하세요. 이러한 포트는 신뢰할 수 있는 클라이언트에만 제한하세요. 예제에 사용된 dummy 키는 인증이 아닌 호환성용 플레이스홀더입니다.
옵션 A: 올인원 Hindsight 컨테이너
Hermes VM에 Python, Torch, 로컬 모델 의존성이 가득 차는 것을 원하지 않을 때 Hindsight를 평가하는 가장 간단한 방식입니다. 컨테이너는 Hindsight와 내장 PostgreSQL을 실행하며, 메인 llama.cpp LLM이 메모리 추출과 반성을 처리합니다.
여기서 중요한 이미지 태그가 두 가지 있습니다. ghcr.io/vectorize-io/hindsight:latest는 큰 이미지로, AMD64 기준 약 9GB이며 BGE 임베더, MiniLM 리랭커, 내장 PostgreSQL을 번들하기 때문입니다. latest-slim은 약 500MB이며 이 두 모델이 다른 곳에 존재한다고 가정합니다. 이는 [로컬 모델 서빙 및 연결]에서 임베딩 및 리랭킹 설정으로 Hindsight를 가리키고 싶어 할 때 원하는 것입니다. 헬스 체크가 통과하면 특정 태그를 고정하세요: 움직이는 태그는 유지하려는 데이터베이스에는 적합하지 않습니다.
Hindsight 호스트에서 디렉터리와 Compose 파일을 생성하세요:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # Memory API
      - "9999:9999"  # Control-plane UI
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
WORKSTATION_IP를 llama.cpp를 실행하는 호스트로 교체하세요. Linux에서는 컨테이너가 위와 같은 host-gateway 매핑을 선언한 경우에만 host.docker.internal이 해석됩니다. 그렇지 않으면 http://host.docker.internal:8080/v1인 기본 URL은 어디로도 가리키지 않습니다. 1GB 공유 메모리 예약은 내장 PostgreSQL 인덱싱에 특히 유용하며, Docker의 작은 기본 /dev/shm은 실패를 일으킬 수 있습니다. 이름이 붙은 볼륨은 컨테이너가 재생성될 때 데이터베이스를 보존하며, 바인드 마운트 대안方案的 접근은 이미지 내부의 사용자인 uid 1000에 의해 소유되어야 합니다.
HINDSIGHT_API_WORKER_ID는 재생성 간에 안정적으로 유지되어야 합니다 — Docker의 기본값은 컨테이너 호스트네임이며, 컨테이너가 죽었을 때 중간에 있던 작업은 구의 워커 ID 아래에서 막혀 있게 됩니다.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
설치된 Hindsight 버전이 다른 경로에 헬스를 노출하는 경우, http://localhost:8888/docs와 컨테이너 로그를 검사하세요. 컨트롤 평면은 일반적으로 http://HINDSIGHT_HOST:9999에서 사용할 수 있습니다. 기본 배포가 작동하면, 컨테이너 내부에서 기본 모델을 로드하는 대신 [로컬 모델 서빙 및 연결]의 구성으로 임베딩 및 리랭킹 프로바이더를 가리킬 수도 있습니다.
포트 8888이나 9999를 인터넷에 직접 노출하지 마세요. 사설 네트워크 또는 인증된 리버스 프록시를 사용하세요. 내장 PostgreSQL은 테스트에는 편리하지만, 외부 관리 데이터베이스가 백업과 유지보수가 더 쉽습니다. 이미 이 볼륨에 존재하는 뱅크는 [내장 데이터베이스를 전용 서버로 이전]의 덤프 및 복구를 통해 함께 이동합니다.
옵션 B: 기존 PostgreSQL 서버를 대항하는 Hindsight
장기 실행 설치의 경우, Hindsight API, 데이터베이스, 추론 엔드포인트를 분리하는 것이 좋습니다. Hindsight VM은 오케스트레이션과 HTTP 서비스를 실행하기 때문에 여전히 작게 유지될 수 있으며, 무거운 모델은 실행하지 않습니다. 아래 단계는 빈 서버에 대항하여 시작합니다. 이미 옵션 A 볼륨에 존재하는 뱅크는 [내장 데이터베이스를 전용 서버로 이전]에서 이동합니다.
PostgreSQL 및 pgvector 준비
Hindsight는 PostgreSQL 14 이상과 hindsight 데이터베이스 내 벡터 확장 기능이 필요합니다. 이 확장 기능은 데이터베이스마다 적용됩니다: 서버에 패키지를 설치해도 해당 데이터베이스에서 CREATE EXTENSION이 실행될 때까지 아무것도 일어나지 않습니다. Debian 또는 Ubuntu PostgreSQL 서버에서 실제 PostgreSQL 메이저 버전에 맞는 pgvector 패키지를 설치하세요. 예를 들어, PostgreSQL 16의 경우:
sudo apt update
sudo apt install postgresql-16-pgvector
패키지 이름과 가용성은 설정된 apt 저장소에 따라 달라집니다. 사용할 수 없는 경우, pgvector 설치 지침을 따르거나 PostgreSQL PGDG 저장소에서 호환되는 패키지를 설치하세요. 공유 서버에서 PostgreSQL 메이저 버전을 맹목적으로 변경하지 마세요. PGDG PostgreSQL 18 패키지에서, pg_trgm과 btree_gin은 postgresql-18 안에 포함되어 있습니다. 배포판 패키지에서는 해당 메이저 버전에 대해 postgresql-contrib에 있습니다. 내장 데이터베이스는 둘 다와 vector를 사용합니다.
PostgreSQL 관리자로서 전용 역할과 데이터베이스를 생성하세요:
CREATE ROLE hindsight LOGIN PASSWORD 'REPLACE_WITH_LONG_PASSWORD';
CREATE DATABASE hindsight OWNER hindsight;
새로운 데이터베이스에 연결하고 확장 기능을 활성화하세요:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS pg_trgm;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS btree_gin;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname IN ('vector','pg_trgm','btree_gin');"
이러한 확장 기능은 일반적으로 설치에 승격된 특권이 필요하지만, 애플리케이션 역할은 슈퍼유저일 필요가 없습니다. Hindsight는 기본적으로 pgvector를 사용하며, 반복적 ANN 스캔을 위해 0.8.0 이상을 원합니다. 구버전 서버는 그 설정을 거부합니다. HINDSIGHT_API_VECTOR_EXTENSION은 대안적으로 pgvectorscale(매우 큰 뱅크를 위해 Hindsight가 문서화한 DiskANN 옵션) 또는 vchord를 선택할 수 있으며, 둘 다 이 정확한 PostgreSQL 빌드에서 추가 패키징이 필요합니다. 메모리가 이미 존재하는 상태에서 알고리즘을 전환하면 시작이 중단되고 마이그레이션이 요구되므로, 첫 retain 전에 선택하세요. 개인 Hermes 뱅크의 경우, pgvector를 설치하고 중단하는 것이 정답입니다.
pg_hba.conf를 통해 Hindsight 호스트만 허용하세요. 예를 들어:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
PostgreSQL의 listen_addresses를 적절히 설정하고, 호스트 간 연결에는 TLS 또는 신뢰할 수 있는 사설 네트워크를 사용하세요. 이 데이터베이스를 Hindsight Docker 컨테이너와 독립적으로 백업하세요. 서버가 다른 애플리케이션과 공유되는 경우, Hindsight를 자체 데이터베이스에 두거나 HINDSIGHT_API_DATABASE_SCHEMA를 소유한 스키마로 설정하세요. 기본 스키마는 public입니다.
PostgreSQL을 대항하는 Hindsight 실행
Hindsight VM에서 compose.yaml을 생성하세요. 이 버전은 의도적으로 로컬에서 PostgreSQL을 시작하지 않습니다:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
외부 데이터베이스 URL을 .env라는 파일에 저장하세요:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:YOUR_PASSWORD@POSTGRES_IP:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
패스워드가 @, :, / 또는 다른 예약된 URL 문자를 포함하는 경우, 연결 문자열에 넣기 전에 URL 인코딩을 수행하세요. Hindsight VM이 PostgreSQL 포트 5432에 도달할 수 있는지 테스트하고, pg_hba.conf가 Hindsight 호스트를 허용하는지 확인하세요 — URL이 올바르게 보이기라도 서버가 127.0.0.1에만 바인딩되어 있으면 연결이 거부됩니다. 데이터베이스 마이그레이션이 실행되도록 첫 시작을 허용하세요. 시작 시 마이그레이션이 실행되지만 HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false를 설정한 경우를 제외합니다. API와 데이터베이스가 올라간 후, Hermes를 연결하기 전에 [Hindsight용 모델 선택]과 [로컬 모델 서빙 및 연결]을 계속 진행하세요.
Hindsight용 모델 선택
Deploy는 API와 데이터베이스를 네트워크에 올립니다. 다음 결정은 세 가지 추론 역할 — recall 후보를 위한 임베딩, 순서를 다시 정하는 리랭커, retain, reflect, consolidation을 위한 생성형 LLM — 을 채울 모델입니다. 이미 대화가 GPU를 차지하고 있는 CPU Hindsight 호스트에 대한 실용적인 기본값은 인프로세스 Qwen/Qwen3-Embedding-0.6B, 인프로세스 BAAI/bge-reranker-v2-m3, 생성형 작업을 위한 공유 llama.cpp 챗 모델입니다.
임베딩 모델
Hindsight는 시작 시 임베딩 차원을 읽고 뱅크 크기를 그에 맞게 설정하므로, 첫 retain에서 선택한 모델은 재구축하기까지 뱅크가 유지하는 모델입니다. 리더보드 순위보다 차원과 명령 동작이 더 중요합니다: 뱅크가 이미 384- 또는 1024차원이라면 더 강력한 8B 임베더는 마이그레이션에值하지 않습니다. 아래 행은 가장 가볍从重부터 무거움으로 정렬되어 있으며, RAM 수치는 CPU(FP16 / 일반적인 로컬 로드)에서 부팅 시 대략적 footprint이며, GGUF 파일 크기가 아닙니다.
| 모델 | 파라미터 | 차원 | 컨텍스트 | 부팅 크기 | 실행 환경 | 비고 |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | Hindsight 기본값; hindsight:latest에 포함됨. 가장 빠른 로컬 경로. recall_min_scores 기본값을 떠나면 점수 분포가 여전히 다수의 기본값을 교정합니다. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | 중급 영어 BGE; 768차원 뱅크를 고정합니다. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | Hindsight 문서화된 다국어 MiniLM; BGE-small과 동일한 384차원 뱅크 폭으로 50+ 언어. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | onnx 프로바이더의 기본값; ONNX 내보내기가 있는 경우 가벼운 다국어 CPU 경로. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | 일반적인 Ollama 임베더; 클래식 BGE보다 긴 컨텍스트, 여전히 영어 우선. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2 텍스트 전용(비전/오디오 타워 비활성화). 100+ 언어 + 코드; MRL은 512/256/128로 절단; 검색과 문서를 위한 명령 접두사. 완전 다모달 부팅은 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 GB | CPU 또는 GPU | 강력한 다국어 듀얼-인코더; Qwen3-0.6B와 동일한 폭이므로 동일한 차원 교체에도 전체 재-임베딩이 필요합니다. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 GB | CPU | 이 가이드의 기본값. 명령 인지(쿼리 측의 검색 명령); CPU에서 편안함. 로컬 프로바이더는 명령을 자동으로 적용하며, OpenAI 호환 서버는 HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX가 필요합니다. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2.5 GB quant | GPU | Qwen3 품질 티어; 2560차원 뱅크를 고정. 대화형 GPU가 이미 포화 상태이면 실행 불가능. |
모델이 어떻게 실행되는지选择的另一半입니다. Hindsight의 임베딩 프로바이더는 가장 단순从부터 가장 복잡한 부품까지:
| 프로바이더 | 실행 방식 | 최적 상황 | 비고 |
|---|---|---|---|
local |
인프로세스 SentenceTransformers; 사이드카 없음 | 단일 Hindsight 호스트, CPU 임베더 | 기본 경로. HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL 설정. llama.cpp, Ollama, TEI 없음. |
onnx |
인프로세스 ONNX Runtime | Torch보다 가벼운 CPU; 이미 ONNX 내보내기가 있음 | hindsight-api-slim[local-onnx]과 HINDSIGHT_API_EMBEDDINGS_ONNX_* 필요. |
openai / tei |
외부 OpenAI 호환 또는 HF TEI 엔드포인트 | API 프로세스로부터 임베딩 분리; 공유 GPU/CPU 호스트 | [로컬 모델 서빙 및 연결]에서 Ollama / llama.cpp / TEI를 구성하는 것. 격리 또는 다른 머신을 원하는 경우에만 사이드카가 가치 있음. |
Qwen3-Embedding-0.6B는 외부 임베딩 서비스가 필요하지 않습니다. CPU Hindsight 호스트에서는 local 프로바이더와 함께 API 프로세스 내에서 로드되며 — Hugging Face가 첫 시작 시 가중치를 다운로드하고, 프로바이더가 모델의 검색 명령을 자체적으로 적용합니다:
# Compose environment (or equivalent .env keys)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
임베더를 다른 머신 또는 API 프로세스 밖으로 두는 경우에만 외부 OpenAI 호환 엔드포인트를 사용하세요. Ollama는 그러한 호스트 중 하나입니다:
# Embeddings: Qwen3-Embedding-0.6B on Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
호스트, 포트, 태그를 추론 머신에서 ollama list가 표시하는 것으로 교체하세요.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX는 프로바이더에 따라 달라집니다:
| 경로 | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
미설정 / 공백 — 인프로세스 프로바이더가 Qwen의 검색 명령을 자체적으로 적용 | 미설정 / 공백 |
| 외부 Ollama / llama.cpp / OpenAI 호환 | 공식 Qwen3 검색 명령(Query: 앞의 실제 줄바꿈) |
공백 — 저장된 메모리는 원시 텍스트로 유지 |
| 서버가 이미 입력을 Qwen의 템플릿으로 래핑 | 둘 다 공백 — 그렇지 않으면 명령이 두 번 적용됨 | 공백 |
외부 경로에 대해 설정하세요:
# Real newline before Query:. Bash $'...' is the reliable way to pass it.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
Compose YAML에서는 동일한 문자열에 명시적인 \n(또는 리터럴 멀티라인 값)이 필요합니다. 접두사를 첫 retain 전에 설정하세요: 나중에 변경하면 구의 벡터와 새로운 쿼리가 더 이상 동일한 공간에 존재하지 않게 됩니다.
리더보드 순위보다 더 많은 것을 결정하는 두 가지 속성이 있습니다. 명령 민감성: Qwen3 임베딩은 쿼리 측에서 검색 명령을 적용합니다; OpenAI 호환 서버에서 일치하는 접두사가 없으면 저장된 쪽과 쿼리 쪽이 더 이상 동일한 공간에 존재하지 않게 됩니다. 차원 고정: 폭은 시작 시 한 번만 읽히므로, 나중에 0.6B에서 4B로 이동하는 것은 뱅크 마이그레이션이며, 구성 변경이 아닙니다 — 또한 동일한 차원 교체(BGE-M3 ↔ Qwen3-0.6B, 또는 768에서 EmbeddingGemma 2 ↔ nomic)도 벡터 공간을 변경하므로 뱅크 벡터는 자동으로 재계산되지 않습니다. 새로운 뱅크 또는 수동 재-임베딩/재인덱싱을 계획하세요; [메모리 뱅크 내보내기, 가져오기, 마이그레이션]을 참고하세요. BGE-small을 떠난 후, 새로운 점수 분포에 대해 recall_min_scores를 탐지하세요 — BGE-small에서 교정된 임계값은 Qwen3-0.6B에 대해 너무 빠듯하여 리랭커에 후보를 굶길 수 있습니다. Qwen3 계열의 벤치마크 및 GGUF/Ollama 배경에 대해서는 Ollama의 Qwen3 Embedding 및 Reranker 모델를 참고하세요.
리랭킹 모델
임베딩은 후보 집합을 회상합니다; 리랭커는 각 쿼리/문장 쌍에 점수를 매겨 Hindsight가 주입하기 전에 순서를 다시 정합니다. local 프로바이더인 경우, Hindsight는 SentenceTransformers 크로스-인코더(또는 지원되는 경우 생성형 리랭커)를 로드합니다. 외부 Cohere 호환 엔드포인트인 경우, 전체 Cohere 스타일 바디를 HINDSIGHT_API_RERANKER_COHERE_BASE_URL로 게시합니다. 리랭커는 선택 사항이지만, 임베더가 고정되면 일반적으로 가장 큰 recall 품질 레버이며, CPU에서는 종종 recall 벽시계 시간의 대부분을 차지합니다. 행은 가장 가볍从重부터 무거움으로 정렬되어 있습니다.
| 모델 | 파라미터 | 유형 | 컨텍스트 | 실행 환경 | 비고 |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | 크로스-인코더 | 128 | CPU | Hindsight 기본값; hindsight:latest에 포함됨. ~20개 후보에 대해 1초 미만. 더 무거운 BGE 모델이 너무 느린 경우 명명된 폴백으로 유지. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | 크로스-인코더 | 512 | CPU | 동일한 계열, 더 높은 정확도; 여전히 영어 편향 MS MARCO. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | 크로스-인코더 | 512 | CPU | Hindsight 문서화된 다국어 MiniLM 리랭커. |
BAAI/bge-reranker-base |
278M | 크로스-인코더 | 512 | CPU | MiniLM에 대한 중급 업그레이드; en/zh. 자주 논의됨; v2-m3가 이미 지연 시간 예산에 맞으면 건너뜀. |
BAAI/bge-reranker-v2-m3 |
568M | 크로스-인코더 | 8k | CPU 또는 GPU | CPU에서 실용적인 다국어 기본값. ~500 메모리 뱅크에서, 20-후보 바닥 기준 리콜당 ~2.6–2.8s(~140 ms/후보; 리콜 시간의 ~93–99%). 후보 캡 20/40/80; 바닥을 20 → 10으로 낮추면 리랭 비용이 거의 절반으로 줄어듦. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | 생성형 (yes-token) | 32k | GPU 권장 | 명령 인지, 긴 컨텍스트. 드롭-인 크로스-인코더가 아님: 최신 SentenceTransformers 생성형-리랭커 지원이 필요하고, llama.cpp /rerank 스코어링에 알려진 잘못된 스코어 버그가 있음(hindsight-benchmarks#11). 채택 전에 검증. |
BAAI/bge-reranker-v2-gemma |
2.5B | 크로스-인코더 | 8k | GPU 권장 | 강력한 다국어 품질; GPU가 이미 가득 찬 경우 몇백 개의 메모리 개인 뱅크에 대해 과도함. |
Qwen/Qwen3-Reranker-4B |
4B | 생성형 | 32k | GPU | 더 높은 품질의 Qwen 후보; 전용 VRAM 없이는 실행 불가능. |
Qwen/Qwen3-Reranker-8B |
8B | 생성형 | 32k | GPU | 계열 최상위 티어; 동일한 생성형 스코어링 주의 사항, 더 큼. |
클라우드 API 리랭커(Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe 등)는 Hindsight에서 작동하지만 메모리 텍스트를 박스 밖으로 전송합니다. 로컬 전용 크로스-도메인 레이아웃에서는 범위 밖입니다.
두 가지 운영 제약이 선택을 지배합니다. VRAM: 대화형 모델이 이미 GPU를 포화 상태에 두고 있다면(예: 여유 공간이 없는 16 GB 카드에서 Q5의 Qwen3.8-27B), 모든 “GPU 권장” 행은 제외되고 활성 선택은 CPU의 MiniLM 또는 BGE-v2-m3로 수렴합니다. 후보 수: HINDSIGHT_API_RERANKER_MAX_CANDIDATES(아래 외부 엔드포인트 예제의 30)는 모델이 다시 점수를 매기는 문장의 수를 제한합니다; 각 후보는 완전한 포워드가므로, 모델 티어를 건너뛰기 전에 바닥을 줄이세요. llama.cpp를 통한 Qwen3의 경우, GGUF는 랭킹 헤드를 유지해야 합니다 — 그것을 삭제하는 구버전 convert_hf_to_gguf.py는 모든 문장에 거의 0을 점수 매기며, 올바른 변환조차 생성형 스코어링 경로가 확인될 때까지 알려진 좋은/나쁜 문장 테스트가 필요합니다.
생성형 LLM 티어
임베딩과 리랭킹 모델은 메모리를 추출하고 추론하는 데 사용되는 생성형 LLM을 대체하지 않습니다. Hindsight는 기본 LLM과 작업별 오버라이드를 지원하며, 동일한 llama.cpp 서버 또는 독립적 엔드포인트를 대상으로 할 수 있습니다.
| Hindsight 작업 | 목적 | 실용적 모델 티어 | Qwen 예시 |
|---|---|---|---|
| Retain | 사실, 엔티티, 결정, 연대기 추출 | 테스트를 위한 최소 4B; 권장 9B | Qwen3.5-4B / Qwen3.5-9B |
| Recall | 의미론적, 키워드, 그래프 및 시간적 검색 | 생성형 LLM 불필요 | Qwen3-Embedding-0.6B + 리랭커 |
| Reflect | 검색된 메모리를 종합하여 질문에 답함 | 9B 이상 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Consolidation | 관련 사실 조율 및 압축 | 권장 9B | Qwen3.5-9B / Qwen3.8-27B |
| Mental model refresh | 더 긴 수명의 종합적 이해 업데이트 | 9B 이상 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
이것들은 공식 Hindsight 최소 파라미터 수가 아닌 운영 권장 사항입니다. 작은 모델은 포트 번호를 올바르게 추출할 수 있지만, 이전 아키텍처 결정이 대체되었음을 놓칠 수 있습니다. 명목상 파라미터 수보다 구조적 출력 신뢰성과 부정의 충실한 처리가 더 중요합니다. Hindsight 자체의 온도 기본값은 그대로 두는 것이 좋습니다 — retain은 0.1, consolidation은 0.0, reflect는 0.9 — 그리고 retain과 consolidation에 대해, llama.cpp 빌드에 alias가 있는 경우 비사고(thinking) alias를 서빙하는 것이 가치가 있습니다. 왜냐하면 작은 Qwen3.5 체크포인트는 사고 모드에서 많은 토큰을 소비하기 때문입니다.
기존 Qwen3.8-27B llama.cpp 엔드포인트가 있는 배포의 경우, 저 동시성으로 생성형 Hindsight 작업을 공유하는 것으로 시작하세요:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
나중에, 일상적인 추출을 독립적 9B 모델로 라우팅하고 어려운 반성을 위해 27B를 예약하세요:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://MEMORY_LLM_HOST:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
더 작은 4B 모델은 경제적이지만 테스트가 필요하며, 9B는 합리적인 품질/성능 절충안입니다. retain과 consolidation이 작은 모델을 공유하면, HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE를 2로 낮추세요 — 기본 배치 8은 작은 컨텍스트 윈도우에 대해 긴 프롬프트입니다. Qwen3.6-35B-A3B는 별도의 잘 프로비저닝된 추론 서버에 매력적입니다(약 30억 개의 활성 파라미터를 가진 혼합-전문가 모델이므로 작은 활성 모델로 예산을 계획하세요), 반면 27B dense 모델은 일반적으로 모든 일상적인 retain 이벤트에 대해 불필요합니다. 백그라운드 동시성을 제한하면 Hermes 대화형 모델이 메모리 유지 보수 버스트로부터 보호됩니다.
로컬 모델 서빙 및 연결
[모델 선택]의 인프로세스 local 임베딩 및 리랭커 설정이 충분하다면, 외부 Ollama와 llama.cpp 소節을 건너뛰고 연결으로 이동하거나 — 또는 Compose를 거기에 표시된 local 기본값으로 유지할 수 있습니다. 외부 엔드포인트는 임베더 또는 리랭커가 다른 호스트에 존재해야 할 때 중요합니다.
외부 임베딩: Ollama 또는 llama.cpp
외부 임베딩은 Qwen3-Embedding-0.6B(또는 다른 모델)를 별도의 호스트에 두는 경우를 위한 것입니다. 두 가지 실용적 옵션은 모델 획득과 서빙을 소규모 구성으로 처리하는 Ollama와, GGUF 양자화, CPU 스레드, 장치 배치, 배치 처리에 대한 정밀한 제어를 제공하는 llama.cpp입니다. 두 Qwen3 모델의 모델 배경과 벤치마크는 Ollama의 Qwen3 Embedding 및 Reranker 모델에 있습니다.
Qwen3-Embedding-0.6B는 1024차원 벡터를 반환하고, Hindsight는 시작 시 그 폭을 읽고 데이터베이스 크기를 그에 맞게 설정합니다. 번들된 384차원 BGE 모델로 생성된 뱅크는 이 모델을 받을 수 없습니다 — 빈 데이터베이스 또는 볼륨에서 시작하고, 첫 retain 전에 임베딩 모델을 결정하세요. 나중에 임베딩 프로바이더 전환은 두 모델이 동일한 차원을 사용하더라도 저장된 레코드의 재-임베딩을 요구합니다.
옵션 1: Qwen3-Embedding-0.6B를 위한 Ollama
추론 호스트에 공식 Linux 설치 문서를 사용하여 Ollama를 설치하고, 임베딩 모델을 시작하세요:
ollama pull qwen3-embedding:0.6b
ollama serve
원격 액세스를 위해, 서비스 환경에서 Ollama의 OLLAMA_HOST=0.0.0.0:11434를 구성하고, 서비스를 재시작하며, Hindsight VM에 대한 방화벽을 설정하세요 — 절차는 Ollama 원격 액세스에 다루어집니다. OLLAMA_HOST, systemd 오버라이드, 리버스 프록시, 방화벽 규칙을 안전히 구성하세요. 127.0.0.1에만 바인딩된 데몬은 Hindsight 컨테이너에 보이지 않습니다. 먼저 ollama list로 모델 이름을 확인하고, 표준 임베딩 엔드포인트를 테스트하세요:
curl http://EMBED_HOST:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"A test memory"}'
Hindsight의 OpenAI 임베딩 프로바이더는 대신 Ollama의 OpenAI 호환 /v1/embeddings 엔드포인트를 호출합니다. Hindsight를 구성하기 전에 해당 엔드포인트가 Ollama 버전에서 작동하는지 확인하세요. Ollama는 임베딩에 대해 단순합니다; 그 API가 호환되는 리랭킹 엔드포인트를 제공하는 것으로 가정하지 마세요. 리랭킹에 대해, 아래 인프로세스 local BGE 경로를 선호하거나, 스코어를 검증한 후 별도의 llama.cpp / TEI 엔드포인트를 사용하세요.
옵션 2: Qwen3-Embedding-0.6B를 위한 llama.cpp
검증된 Qwen3-Embedding-0.6B GGUF 변환을 다운로드하세요. 실제로 다운로드한 GGUF 파일 이름을 사용하세요:
#!/bin/sh
# start-embedding.sh - CPU-only embedding server
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Qwen3 임베딩은 일부 BGE 모델이 사용하는 CLS 풀링과 달리 마지막 토큰 풀링을 사용합니다. 대화형 모델이 GPU를 차지하는 워크스테이션에서 CUDA 초기화를 절대 원하지 않는 경우, CPU 전용 llama.cpp 빌드가 선호됩니다. 이 임베딩 서버에서 --reranking을 활성화하지 마세요: 그 조합은 영 벡터를 얻는 알려진 방법입니다.
curl -s http://EMBED_HOST:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"A test memory"}' \
  | jq '.data[0].embedding | length'
전체 차원의 Qwen3-Embedding-0.6B 출력에는 1024개의 플로트가 포함되어야 합니다. GGUF 변환과 Hindsight 쿼리/문서 명령 처리가 호환되는지 확인하세요; 명령 민감한 임베딩 모델은 잘못 프롬프트될 때 정확도를 잃을 수 있습니다.
리랭커: 로컬 BGE 또는 llama.cpp를 통한 Qwen3
리랭킹은 임베딩과 다릅니다: 모델은 각 쿼리/문서 쌍에 점수를 매겨 관련성 스코어를 반환합니다. CPU 전용 Hindsight 호스트에서 — 또는 대화형 GPU에 VRAM 여유가 없을 때 — 실용적 경로는 BAAI/bge-reranker-v2-m3(또는 더 가벼운 MiniLM 기본값)와 Hindsight의 local 프로바이더입니다. 사이드카가 필요하지 않습니다:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B는 생성형 yes-token 스코어러이며, 클래식 크로스-인코더가 아닙니다. 랭킹을 위해 설계된 GGUF 변환으로 llama.cpp를 통해 서빙할 수 있지만, 알려진 좋은/나쁜 쌍에서 스코어를 확인하기 전까지 그 경로를 실험적인 것으로 취급하세요: 랭킹 헤드를 삭제하는 구버전 convert_hf_to_gguf.py는 모든 문장에 거의 0을 점수 매기며, llama.cpp의 네이티브 /rerank 경로에는 이 계열에 대한 알려진 잘못된 스코어 보고가 있습니다.
#!/bin/sh
# start-reranker.sh - GPU or CPU as selected by --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
CPU에서 실행하려면 --n-gpu-layers 0을 설정하세요. GPU 버전은 모델 가중치뿐만 아니라 계산 버퍼와 컨텍스트를 위한 추가 VRAM이 필요하며, 파일 크기가 총 GPU 할당이 되는 것으로 가정하지 마세요.
curl -s http://RERANK_HOST:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"PostgreSQL storage", "documents":["Hindsight stores memories in PostgreSQL.","A recipe for bread."], "top_n":2}' \
  | jq
PostgreSQL 문서는 관련 없는 문서보다 높은 순위를 매겨야 합니다; 모든 영 관련성 스코어는 GGUF가 잘못된 변환임을 의미하며, 사실이 저장되어 있더라도 recall이 무작위로 보일 것입니다. 정확한 results[].index와 results[].relevance_score 형식을 확인하세요: Hindsight는 Cohere 호환 리랭 응답을 기대하며, llama.cpp 호환성은 빌드 간에 달라질 수 있습니다.
엔드포인트를 Hindsight에 연결
다음 환경 설정을 Hindsight Compose 서비스에 추가하거나 .env 파일에 저장하세요. 하나의 임베딩 경로를 선택하세요 — 인프로세스 local, Ollama, 또는 llama.cpp — 동시에 두 개는 선택하지 마세요.
# Option A: in-process Qwen3 on the Hindsight host (CPU; no sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Option B: llama.cpp embedding service
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://EMBED_HOST:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option C: Ollama on another host
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option: local BGE reranker (no sidecar; preferred on CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Option: llama.cpp Cohere-compatible rerank endpoint (validate Qwen3 scores first)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://RERANK_HOST:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
변수 이름은 프로바이더별이며, 근소한 오탈자는 침묵으로 처리됩니다: HINDSIGHT_API_EMBEDDINGS_BASE_URL은 잘못된 키이며, Hindsight는 로컬 서버 대신 OpenAI 자체의 임베딩 엔드포인트를 조용히 노립니다. HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL을 사용하세요. Cohere 호환 리랭커 경로에서, Hindsight는 전체 Cohere 스타일 바디를 HINDSIGHT_API_RERANKER_COHERE_BASE_URL로 게시합니다; 컨테이너 로그에 /v1/rerank/rerank에 대한 404가 표시되면, 당신의 빌드가 자체적으로 /rerank를 추가하므로 값은 /v1에서 멈추어야 합니다.
옵션 B와 C의 경우, 임베딩 모델의 HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX 값을 사용하세요(옵션 A는 미설정). 첫 retain 후 실제 메모리에 대해 쿼리-문장 검색을 테스트하세요.
기억되는 내용 제어
스택이 실행되면, 다음 실패 모드는 일반적으로 쓰기 경로입니다: Hermes는 기본적으로 auto_retain: true이므로, 모든 대화 턴이 뱅크로 추출될 수 있습니다. 잘못된 추측, 폐기된 계획, 탐색적 진술이 검색 가능한 사실이 되고, 나중에 recall은 그것들을 증거로 취급합니다 — 자가 강화 메모리 루프에서 설명된 루프입니다. 다른 프로바이더 중 Hindsight의 캡처 정책은 에이전트 메모리 프로바이더 비교에 요약되어 있습니다.
현재 존재하는 캡처 모드
“세션 종합"이라는 이름의 Hermes 또는 Hindsight 스위치는 없습니다. 플러그인은 원시 대화 턴(선택적 배치)을 자동으로 보관하거나, 제공하는 content와 함께 명시적인 hindsight_retain 도구 호출을 기다립니다.
| 모드 | Hermes / Hindsight 설정 | 얻는 것 |
|---|---|---|
| 연속 | auto_retain: true, retain_every_n_turns: 1 |
모든 턴이 트랜스크립트 텍스트로 보관 및 추출됨 |
| 배치 자동 | auto_retain: true, retain_every_n_turns 상향 |
턴은 플러그인에서 버퍼링; 매 N번째 턴은 그 원시 턴의 더 큰 retain 페이로드를 발송 — 여전히 자동 추출, 큐레이션된 요약이 아님 |
| 명시적 전용 | auto_retain: false + 도구 hindsight_retain |
에이전트가 content(및 선택적 context / tags)와 함께 도구를 호출할 때까지 아무것도 저장되지 않음 |
배치 자동은 세션 요약을 아닙니다. retain_every_n_turns > 1인 경우, Hermes Hindsight 플러그인은 메모리에서 턴을 축적하고 그것들을 대화 JSON으로 보관합니다; /new, /reset, /branch 및 유사한 세션 전환 시, 남은 버퍼를 구의 세션 문서 아래에서 플러시합니다. 전용 세션 종료 요약을 위한 서마라이저는 없으며, 유휴 세션 종료는 historically N > 1일 때 플러시되지 않은 버퍼를 삭제할 수 있었습니다(플러그인에 on_session_end 후크가 없음). 그 트레이드오프를 수락하지 않는 한 N: 1을 선호하세요.
큐레이션된 “이 세션을 기억"은 프롬프트 + 도구 패턴이며, 구성 플래그가 아닙니다. auto_retain: false를 설정하고, Hermes에게 지속 가능한 결정을 요약하고 그 텍스트와 함께 hindsight_retain을 호출하도록 하세요 — 또는 에이전트의 도구 경로를 통해 도구를 직접 호출하세요. 뱅크 reflect와 consolidation은 이미 뱅크에 있는 것에서 종합하는 별도의 Hindsight-서버 작업이며, 세션 종료 기록을 대체하지 않고, Hermes config.json 키에 의해 활성화되지 않습니다.
auto_retain을 false로 설정하면 자동 턴 저장을 비활성화합니다. 각 쓰기 전에 인간 승인 대화를 추가하지 않습니다. 에이전트는 도구가 허용할 때 언제든 hindsight_retain을 호출할 수 있으며; 명시적 retain을 대기열이 아닌 의도적인 캡처로 취급하세요.
승인-큐 갭
일반적인 욕망은 뱅크에 들어가기 전에 검토하고 승인하는 후보 메모리의 대기열입니다. Hermes 아래 Hindsight는 현재 그 계약을 제공하지 않습니다. Mnemosyne for Hermes는 일부 버전에서 프로바이더별 단계적 기록을 구현합니다; 그 경로는 공유 Hermes 표준이 아니며 Hindsight 플러그인에 적용되지 않습니다. 업스트림 승인 플로우가 존재할 때까지, 작동 가능한 패턴은 auto_retain: false, 의도적 hindsight_retain, 그리고 나쁜 사실에 의존하기 전에 Hindsight 컨트롤 평면 UI에서 검사 또는 삭제입니다. Hindsight에 대해 config.json에서 탐색할 누락된 write_approval 키는 없습니다.
뱅크 스티어링(미션, 라벨, 지시, 멘탈 모델)
사람들은 다음 계층을 “파인튜닝"이라고 자주 부릅니다. Hindsight에서 그것은 대부분 Hermes config.json 단독이 아닌 뱅크 구성입니다: 미션과 추출 설정은 retain이 무엇을 유지하는지 스티어링하며; 라벨은 엔티티를 구조화하고; 지시와 멘탈 모델은 나后来的 합성을 형성합니다.
| 제어 | 위치 | 도움 방식 |
|---|---|---|
Retain 미션 (retain_mission / Hermes bank_retain_mission) |
뱅크 구성 | 추출에 주입되는 평범한 언어 “X에 주의하고, Y를 무시하세요” |
추출 모드 (concise, verbose, custom, …) |
뱅크 구성 | concise(기본값)는 장기 가치가 있는 사실을 유지; custom은 retain_custom_instructions을 통해 내장 규칙 대체 |
| 엔티티 라벨 | 뱅크 구성 | retain 시의 제어된 key:value 어휘 → 그래프 링크 및 선택적 태그; 검색 구조 개선, 스스로 잘못된 진술을 거부하지는 않음 |
| 지시 (“하드 룰”) | 뱅크 지시 API | reflect 중에 강제되는 명시적 명령(태그 범위); 합성 제약, 쓰기 승인 게이트가 아님 |
| 멘탈 모델 | 뱅크 멘탈-모델 API | 반복적인 질문에 대한 상시 답변, 매칭 메모리로부터 reflect를 통해 갱신; 유도적이므로 나쁜 소스 사실이 여전히 그것들을 오염시킴 |
| Reflect / 관찰 미션 | 뱅크 구성 | 합성과 통합을 스티어링, 원시 retain 파이어호스가 아님 |
미션, concise 추출, 라벨은 노이즈를 줄이고 검색을 개선합니다. 정확성이 완전성보다 중요할 때 자동-retain을 끄는 것을 대체하지 않습니다. 지속 가능한 프로젝트 결정을 지목하고 채팅 로지스틱스를 무시하는 짧은 retain 미션을 선호하세요; 실제 분류법이 있을 때만 엔티티 라벨을 추가하세요; 뱅크가 이미 깨끗한 사실을 보유할 때 두세 개의 반복 질문에 대해 멘탈 모델을 추가하세요.
권장 위생 프로필
개인 Hermes 뱅크에 대한 구체적인 시작점:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
뱅크에서, retain 미션을 설정하고 추출을 concise 모드로 유지하세요(컨트롤 평면 또는 Banks API를 통해). 명시적 retain 후, UI를 열고 관찰 사항을 확인하고, 통합 또는 멘탈-모델 리프레시 실행 전에 실수를 삭제하세요. recall_prefetch_method를 recall로 유지하세요 — reflect는 모든 턴 전에 챗-모델 호출을 소비하고 근본적인 사실이 아닌 합성을 주입합니다.
Hermes Agent를 Hindsight에 연결
Hermes VM에서, 카탈로그 플러그인을 설치하고, 설정 마법사를 실행하세요. Hindsight와 local_external 모드를 선택하세요; 플러그인은 내장 PostgreSQL을 시작하거나 로컬에서 Hindsight 모델 스택을 실행할 필요가 없으며, local_embedded는 방금 실행한 컨테이너 옆에 두 번째 Hindsight 데몬을 시작할 것입니다.
hermes plugins install hindsight
hermes memory setup hindsight
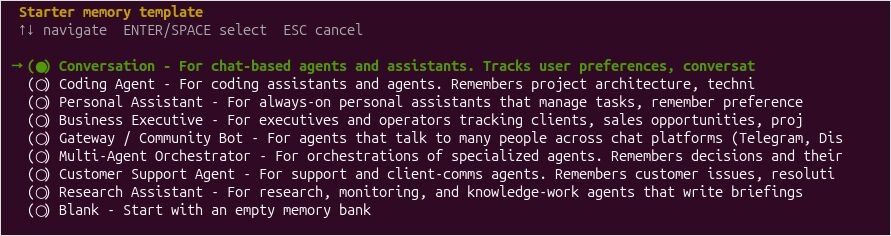
There will be Interesting set of options of agent role using hindsight
hermes memory status
외부 Hindsight 연결은 ~/.hermes/hindsight/config.json에 존재합니다. 연속 캡처(Hermes 기본값)를 유지하는 예시 구성:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
명시적 전용 retain과 뱅크 스티어링에 대해, auto_retain을 켜는 대신 기억되는 내용 제어의 위생 프로필을 사용하세요. recall_sync: false는 대화형 응답성을 우선시하지만 다음 턴에서 회상된 컨텍스트를 주입할 수 있습니다. 현재 요청이 모델이 답변을 시작하기 전에 최신 메모리를 통합해야 하는 경우 동기 recall을 사용하세요. retain_async: true는 메모리가 처리되는 동안 일반 응답을 막지 않습니다.
플러그인의 recall 기본값은 관찰 전용입니다; 원시 세계 및 경험 사실은 통합이 관찰을 기록하거나 recall_types를 observation,world,experience로 넓힐 때까지 뱅크에 남아 있고 프롬프트 밖에서 유지됩니다. 첫 주 동안 넓히고 컨트롤 평면을 관찰한 후, 좁히는 것은 합리적인 순서입니다.
내장 Hermes 메모리는 프로바이더 옆에 활성으로 유지됩니다; Hindsight가 무엇을 추가하는지 배우는 동안 MEMORY.md와 USER.md를 켜 두는 것은 괜찮으며, 메모리-시스템 기사는.flat 파일이 유지되어야 하는지 결정하는 곳입니다.
이미 실행 중이면 게이트웨이를 재시작하세요:
hermes gateway restart
hermes memory status
상태는 Hindsight가 활성 프로바이더임을 식별해야 합니다. 더 넓은 명령 참조, Hermes’ TUI와 플러그인 명령을 포함하여, Hermes Agent CLI cheatsheet를 참고하세요.
설치뿐만 아니라 메모리를 검증
Hermes에게 테스트 프로젝트에 대한 일회용 사실을 기억하도록 하세요, 다른 세션을 시작하고, 그 사실을 다시 물어보세요. Retention은 기본적으로 비동기이며 추출은 챗 모델을 기다리므로, 판단하기 전에 메인 llama.cpp 서버에 잠시 시간을 주세요. 그 후 더 어려운 경우를 테스트하세요: Hermes에게 이전 결정이 변경되었음을 알리고, 현재 결정이 무엇인지 그리고 왜인지 물어보세요. memory status가 적입과 recall이 올바른 것을 증명한다고 가정하기보다 Hindsight의 UI와 저장된 관찰 사항을 검사하세요.
답변이 빈 것으로 돌아오면, 모델 변경 전에 컨트롤 평면을 검사하세요. recall_types가 관찰 전용이고 통합이 실행되지 않은 동안, retain이 성공해도 recall에 보이지 않을 수 있습니다 — recall_types를 넓히는 것이 첫 번째 검사입니다. 임베딩 서버 로그의 연결 거부는 컨테이너가 임베딩 포트로 도달할 수 없음을 의미하며, 모든 영 리랭커 스코어는 GGUF가 잘못된 변환임을 의미합니다.
쓰기 경로 선택(auto_retain, 미션, 승인 갭)은 기억되는 내용 제어에서 다루어집니다.
문제 해결 및 운영 노트
| 증상 | 가능성 있는 원인 | 첫 번째 검사 |
|---|---|---|
| Hermes가 프로바이더 이용 불가라고 함 | 잘못된 local_external URL 또는 네트워크 규칙 |
curl http://HINDSIGHT_VM_IP:8888/health |
| Docker 시작, PostgreSQL 오류 | 누락된 확장, 잘못된 자격 증명, 또는 불충분한 공유 메모리 | 컨테이너 로그와 pg_extension |
| 임베딩이 401 또는 404 반환 | 잘못된 OpenAI 호환 URL, 잘못된 env 키 이름, 또는 모델 alias 불일치 | 직접 /v1/embeddings 테스트와 변수 이름 |
| 리랭킹 실패 | 엔드포인트 또는 응답 형식 불일치, 이중화된 /rerank 경로 포함 |
직접 /v1/rerank 테스트와 컨테이너 로그 |
| Recall이 사용 가능한 것을 반환하지 않음 | recall_types가 관찰로 제한됨, 또는 영 리랭커 스코어 |
컨트롤 평면, 다음 recall_types, 다음 리랭커 변환 |
| 기존 뱅크가 차원 불일치 보고 | 임베딩 모델 변경 | 일관된 모델로 벡터 재구축/재가져오기 |
| Hermes 응답이 느려짐 | 동기 recall 또는 공유 LLM 경쟁 | 동기 recall 끄기; retain 동시성 제한 |
| 관련 없는 메모리가 반복 | 약한 추출, 노이지한 검색, 또는 불충분한 통합 | 관찰 사항과 관련성 스코어 검사 |
| PostgreSQL 연결이 거부됨 | listen_addresses가 여전히 localhost이거나, 클라이언트가 다른 클러스터의 포트 사용 |
데이터베이스 호스트에서 ss -lntp; listen_addresses 변경 후 그 클러스터 재시작 |
SSL 연결에 대해 pg_hba.conf entry 없음 |
클라이언트 주소에 대한 host 또는 hostssl 행이 없거나, 행에 /32가 없어 건너뜀 |
행 추가, 재로드, PostgreSQL 로그 읽기 |
pg_restore가 덤프를 열 수 없음 |
postgres 사용자가 파일을 보유한 홈 디렉터리로 들어갈 수 없음 |
덤프를 /tmp로 복사하고 거기에서 복원 |
must be owner of extension btree_gin |
COMMENT ON EXTENSION이 애플리케이션 역할로 실행됨 |
빈 데이터베이스 재구축하고 --no-comments로 복원 |
PostgreSQL 18 패키지 설치됨, pg_lsclusters가 14만 표시 |
하나가 이미 존재할 때 새로운 메이저가 클러스터를 생성하지 않음 | sudo pg_createcluster 18 main |
실용적인 작은 배포는 PostgreSQL과 모든 추론이 외부일 때 Hindsight API VM에 2-4 vCPU와 4-6 GB RAM입니다. 디스크 할당은 여전히 선택된 Docker 이미지와 유지된 이미지 레이어에 따라 달라지며; 확장할 여유를 두고 처음에 약 30-40 GB를 할당하세요. PostgreSQL 호스트의 크기는 실제 메모리 볼륨, 저장 성능, 그리고 제공하는 다른 데이터베이스에 따라 결정하세요.
Hindsight 뱅크 백업 및 복원
메모리 뱅크는 중요도가 있는 유일한 상태이며, PostgreSQL에 존재합니다. 옵션 B에서는 관리하는 데이터베이스이고; 옵션 A에서는 컨테이너 내부의 이름이 붙은 볼륨인 내장 pg0입니다. Hindsight 컨테이너와 독립적으로 백업하세요 — 볼륨 또는 데이터베이스를 먼저 캡처하지 않고 컨테이너를 재생성하면 뱅크가 폐기되며, hermes backup은 별도 서비스에서 실행 중인 뱅크에 도달하지 않습니다.
옵션 B — 외부 PostgreSQL. hindsight 데이터베이스를 커스텀 형식으로 덤프하고, 아카이브를 신뢰하기 전에 스크래치 데이터베이스로 복원하여 검증하세요:
pg_dump -h POSTGRES_IP -U hindsight -Fc hindsight > hindsight-bank.dump

# restore into a scratch database to prove the dump is usable
createdb -h POSTGRES_IP -U postgres hindsight-verify
pg_restore -h POSTGRES_IP -U postgres -d hindsight-verify hindsight-bank.dump
원본 덤프 대상 삭제 전에 복원된 사본에서 pgvector 확장 기능과 샘플 recall의 존재를 확인하세요. 덤프를 Hindsight VM과 다른 호스트에 유지하고, PostgreSQL 관리자(데이터베이스를 생성할 수 있는 역할)로서 애플리케이션 역할이 아닌 이 작업을 실행하세요.
옵션 A — 올인원 컨테이너. 내장 데이터베이스는 이름이 붙은 볼륨이므로, 컨테이너를 중지하고 일회용 이미지를 통해 볼륨을 타르하세요:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
타르 컨테이너 내부의 마운트 포인트(/data)는 임의이며; 단순히 tar가 읽을 수 있도록 이름이 붙은 볼륨에 alias를 설정합니다. 동일한 볼륨에 복원하려면, 컨테이너를 중지하고, 볼륨을 비우고, 아카이브를 다시 거기에서 언타르하세요. 그 뱅크를 관리하는 서버로 옮기는 것은 내장 데이터베이스를 전용 서버로 이전의 덤프 및 복원입니다.
캘린더 스케줄이 아닌 세 시점에 스냅샷을 취하세요: 임베딩 모델을 변경하기 전에, 주요 Hindsight 또는 PostgreSQL 업그레이드 전에, 뱅크를 재기록하는 reflect 또는 통합 패스 전에. 스크래치 뱅크에 복원해 본 백업은 단순히 쓰여진 백업보다 가치 있습니다.
내장 데이터베이스를 전용 서버로 이전
올인원 뱅크는 /home/hindsight/.pg0에 마운트된 이름이 붙은 볼륨입니다. HINDSIGHT_API_DATABASE_URL을 설정하면 그 컨테이너는 URL에 이름이 지어진 데이터베이스를 열고 마이그레이션을 실행합니다. 볼륨은 변하지 않습니다. pg_dump와 pg_restore로 행을 이동하고, 동일한 컨테이너를 유지하면서 새 서버를 가리키세요.
설치 가이드는 빈 서버를 시작하는 두 가지 방식인 내장 pg0과 외부 URL을 설명합니다. hindsight-admin 백업 및 복원은 데이터베이스 간 테이블을 복사합니다; restore는 대상 스키마를 truncate하며 먼저 테이블이 존재해야 합니다. 메모리 뱅크 내보내기, 가져오기, 마이그레이션은 임베딩 모델 변경입니다: 그 아카이브는 벡터를 제외하고 대상이 그것들을 재계산합니다. 동일한 임베딩 모델을 유지하는 이동은 벡터를 유지하며, pg_dump가 그것들을 운반하는 파일입니다.
컨테이너 내부의 메이저 버전 일치
pg0은 컨테이너 내부에서 127.0.0.1:5432에서 리스닝합니다. 그 바이너리는 /home/hindsight/.pg0/installation/<version>/bin 아래에 있고, 클러스터 데이터는 /home/hindsight/.pg0/instances/hindsight/data입니다. 역할, 패스워드, 데이터베이스 이름은 기본적으로 hindsight입니다. 그 클라이언트로 서버 버전을 읽으세요. ls /home/hindsight/.pg0/installation이 다른 빌드를 표시하면, 18.1.0 대신 그 디렉터리를 사용하세요:
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/psql \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -c 'SHOW server_version;'
그 서버로부터의 커스텀 형식 덤프는 동일한 메이저 버전 또는 더 새로운 것으로 복원됩니다. 현재 ghcr.io/vectorize-io/hindsight:latest 이미지는 PostgreSQL 18.1을 보고합니다. Ubuntu 22.04의 아카이브 패키지는 18 아카이브를 로드할 수 없는 PostgreSQL 14입니다.
PostgreSQL Apt 저장소에서 배포판 클러스터 옆에 18을 설치하세요. 14/main이 이미 존재할 때, postgresql-18 패키지는 클러스터를 생성하지 않습니다:
sudo apt install -y postgresql-common
sudo /usr/share/postgresql-common/pgdg/apt.postgresql.org.sh
sudo apt update
sudo apt install -y postgresql-18 postgresql-18-pgvector
sudo pg_createcluster 18 main
sudo pg_ctlcluster 18 main start
pg_lsclusters
pg_lsclusters는 14가 여전히 5432에 있을 때 5433인 다음 무료 포트에서 18/main을 표시해야 합니다. 그 포트에서 SELECT version();은 PostgreSQL 18을 보고해야 합니다. postgresql-contrib-18은 전이 패키지 이름입니다: apt가 postgresql-18을 선택하고, 그 패키지가 pg_trgm과 btree_gin을 포함합니다.
PostgreSQL 및 pgvector 준비로부터 역할을, 데이터베이스를, 확장 기능을 생성하고, 모든 psql에서 -p 5433을 전달하여 명령이 18 클러스터를 명중하도록 하세요. 내장 데이터베이스에는 vector, pg_trgm, btree_gin이 있습니다. 소스보다 새로운 pgvector 패키지, 예를 들어 서버의 0.8.7 대 이미지의 0.8.5,는 여전히 덤프를 수락합니다.
컨테이너가 그 포트에 도달하도록 하기
새로운 클러스터는 /etc/postgresql/18/main/postgresql.conf의 listen_addresses에 LAN 주소나 *가 포함될 때까지 로컬호스트에서 리스닝합니다. 그 설정은 18 클러스터가 시작될 때 적용되므로, sudo pg_ctlcluster 18 main restart로 재시작하고 ss -lntp에서 0.0.0.0:5433을 확인하세요. 다른 호스트로부터의 “Connection refused"는 그 주소와 포트에서 TCP를 수락하는 것이 없음을 의미합니다.
/etc/postgresql/18/main/pg_hba.conf에서, Hindsight 호스트를 허용하세요. 마스크는 행의 일부입니다; /32가 없으면 PostgreSQL은 시작 시 행을 건너뜁니다.
host hindsight hindsight HINDSIGHT_HOST_IP/32 scram-sha-256
host는 클라이언트가 기본적으로 여는 SSL 연결과 매칭됩니다. sudo pg_ctlcluster 18 main reload로 재로드하세요. 후속 “no pg_hba.conf entry … SSL encryption” 오류의 주소는 그 행에 써야 할 주소입니다. Docker로부터, 그 주소는 컨테이너를 실행하는 호스트입니다: 브리지는 컨테이너의 아웃바운드 연결을 호스트의 LAN 주소로 번역합니다.
덤프, 다음 18 클라이언트로 복원
라이터를 일시 정지하고, pg0 바이너리로 덤프하세요. pg_dump가 스냅샷을 여는 후 보관된 행은 아카이브에 없습니다.
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/pg_dump \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -Fc --no-owner --no-privileges \
  -f /tmp/hindsight-bank.dump

docker cp hindsight:/tmp/hindsight-bank.dump ./hindsight-bank.dump
데이터베이스 호스트에서, pg_restore는 18 바이너리여야 합니다. 14 클라이언트는 이 아카이브를 읽을 수 없습니다. 먼저 파일을 /tmp로 복사하세요. postgres 시스템 사용자는 다른 사용자의 홈 디렉터리로 들어갈 수 없으므로, ls -l이 모든 사람이 읽을 수 있음을 표시하는 덤프에 대해 pg_restore는 “Permission denied"를 보고합니다.
sudo -u postgres /usr/lib/postgresql/18/bin/pg_restore \
  -p 5433 -d hindsight \
  --no-owner --role=hindsight --no-comments \
  --single-transaction --exit-on-error \
  /tmp/hindsight-bank.dump
--role=hindsight은 복원된 테이블이 애플리케이션 역할에 속하도록 합니다. --no-comments는 슈퍼유저가 확장 기능을 생성하고 애플리케이션 역할이 생성하지 않은 경우 “must be owner of extension btree_gin"로 실패하는 COMMENT ON EXTENSION을 건너뜁니다. --single-transaction은 실패한 로드를 취소하므로, 다음 실행은 빈 스키마에서 시작합니다. 이전 시도로 남은 부분 로드는 재시도 전에 DROP DATABASE와 세 개의 CREATE EXTENSION 진술이 다시 필요합니다.
카운트오버 전에 컨테이너 내부에서 동일한 쿼리를 실행하여 SELECT bank_id FROM banks ORDER BY 1과 SELECT count(*) FROM memory_units를 비교하세요.
컨테이너 전환 및 볼륨 유지
옵션 B의 Compose .env에 18 클러스터가 실제로 바인딩한 포트를 사용하여 URL을 추가하세요:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:URL_ENCODED_PASSWORD@POSTGRES_IP:5433/hindsight
서비스 환경으로 HINDSIGHT_API_DATABASE_URL: ${HINDSIGHT_API_DATABASE_URL}를 전달하세요. HINDSIGHT_API_WORKER_ID를 변경하지 않게 유지하세요. 서비스가 HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL 또는 HINDSIGHT_API_RERANKER_LOCAL_MODEL을 설정할 때 ghcr.io/vectorize-io/hindsight:latest에 머물러 있세요. latest-slim은 컨테이너 외부에서 실행되는 임베딩과 리랭킹 엔드포인트를 위한 옵션 B 이미지입니다. hindsight-pg0 볼륨 마운트를 유지하세요.
docker compose up -d는 컨테이너를 재생성합니다. 로그는 “Connecting to database” 행에서 POSTGRES_IP를 명명해야 하며, curl -f http://localhost:8888/health는 "database":"connected"를 포함해야 합니다. GET /v1/default/banks는 복원된 뱅크를 나열합니다. 이미 저장한 사실을 recall하세요. 게시된 API와 UI 포트는 동일하므로, Hermes와 코딩-에이전트 구성은 기존 기본 URL을 유지합니다.
HINDSIGHT_API_DATABASE_URL 없이 다시 시작하면, URL이 설정되어 있을 때 쓰기를 받지 않은 볼륨을 사용합니다. 그 recall이 성공한 후 볼륨을 제거하세요. 컨테이너가 연결되면, pg_hba.conf를 단일 호스트 행으로 좁히고, 재로드하세요.
메모리 뱅크 내보내기, 가져오기, 마이그레이션
내장 뱅크를 전용 서버로 옮기고, 이미 저장된 벡터를 유지하는 것은 내장 데이터베이스를 전용 서버로 이전에서 다루어집니다. 아래 단계는 임베딩 모델 변경입니다.
임베딩 모델 변경은 구성 편집이 아닙니다. 뱅크의 벡터는 구의 모델로 계산되었고, 다른 모델 — 예를 들어 번들된 384차원 BGE 임베더 대 1024차원 Qwen3-Embedding-0.6B — 은 다른 공간으로 쓰고 보통 다른 폭으로 씁니다. 기존 인스턴스를 새 임베더로 재가리키고 구의 벡터를 유지할 수 없습니다; 차원은 새로운 임베딩 모델로 모든 메모리를 재-임베딩하여 재계산되어야 합니다.
임베더와 그 구성이 Hindsight 인스턴스별로 설정되므로, 깨끗한 경로는 이미 recall을 서빙하고 있는 것 내부에서 벡터를 재구축하는 대신, 새로운 임베딩 구성으로 신선한 인스턴스를 설정하고 뱅크를 그것으로 마이그레이션하는 것입니다. Hindsight API가 뱅크를 이동할 수도 있지만, 일회성 변경에 대해 내보내기/가져오기는 더 쉽고 검사 가능한 경로입니다:
# export the bank from the old instance
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# import the bank into the new instance
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t는 새 인스턴스로 전송하기 전에 아카이브를 검증합니다. 가져오기 후, Hermes를 ~/.hermes/hindsight/config.json의 새 인스턴스의 api_url로 재가리키고, 게이트웨이를 재시작하고, 이전의 메모리 검증을 실행하세요: 보관된 사실이 새 임베더를 통해 recall되어야 합니다. 새 인스턴스가 작동할 때까지 구의 뱅크와 그 벡터를 구의 인스턴스에 유지하여, 여전히 작동하는 폴백이 있도록 하세요.
모니터링, 가지치기, 뱅크 안정성 유지
뱅크가 실행되면, 일상적인 작업은 추출 모델이 저장하기로 결정한 것을 관찰하고 유도된 상태를 점검하는 것입니다. memory status가 적입과 recall이 올바른 것을 증명한다고 가정하기보다, 관찰 사항, 관련성 스코어, 통합 출전을 검사하기 위해 컨트롤 평면 UI(hindsight-embed -p hermes ui start)를 사용하세요. 중복되거나 오래된 메모리는 일반적으로 약한 추출 또는 덜 실행된 통합이므로, 검색을 넓히기 전에 추출 티어 또는 통합 주기를 수정하세요.
뱅크를 신뢰하기 전에 테스트할 가치가 있는 두 가지 유지 보수 함정이 있습니다. 첫째, 관찰 사항 삭제로 모든 유도된 표현이 그것과 함께 사라지는 것을 보장하지 않습니다 — 그것으로부터 구축된 reflect 사실 또는 그래프 모서리는 삭고를 생존할 수 있으므로, 삭고를 끝에서 끝까지, 자가 강화 메모리 루프에서 다루는 동일한 프로베넌스 우려를 통해 검증하세요. 둘째, 재생성 간에 HINDSIGHT_API_WORKER_ID를 안정적으로 유지하고 특정 이미지 태그를 고정하세요: 컨테이너가 죽었을 때 중간에 있던 작업은 구의 워커 ID 아래에서 막혀 있고, 움직이는 태그는 유지하려는 데이터베이스에는 적합하지 않습니다.
