
Hermes Agent에서 셀프 호스티드 LLM 워크플로우를 위한 카나반
자체 호스팅 LLM에서 Hermes Kanban 부하를 제어하세요.
Hermes Agent에는 Kanban 스타일 보드와, 한 번에 너무 많은 작업이 전달될 경우 자체 호스팅 LLM을 포화 상태로 만들 수 있는 Hermes Gateway가 함께 제공됩니다.
이 방식으로 자신의 LLM을 DDoS(분산 서비스 거부) 공격을 하는 것과 같은 효과를 낼 수 있다고 말씀드릴 수 있습니다.
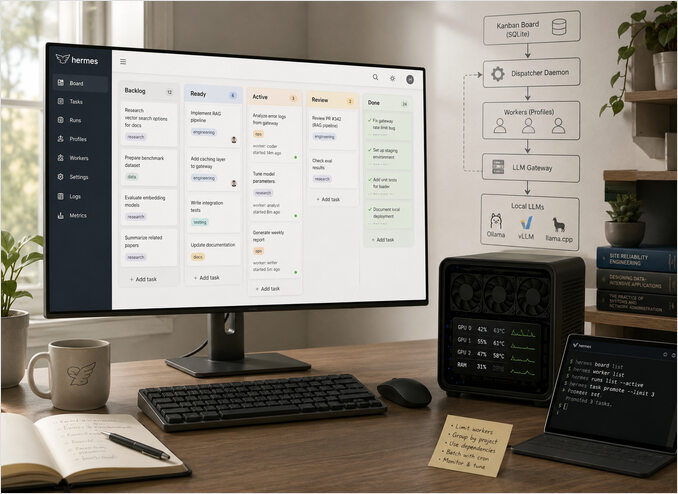
Hermes Kanban은 ~/.hermes/kanban.db에 기반한 내구성 있는 다중 프로필 보드입니다.
각 레인(lane)은 작업의 단계를 나타내며, 각 카드(card)는 특정 Hermes 프로필이 수행하도록 할당될 수 있는 작업입니다.
기본적으로 디스패처(dispatcher)는 한 번에 여러 ready 상태의 작업을 승격(전진)시킬 수 있습니다. 이는 탄력적인 클라우드 API에게는 문제없지만, 소규모 자체 호스팅 GPU 클러스터를 과부하 시킬 수 있습니다.
이 스택에 처음 접하시는 분이라면, 더 넓은 범위의 Hermes 설정 및 운영 가이드와 AI Systems 필러에서 주위 아키텍처를 살펴보시기 바랍니다.
이 포스트는 다음 내용을 보여줍니다:
- 이해하기: Hermes Kanban 디스패치가 LLM 게이트웨이와 어떻게 상호작용하는지.
- 제어하기: 무거운 작업에 대해 병렬성을 안전하게 제어하는 방법.
- 배칭: cron을 사용하여 승격을 배치 처리하여 백그라운드 작업이 인터랙티브 사용과 충돌하지 않도록 하는 방법.
- 모니터링 및 튜닝: 과부하 없이 GPU가 바쁘게 유지되도록 시스템을 모니터링하고 조정하는 방법.
Hermes Kanban과 디스패처 작동 원리
높은 수준의 관점에서, 이 시스템은 세 가지 계층으로 구성됩니다:
- 보드(Board) - 작업, 컬럼, 관계, 역사를 위한 내구성 있는 SQLite 상태.
- 워커(Workers) - 작업을 처리하기 위해 격리된 워크스페이스에서 시작되는 Hermes 프로필.
- 디스패처(Dispatcher) - 전달 가능한 카드를 스캔하고 실행을 시작하는 긴 생명 주기의 프로세스.
CLI 또는 대시보드에서 생성된 작업은 보통 backlog 또는 ready 상태에서 시작됩니다. 아래에서 사용된 hermes kanban 하위 커맨드는 Hermes Agent CLI 치트시트에 요약되어 있습니다.
디스패처는 자격이 있는 카드를 스캔하고, 원자적으로 하나를 점유(claim)하며, 지정된 프로필을 그 도구와 메모리와 함께 시작합니다.
각 워커는 자신의 LLM 게이트웨이 또는 로컬 런타임(예: Ollama, vLLM, llama.cpp에 기반한 OpenAI 호환 엔드포인트)을 호출합니다. 이러한 런타임 간 배포 선택 사항에 대해서는 LLM Hosting in 2026: 로컬, 자체 호스팅 및 클라우드 인프라 비교를 참고하십시오. Ollama 자체의 요청 팬아웃(fan-out)을 튜닝 중이라면, 이는 Ollama가 병렬 요청을 처리하는 방법과 잘 맞습니다.
많은 무거운 작업을 추가하고 승격을 제한하지 않으면, 게이트웨이가 동시 요청으로 인해 압도될 수 있습니다.
단일 GPU 또는 CPU-바운드 호스트에서는, 이는 더 나은 처리량이 아니라 대기열, 스래싱(thrashing), 타임아웃을 의미하는 경우가 많습니다.
현재 실질적 제한 사항
현재 많은 팀이 사용하는 Hermes 빌드에서, 디스패처 설정은 두 가지 Kanban 디스패치 키만 노출하고 설정에서 전역 활성 작업 상한을 적용하지 않습니다:
kanban:
  dispatch_in_gateway: false
  dispatch_interval_seconds: 10
활성 작업 제어에 대해서는 명시적인 디스패치 주기(hermes kanban dispatch --max ...)와 의존성 모델링에 의존하십시오.
알려진 함정:
- 같은 보드에 대해 게이트웨이 임베디드 디스패치와
hermes kanban daemon --force를 동시에 실행하지 마십시오. 그렇지 않으면 점유 경쟁(claim races)이 발생할 수 있습니다. - 게이트웨이가 중단되어 있으면,
ready상태의 작업이 디스패치되지 않고 서비스가 복귀할 때 폭발적으로 발생(burst)할 수 있습니다. - 점유가 틱(tick) 단위로 이루어지기 때문에 더 긴 디스패치 간격은 고르지 않게 느껴질 수 있습니다.
- 런 상태와 재점유(reclaim) 엣지 케이스가 시간에 따라 패치되었기 때문에 버전 간에 동작이 다를 수 있습니다.
동작이 잘못되었을 때의 빠른 검증 방법:
# 1) 정확히 하나의 디스패처 경로가 활성인지 확인
pgrep -af "hermes gateway start|hermes kanban daemon"

# 2) 연결된 Kanban 디스패처 키 확인
rg "dispatch_in_gateway|dispatch_interval_seconds" ~/.hermes/config.yaml

# 3) 대기열 상태 검사
hermes kanban list --status ready
hermes kanban list --status running
주요 아이디어:
- 디스패처 설정은
dispatch_in_gateway와dispatch_interval_seconds를 연결합니다. dispatch --max는 그 패스(pass)에서 생성되는 새 워커 수를 제한할 뿐, 실행 중인 총 작업 수는 제한하지 않습니다.- 소규모 자체 호스팅 클러스터의 경우, 지연 시간이 안정적으로 유지될 때까지는 보수적으로 시작하고 점차 늘리십시오.
Hermes를 LLM 게이트웨이 근처에 처음 배포할 때:
- 설정에 지원되는 Kanban 디스패처 키만 유지하십시오.
- 실제 대기열 하중에서 GPU 및 CPU 사용률을 관찰하십시오.
- 결정론적인 페이싱(pacing)을 위해 전략 1 또는 전략 2를 사용하십시오.
조사 결과 및 근본 원인
hermes kanban dispatch는 max_active_tasks를 위해 config.yaml을 읽지 않습니다.
hermes_cli/kanban.py에서, dispatch 커맨드는 --max를 CLI 상한(기본값 None)으로 노출하고 kb.dispatch_once(...)에 args.max만 전달합니다. 이 경로에서는 max_active_tasks 설정 조회가 없습니다. hermes_cli/kanban.py 원본을 참조하십시오.
그 후 kanban_db.dispatch_once에서, 유일한 상한은 max_spawn이며, 다음과 같은 로직과 동등합니다:
if max_spawn is not None and spawned >= max_spawn:
    break
이미 실행 중인 작업에 대한 체크도 없고, 해당 디스패치 경로에 max_active_tasks 참조도 없습니다. hermes_cli/kanban_db.py 원본을 참조하십시오.
효율적인 동작:
hermes kanban dispatch
해당 패스 동안 제한 없음 (ready 대기열 크기로 제한됨).
hermes kanban dispatch --max 2
해당 패스에서 생성되는 새 워커만 제한할 뿐, 실행 중인 총 작업 수는 제한하지 않음.
게이트웨이 디스패치 주변의 연결된 설정 노브(knob)는 kanban.dispatch_in_gateway와 kanban.dispatch_interval_seconds입니다.
따라서 이 디스패치 경로에서는 구현되어 있지 않기 때문에 max_active_tasks는 무시됩니다.
전략 1 - 엄격한 순차 흐름을 위한 의존성 인코딩
몇 가지 워크플로는 엄격하게 순서대로 실행되어야 합니다. 예를 들어:
- 공유된 중간 산출물이 있는 다단계 데이터 파이프라인
- 마이그레이션 또는 인프라 변경
- 동일한 객체 저장소 또는 데이터베이스에 작성하는 배치 작업
Hermes Kanban은 작업 간 부모-자식 의존성을 지원하여, 자식 카드가 부모가 완료될 때에만 디스패치 가능하도록 합니다.
이를 Hermes CLI 주위의 작은 헬퍼 스크립트로 모델링할 수 있습니다:
#!/usr/bin/env bash

set -euo pipefail

parent_id="$(hermes kanban add \
  --title '4월 고객 로그 수집' \
  --profile 'etl-worker' \
  --column backlog)"

hermes kanban add \
  --title '4월 이상치 보고서 생성' \
  --profile 'analytics-worker' \
  --column backlog \
  --parent "${parent_id}"

hermes kanban add \
  --title '4월 요약 대시보드 게시' \
  --profile 'reporting-worker' \
  --column backlog \
  --parent "${parent_id}"
적절한 보드 정책과 낮은 디스패처 제한을 통해, 먼저 부모 작업만 실행됩니다.
그 작업이 완료되면 자식 작업들이 점진적으로 ready 상태가 되고, 디스패처는 컨커런시 상한을 초과하지 않으면서 하나씩 가져옵니다.
전략 2 - 실행 인지형 디스패치 상한을 위한 Linux cron 사용
결정론적인 페이싱을 원한다면, 호스트 cron과 작은 래퍼 스크립트를 사용하십시오.
항상 dispatch --max 2를 호출하는 대신, 먼저 현재 실행 중인 작업을 계산하고, 남은 슬롯만 디스패치하십시오.
hermes-kanban-dispatch-capped.sh를 생성하십시오:
#!/usr/bin/env bash
set -euo pipefail

MAX_PARALLEL="${MAX_PARALLEL:-2}"
BOARD="${BOARD:-}"

board_args=()
if [[ -n "$BOARD" ]]; then
  board_args=(--board "$BOARD")
fi

# 또는 hermes가 설치된 위치
export PATH="/home/abc/.local/bin:$PATH"

running_out="$(hermes kanban "${board_args[@]}" list --status running)"

if [[ "$running_out" == *"(no matching tasks)"* ]]; then
  running_count=0
else
  running_count="$(printf '%s\n' "$running_out" | wc -l)"
fi

slots=$(( MAX_PARALLEL - running_count ))

if (( slots <= 0 )); then
  echo "Already at limit running=$running_count max=$MAX_PARALLEL dispatch skipped"
  exit 0
fi

echo "running=$running_count max=$MAX_PARALLEL slots=$slots dispatching up to $slots"

hermes kanban "${board_args[@]}" dispatch --max "$slots"
실행 가능하게 만드십시오:
chmod +x ./hermes-kanban-dispatch-capped.sh
다음과 같이 실행하십시오:
MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
특정 보드에 대해:
BOARD=my-board MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
cron으로 분당 1회 스케줄하십시오:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-capped.sh >> /var/log/hermes/kanban-cron.log 2>&1
운영 노트:
- cron은 종종 최소한의
PATH를 가지므로,hermes가 찾られない 경우 스크립트 내에서 전체 경로를 사용하십시오 (예:/usr/local/bin/hermes). /var/log/hermes/...에 로그를 기록하려면, 먼저 해당 디렉터리를 생성하고 cron 사용자가 쓰기 접근 권한이 있는지 확인하십시오.
예시:
sudo mkdir -p /var/log/hermes
sudo chown "$USER":"$USER" /var/log/hermes
다음으로 크론 항목을 생성하거나 편집하십시오:
crontab -e
그 다음으로 확인하십시오:
crontab -l
한 개의 cron 항목으로 분 단위 미만 주기
Cron은 분당 1회 틱하지만, 스크립트 내부에서 짧은 루프를 실행하여 더 자주 디스패치할 수 있습니다.
예시 hermes-kanban-dispatch-subminute.sh:
#!/usr/bin/env bash
set -euo pipefail

LOCK_FILE="/tmp/hermes-kanban-dispatch.lock"
RUNS_PER_MINUTE="${RUNS_PER_MINUTE:-4}"    # 4 runs => every 15 seconds
CAP_SCRIPT="${CAP_SCRIPT:-/opt/hermes/scripts/hermes-kanban-dispatch-capped.sh}"

exec 9>"$LOCK_FILE"
flock -n 9 || exit 0

sleep_seconds=$(( 60 / RUNS_PER_MINUTE ))

for ((i=1; i<=RUNS_PER_MINUTE; i++)); do
  "$CAP_SCRIPT"

  if (( i < RUNS_PER_MINUTE )); then
    sleep "$sleep_seconds"
  fi
done
실행 가능하게 만드십시오:
chmod +x ./hermes-kanban-dispatch-subminute.sh
분당 1회 스케줄하십시오:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-subminute.sh >> /var/log/hermes/kanban-subminute.log 2>&1
flock이 중복 실행을 방지하므로, 이는 실질적인 분 단위 미만 주기를 제공합니다.
이것이 작동하는 이유:
list --status running은 현재 실행 부하를 제공합니다.dispatch --max N은 해당 패스에서만 생성되는 새 워커를 제한합니다.N을 남은 슬롯으로 계산하면, 실행 중인 총 작업 수가 목표 제한 값 근처를 유지합니다.
중요한 주의 사항: 이 상한은 이 스크립트를 통해 수행되는 디스패치에만 적용됩니다.
게이트웨이 임베디드 디스패치를 비활성화하지 않으면, 여전히 독립적으로 작업을 승격시킬 수 있습니다:
kanban:
  dispatch_in_gateway: false
공식 문서는 Kanban 기능 가이드에서 게이트웨이 디스패치 기본값과 함께 두 명령의 기능을 설명합니다: Hermes Kanban 문서.
내부 Hermes Cron
사용하지 마십시오.
정말 LLM이 Execute in terminal the command /path/hermes-kanban-dispatch-capped.sh 같은 정기적인 프롬프트를 처리하게 하고 싶으신가요? 특히 유용한 작업을 하느라 바쁠 때요?
Hermes Kanban 모니터링 및 튜닝
어떤 전략을 선택하든, 다음을 모니터링해야 합니다:
- LLM 게이트웨이 메트릭 — 요청률, 지연 시간, 오류율, 토큰 처리량.
- 노드 건강 상태 — GPU 사용률, VRAM 사용량, CPU 부하 및 RAM.
- Hermes 메트릭 — backlog, ready, active, done 상태에 몇 개의 작업이 있는지.
프로덕션 메트릭 베이스라인 및 대시보드를 위해, Prometheus와 Grafana로 프로덕션에서 LLM 추론 모니터링하기와 더 넓은 LLM Performance 허브를 참조하십시오.
낮은 병렬성으로 시작하여, 다음과 같은 신호를 주시하면서 한도를 점진적으로 높여가십시오:
- 일정한 처리량에서 지연 시간 상승
- 증가하는 타임아웃 또는 레이트 리미트 오류
- 일부 작업이 매우 긴 시간 동안 활성 상태로 유지되는 긴 테일(long tails)
이러한 증상이 보이면 즉시 이전의 안정적인 구성으로 롤백하고, 이를 기본값으로 유지하십시오.
Kanban이 적합한 도구인 경우
Hermes Kanban은 다음 상황에서도 빛을 발합니다:
- 긴 생명 주기의 연구 또는 엔지니어링 백로그
- 이름 붙여진 프로필을 통한 다중 에이전트 협업
- 재부팅과 호스트 재시작을 살아남아야 하는 워크플로
- 작업을 분별(triage)하기 위한 대시보드를 원하는 인간
몇 개의 임시 헬퍼를 생성하기 위한 단일 실행만 필요하면, 내장된 위임(delegate) 작업 도구가 보통 더 간단합니다.
역사, 대시보드, 에이전트가 자체 호스팅 LLM에 접근하는 방식을 엄격하게 제어해야 할 필요가 생기면, Kanban 보드와 디스패처가 올바른 기반입니다.
몇 가지 설정 조정과 선택적 cron 기반 배칭으로, 게이트웨이와 하드웨어를 보호하면서 Hermes Kanban을 반응적으로 유지할 수 있습니다.
Hermes 스타일 백그라운드 워커가 프로덕션 AI 어시스턴트 아키텍처에 어떻게 적합하게 되는지에 대한 더 넓은 관점 — 스케줄러, 큐 기반 폴링, 프로토콜, 내구성 워크플로, 시맨틱 평가 포함 — 은 AI 어시스턴트에서 폴링 에이전트: 11가지 구현 패턴를 참조하십시오. 여러 이름 붙여진 프로필 또는 전문 에이전트가 단순한 작업 디스패치를 넘어 조정해야 할 때, [다중 에이전트 오케스트레이션 패턴](https://www.glukhov.org/ko/ai-systems/architecture/multi-agent-orchestration-patterns/ “프로덕션 AI 시스템을 위한 6가지 검증된 다중 에이전트 오케스트레이션 패턴: 오케스트레이터-워커, 순차 파이프라인, 팬아웃, 계층형, 스웜, 메시.”})는 자체 호스팅 인프라 위에서 더 큰 다중 에이전트 설정의 기반이 되는 조정 토폴로지 — 허브-스포크, 팬아웃, 스웜 — 를 다룹니다.
