
LLM 시스템 비용 최적화: 비용이 실제로 발생하는 곳
정말 중요한 곳에 토큰을 사용하세요.
LLM 비용은 사용량에 따라 선형적으로 증가합니다. 하루에 10,000건의 요청을 처리하고 요청 건당 0.01달러를 지불하는 시스템의 경우, 일일 비용은 100달러이며 연간으로는 365달러가 됩니다. 엔터프라이즈 규모에서는 이 비용이 10,000달러를 넘습니다.
비용 최적화는 모서리를 깎는 것(절약을 위해 품질을 희생하는 것)이 아닙니다. 중요한 곳에 토큰을 쓰는 것입니다.
버리는 모든 토큰은 더 나은 답변에 사용할 수 있었던 토큰입니다.
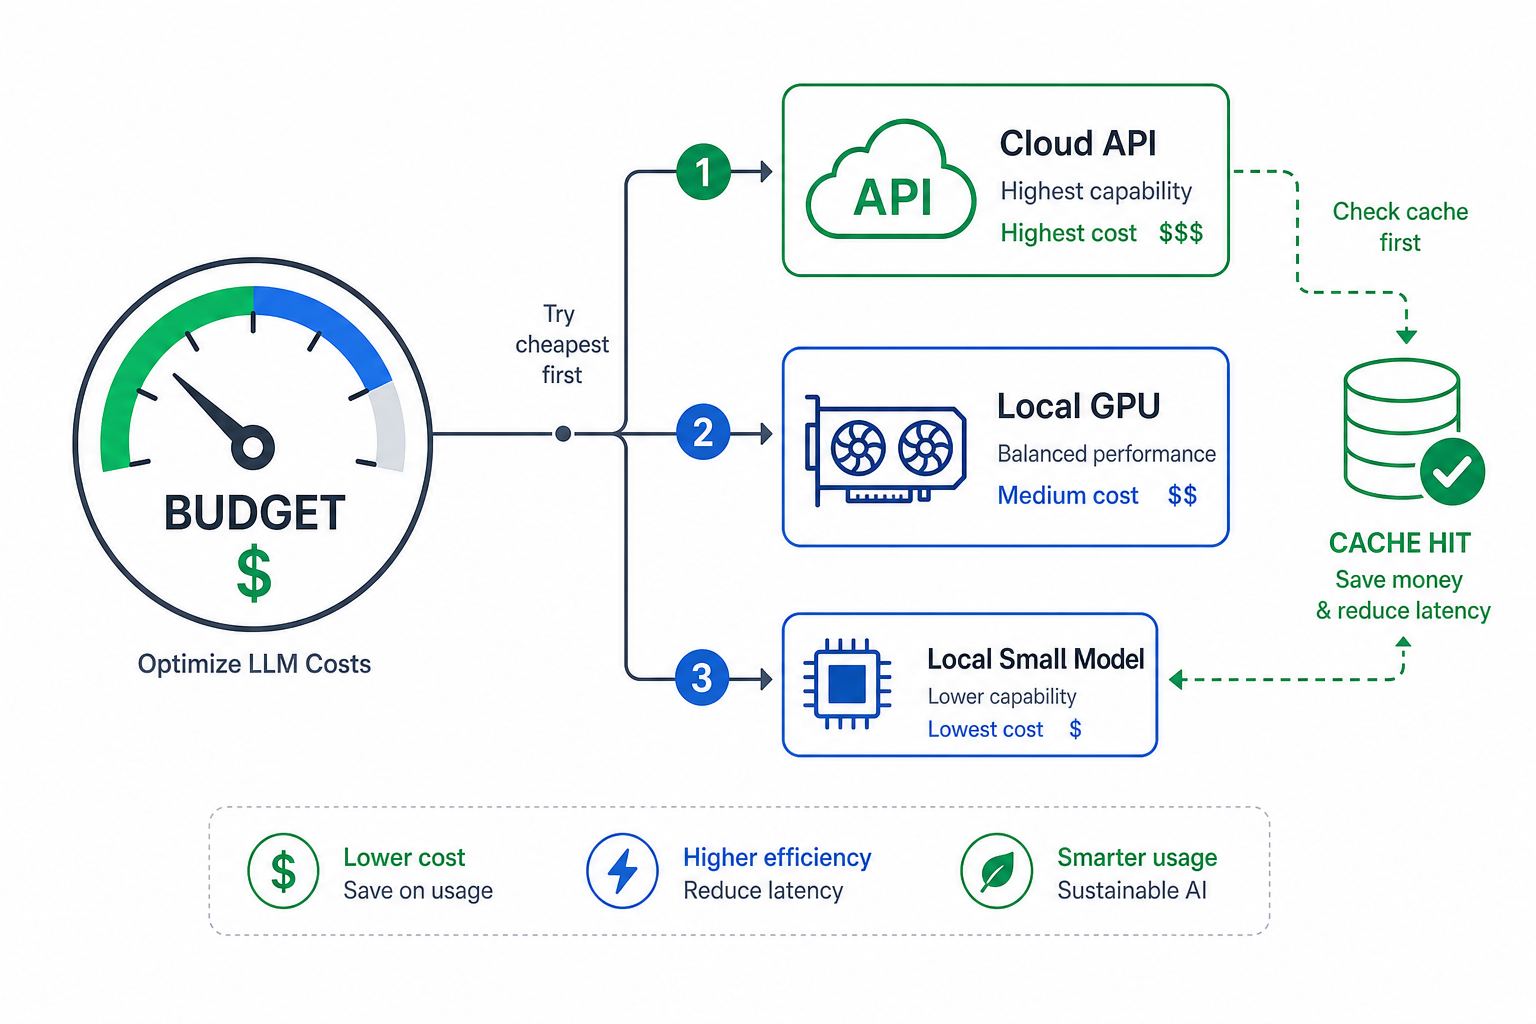
토큰 예산 관리
비용을 통제하는 가장 간단한 방법은 한도를 설정하는 것입니다. 세션당, 태스크당, 또는 하루 기준의 한도가 가능합니다.
전략 1: 세션별 예산
세션별 예산은 직관적입니다:
class SessionBudget:
    def __init__(self, budget_tokens: int = 10000):
        self.budget = budget_tokens
        self.used = 0

    def allocate(self, tokens: int) -> bool:
        if self.used + tokens <= self.budget:
            self.used += tokens
            return True
        return False

    def remaining(self) -> int:
        return self.budget - self.used
전략 2: 태스크별 예산
태스크별 예산은 더 유용합니다. 다양한 태스크는 각기 다른 양의 컨텍스트가 필요합니다:
task_budgets:
  classify:
    max_tokens: 100
    model: qwen3-1.7b
  summarize:
    max_tokens: 500
    model: qwen3-8b
  code_review:
    max_tokens: 2000
    model: qwen2.5-coder-7b
  reason:
    max_tokens: 4000
    model: qwen3-32b
전략 3: 적응형 예산
적응형 예산은 실제 발생 사항에 따라 조정됩니다. 분류 태스크가 일관되게 80개의 토큰을 사용한다면, 100개를 할당하는 것을 중단해야 합니다:
class AdaptiveBudget:
    def __init__(self):
        self.task_history = {}

    def allocate(self, task_type: str) -> int:
        if task_type in self.task_history:
            return int(self.task_history[task_type] * 1.5)
        return 1000

    def record(self, task_type: str, tokens_used: int):
        if task_type not in self.task_history:
            self.task_history[task_type] = tokens_used
        else:
            self.task_history[task_type] = (
                0.9 * self.task_history[task_type] + 0.1 * tokens_used
            )
지수 이동 평균(0.9 가중치)은 최근 사용량이 과거보다 더 중요하다는 것을 의미합니다. 워크로드의 변동성이 얼마나 큰지에 따라 가중치를 조정하세요.
API vs 로컬 추론
대규모 운영에서 로컬 추론은 비용이 더 저렴합니다. 손익분기점은 하드웨어와 API 요금에 따라 달라집니다.
| 모델 | API ($/M 토큰) | 로컬 비용/시간 | 손익분기점 |
|---|---|---|---|
| GPT-4o | $2.50 / $10.00 | — | 해당 없음 |
| Claude Sonnet 4 | $3.00 / $15.00 | — | 해당 없음 |
| Qwen2.5-72B | $0.50 / $2.00 | ~$0.50 | ~하루 4시간 |
| qwen3-32b | $0.30 / $1.20 | ~$0.20 | ~하루 2시간 |
| qwen3-8b | $0.10 / $0.40 | ~$0.05 | ~하루 1시간 |
하드웨어 계산:
| 하드웨어 | 초기 비용 | 월 전기요금 | API 대비 손익분기점 |
|---|---|---|---|
| RTX 3090 (중고) | $600 | $15 | ~4개월 |
| RTX 4090 | $1,500 | $20 | ~6개월 |
| RTX 5080 | $1,000 | $18 | ~5개월 |
| DGX Spark | $2,000 | $30 | ~8개월 |
중간 수준의 사용량(하루 1시간 이상)에서는 로컬 추론이 비용을 회수합니다. 높은 사용량이면 절감 효과는 극적으로 나타납니다. 단점은 초기 자본입니다. RTX 5080은 1,000달러입니다. API 청구서는 일시 정지할 수 있지만, 하드웨어는 그럴 수 없습니다.
이 손익분기점 계산은 언제든 전환할 수 있다고 가정하지만, 이는 종종 하드웨어 비용보다 더 큰 불확실성입니다. 만약 당신의 파인튜닝 데이터, 평가 하네스, 도구 스키마가 이미 특정 제공업체의 API 주위에 구축되어 있다면, 실제 마이그레이션 비용은 이를 풀기 위한 엔지니어링 시간이지, GPU의 가격이 아닙니다. 데이터 중력: API 우선 AI의 실제 비용은 이 잠금(lock-in) 메커니즘을 다루고, 이러한 수치를 실행하기 전에 이미 얼마나 깊이 빠져있는지 평가하기 위한 체크리스트를 제공합니다.
폴백 전략
선호하는 모델이 너무 비싸거나 너무 느릴 때, 더 저렴한 것으로 폴백(fallback)하십시오. 핵심은 품질이 “충분히 좋은” 시점을 아는 것입니다.
전략 1: 품질 기반 폴백
품질 기반 폴백은 출력이 기준을 충족할 때까지 모델을 시도합니다:
class QualityFallback:
    def __init__(self, quality_threshold: float = 0.8):
        self.threshold = quality_threshold
        self.models = [
            {"model": "claude-sonnet-4", "cost": 0.015},
            {"model": "qwen2.5-72b", "cost": 0.002},
            {"model": "qwen3-32b", "cost": 0.001},
            {"model": "qwen3-8b", "cost": 0.0004},
        ]

    def route(self, prompt: str) -> str:
        for model_config in self.models:
            result = self.call_model(model_config["model"], prompt)
            if self.evaluate_quality(result) >= self.threshold:
                return result
        return self.call_model(self.models[0]["model"], prompt)
문제는 평가 자체입니다. 다른 모델을 호출하지 않고 어떻게 품질을 측정할 수 있을까요? 일부 시스템은 작은 분류기를 사용합니다. 다른 시스템은 휴리스틱 검사(길이, 구조, 키워드 존재 여부)를 사용합니다. 이 중 완벽한 것은 없습니다.
전략 2: 지연 시간 기반 폴백
지연 시간 기반 폴백은 더 간단합니다. 시간 예산을 충족하는 가장 빠른 모델로 라우팅합니다:
class LatencyFallback:
    def __init__(self, max_latency: float = 5.0):
        self.max_latency = max_latency
        self.models = [
            {"model": "qwen3-1.7b", "latency": 0.5},
            {"model": "qwen3-8b", "latency": 2.0},
            {"model": "qwen3-32b", "latency": 10.0},
            {"model": "claude-sonnet-4", "latency": 5.0},
        ]

    def route(self, prompt: str) -> str:
        for model_config in sorted(self.models, key=lambda x: x["latency"]):
            if model_config["latency"] <= self.max_latency:
                return self.call_model(model_config["model"], prompt)
        return self.call_model(self.models[0]["model"], prompt)
캐싱
캐싱은 가장 과소평가된 비용 최적화 방법입니다. 동일한 프롬프트는 당신이 생각하는 것보다 훨씬 자주 발생합니다. 분류 요청, FAQ 형태의 쿼리, 반복적인 도구 호출 등이 이에 해당합니다.
전략 1: 프롬프트 캐싱
정확한 프롬프트 캐싱은 간단합니다:
import hashlib

class PromptCache:
    def __init__(self, max_size: int = 1000):
        self.cache = {}
        self.max_size = max_size

    def get(self, prompt: str) -> str | None:
        key = hashlib.sha256(prompt.encode()).hexdigest()
        return self.cache.get(key)

    def set(self, prompt: str, response: str):
        key = hashlib.sha256(prompt.encode()).hexdigest()
        if len(self.cache) >= self.max_size:
            self.cache.pop(next(iter(self.cache)))
        self.cache[key] = response
전략 2: 의미론적 캐싱
의미론적 캐싱은 더 유용합니다. 서로 다르지만 같은 의미를 가진 프롬프트를 포착합니다:
from sentence_transformers import SentenceTransformer

class SemanticCache:
    def __init__(self, similarity_threshold: float = 0.95):
        self.model = SentenceTransformer('all-MiniLM-L6-v2')
        self.cache = {}
        self.threshold = similarity_threshold

    def get(self, prompt: str) -> str | None:
        prompt_embedding = self.model.encode([prompt])[0]
        for cached_prompt, cached_response in self.cache.items():
            cached_embedding = self.model.encode([cached_prompt])[0]
            similarity = self.cosine_similarity(
                prompt_embedding, cached_embedding
            )
            if similarity >= self.threshold:
                return cached_response
        return None

    def set(self, prompt: str, response: str):
        self.cache[prompt] = response
임계값이 중요합니다. 0.95는 공격적입니다 — 매우 유사한 프롬프트만 매치됩니다. 0.85는 더 관대하지만, 잘못된 답변을 반환할 위험이 있습니다. 미스 레이트(miss rate)를 측정하고 조정하세요.
일반적인 쿼리에 대한 응답 캐싱도 가치가 있습니다. 사용자가 “날씨가 어때"나 “지금 몇 시야"를 반복해서 물어본다면, 정확한 프롬프트뿐만 아니라 패턴을 캐싱하세요:
class ResponseCache:
    def __init__(self):
        self.common_queries = {
            "what is the weather": "Check weather API",
            "what is the time": "Check system time",
            "who is the president": "Check current president",
        }

    def get(self, query: str) -> str | None:
        query_lower = query.lower()
        for common_query, response in self.common_queries.items():
            if common_query in query_lower:
                return response
        return None
이는 세련되지 않았지만 작동합니다. 일반적인 쿼리는 일반적이기 때문에 그렇습니다.
최적화가 도움이 되는 경우
고량의 데이터 처리, 혼합 워크로드 운영, 또는 쌓여가는 API 비용을 지불하고 있을 때 최적화는 중요합니다.
프로토타입 단계이거나, 단일 모델을 사용하거나, 소량의 데이터를 처리하고 있을 때는 중요하지 않습니다. 하루 100건의 요청을 수행하는 시스템에 예산 관리, 폴백, 캐싱의 복잡성은 가치가 없습니다.
먼저 기본적인 플로우를 작동하도록 하세요. 청구서가 들어올 때 최적화를 추가하세요.
트레이드오프
| 전략 | 비용 | 품질 | 복잡도 |
|---|---|---|---|
| 최적화 없음 | 가장 높음 | 일관됨 | 가장 낮음 |
| 토큰 예산 관리 | 중간 | 변동 | 중간 |
| 폴백 모델 | 낮음~중간 | 변동 | 중간 |
| 캐싱 | 가장 낮음 | 높음 (캐시 히트 시) | 중간 |
| 하이브리드 | 최적화됨 | 최적화됨 | 가장 높음 |
프로덕션 시스템은 보통 하이브리드 방식을 사용합니다. 세션당 예산을 설정하고, 품질이나 지연 시간에 따라 폴백하며, 가능한 한 많은 것을 캐싱합니다. 복잡성은 실제로 존재하지만, 절감 효과도 실제로 존재합니다.
관련 콘텐츠
- 데이터 중력: API 우선 AI의 실제 비용 — 위의 손익분기점 계산이 셀프호스팅 결정의 절반에 불과한 이유
- 2026년 오픈 모델의 효율적 프론티어 — 손익분기점 뒤의 모델 크기 경제학: 임대 4090 하나 위의 27B 모델과 현재 Sonnet 토큰 가격 비교
- 모델 라우팅 전략 — 기능 기반, 비용 인식, 지연 시간 인식 라우팅
- 실무에서의 LLM 가드레일 — 입력 검증, 출력 필터링, 안전성
- 멀티 모델 시스템 설계 — 다중 모델을 위한 아키텍처
- LLM 아키텍처 — 시스템 설계의 핵심: 라우팅, 비용, 가드레일, 오케스트레이션
