
모델 라우팅: 모든 작업에 하나의 모델만 사용하지 마세요
작업에 맞는 적절한 모델.
70B 파라미터 모델을 200단어짜리 이메일 요약에 사용하는 것은 낭비입니다. 3B 모델을 프로덕션 코드 리뷰에 사용하는 것은 무모합니다. 대부분의 시스템은 이 둘 사이의 어딘가에 위치하며, 바로 여기서 모델 라우팅이 핵심이 됩니다.
작업의 복잡성을 모델의 역량에 맞춰주는 것이 핵심입니다. 트레이드오프는 실재하지만, 절감 효과도 그만큼 큽니다.
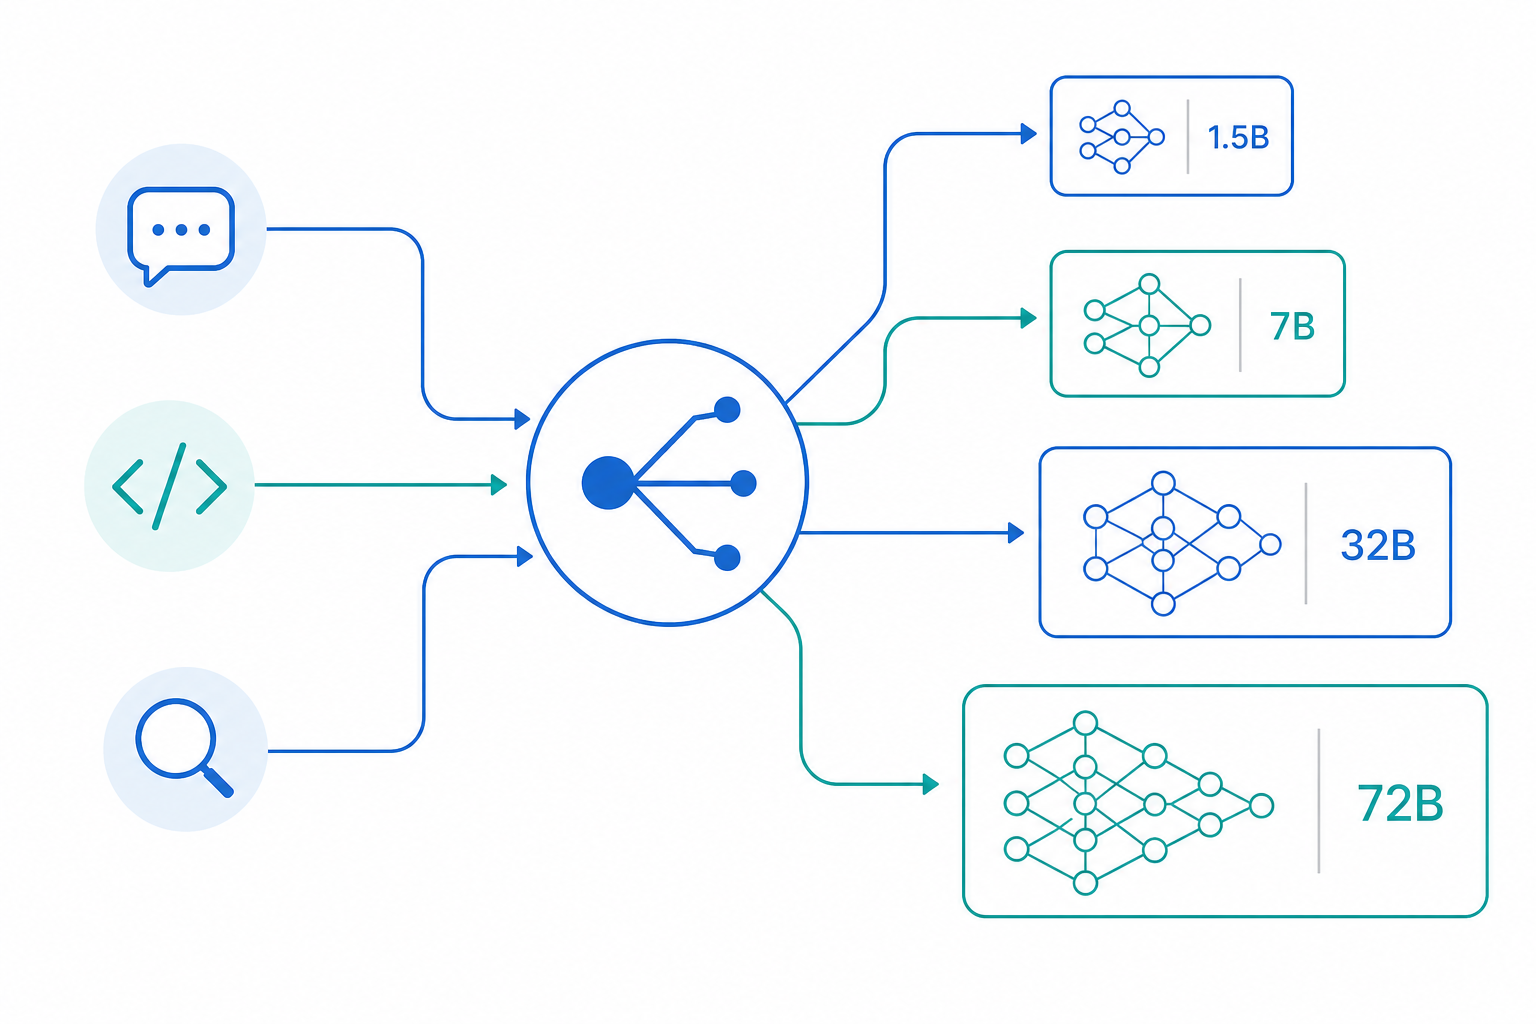
라우팅 문제
보통 사람들은 하나의 모델을 시작해 그대로 유지합니다. 이는 비용이나 지연 시간(또는 둘 다)에 대한 인식이 생기기 전까지는 잘 작동합니다. 대안은 라우터를 구축하는 것입니다. 즉, 어떤 모델이 어떤 요청을 처리할지 결정하는 장치입니다.
실무에서 효과적인 전략은 네 가지입니다:
- 역량 기반 — 모델이 수행할 수 있는 작업에 따라 라우팅
- 비용 인식 — 지출에 동의하는 금액에 따라 라우팅
- 지연 시간 인식 — 얼마나 빠르게 필요한지에 따라 라우팅
- 하이브리드 — 이러한 전략들을 조합
각 전략은 서로 다른 것을 최적화합니다. 하나의 전략을 선택하는 것은 보통 가장 큰 고통을 주는 것이 무엇인지에 대한 결정입니다.
역량 기반 라우팅
가장 단순한 접근법입니다. 작업을 분류하고, 해당 작업을 처리할 수 있는 모델로 전송합니다.
| 작업 | 모델 크기 | 예시 |
|---|---|---|
| 분류, 태깅 | 1-3B | Qwen3-1.7B, Gemma-2-2B |
| 요약, 추출 | 3-7B | Qwen3-8B, Llama-3.1-8B |
| 코드 생성 | 7-14B | Qwen2.5-Coder-7B, DeepSeek-Coder-V2 |
| 복잡한 추론 | 14-32B | Qwen3-32B, Llama-3.1-70B |
| 창의적 작성, 분석 | 32B+ | Qwen2.5-72B, Claude, GPT-4 |
작업에 더 큰 모델이 필요하지 않다면, 사용하지 마세요. 1.5B 모델로 감정 분석을 수행하는 데는 충분합니다. 하지만 일관된 에세이를 작성하지는 못합니다.
구현은 직관적입니다:
ROUTING_RULES = {
    "classify": {"model": "qwen3-1.7B", "max_tokens": 100},
    "summarize": {"model": "qwen3-8B", "max_tokens": 500},
    "code_review": {"model": "qwen2.5-coder-7b", "max_tokens": 2000},
    "reason": {"model": "qwen3-32b", "max_tokens": 4000},
    "creative": {"model": "claude-sonnet-4", "max_tokens": 8000},
}

def route_request(task_type: str) -> dict:
    return ROUTING_RULES.get(task_type, ROUTING_RULES["reason"])
여기서 함정은 분류 자체입니다. 작업 유형을 잘못 판단하면 잘못된 모델로 라우팅됩니다. 코드 리뷰를 ‘요약’으로 잘못 분류하여 품질을 조용히 저하시키는 시스템을 목격한 적이 있습니다.
비용 인식 라우팅
로컬 추론은 여기서 빛을 발합니다. 하드웨어 감가상각 후 로컬 모델은 사실상 무료입니다. RTX 5080은 중간 수준의 API 사용량 기준 약 6개월 만에 투자비를 회수합니다.
| 모델 | 입력 ($/M tokens) | 출력 ($/M tokens) | 로컬 시간당 비용 |
|---|---|---|---|
| GPT-4o | $2.50 | $10.00 | — |
| Claude Sonnet 4 | $3.00 | $15.00 | — |
| Qwen2.5-72B (API) | $0.50 | $2.00 | — |
| Qwen3-32B (로컬) | $0.00 | $0.00 | ~$0.10 |
| Qwen3-8B (로컬) | $0.00 | $0.00 | ~$0.05 |
세션당 수천 개의 요청을 처리한다면, $15/M tokens보다 전기료 $0.05가 더 유리합니다.
예산 기반 라우팅은 지출이 증가함에 따라 단계적으로 변경됩니다:
class CostAwareRouter:
    def __init__(self, budget_per_session: float = 0.10):
        self.budget = budget_per_session
        self.spent = 0.0
        self.models = {
            "cheap": {"model": "qwen3-8B", "cost": 0.0},
            "medium": {"model": "qwen3-32b", "cost": 0.0},
            "expensive": {"model": "claude-sonnet-4", "cost": 0.000015},
        }

    def route(self, task: str) -> str:
        ratio = self.spent / self.budget
        if ratio < 0.5:
            return self.models["expensive"]["model"]
        elif ratio < 0.8:
            return self.models["medium"]["model"]
        return self.models["cheap"]["model"]
단계적으로 변경되면 품질이 저하됩니다. Claude로 시작하여 Qwen3-32B로, 그 다음 Qwen3-8B로 이동하게 됩니다. 긴 세션이 끝날 때쯤 출력은 눈에 띄게 나빠집니다. 이것이 중요한지는 무엇을 구축하고 있는지에 따라 달라집니다.
루틴 트래픽을 로컬 모델로 라우팅하고 API는 예외적인 케이스에만 사용하는 방식은 비용 외에 또 다른 부수적 이점이 있습니다. 모든 파인튜닝과 평가 하네스가 단일 제공사의 API 주변으로 형성되는 데이터 중력 상태로 빠져드는 것을 방지할 수 있습니다.
지연 시간 인식 라우팅
인터랙티브 도구는 빠른 첫 토큰이 필요합니다. 배치 작업은 기다릴 수 있습니다. 그 차이는 보통 모델 크기의 5배 정도입니다.
| 사용 사례 | 첫 토큰 | 완료 | 최대 모델 크기 |
|---|---|---|---|
| 실시간 채팅 | < 200ms | < 2s | < 7B |
| 인터랙티브 도구 | < 500ms | < 5s | < 14B |
| 배치 처리 | < 1s | < 30s | Any |
| 연구/분석 | < 2s | < 60s | Any |
사용자에게 토큰을 스트리밍할 때, 첫 토큰 지연 시간은 사용자가 체감하는 부분입니다. 32B 모델이 시작에 0.5초가 걸리는 것은 즉시 시작되는 1.5B 모델과 비교하면 둔하게 느껴집니다.
class LatencyAwareRouter:
    def __init__(self):
        self.model_latencies = {
            "qwen3-1.7b": {"first_token": 0.05, "complete": 0.5},
            "qwen3-8B": {"first_token": 0.15, "complete": 2.0},
            "qwen3-32b": {"first_token": 0.5, "complete": 10.0},
            "claude-sonnet-4": {"first_token": 0.3, "complete": 5.0},
        }

    def route(self, target_latency: float) -> str:
        for model, latencies in sorted(
            self.model_latencies.items(),
            key=lambda x: x[1]["complete"]
        ):
            if latencies["complete"] <= target_latency:
                return model
        return "qwen3-1.7b"
지연 시간 수치는 대략적인 값입니다. 하드웨어, 양자화, 배치 크기에 따라 달라집니다. 자신의 환경에서 측정해야 합니다.
폴백 전략
모델은 실패할 수 있습니다. API는 레이트 리미팅을 수행하고, 타임아웃은 발생하기 마련입니다. 작동하는 패턴은 최상의 모델에서 가장 신뢰할 수 있는 모델 순서대로 정렬된 폴백 체인입니다:
class FallbackRouter:
    def __init__(self):
        self.fallback_chain = [
            {"model": "claude-sonnet-4", "timeout": 30},
            {"model": "qwen2.5-72b", "timeout": 60},
            {"model": "qwen3-32b", "timeout": 120},
            {"model": "qwen3-8b", "timeout": 300},
        ]

    def route_with_fallback(self, prompt: str) -> str:
        for config in self.fallback_chain:
            try:
                return self.call_model(
                    config["model"], prompt,
                    timeout=config["timeout"]
                )
            except (TimeoutError, APIError) as e:
                log.warning(f"Model {config['model']} failed: {e}")
                continue
        raise RuntimeError("All fallback models failed")
체인 마지막 모델은 로컬 모델이어야 합니다. 느릴 수는 있지만, 네트워크 문제나 API 키 오류로 인해 실패하지는 않습니다.
라우팅이 도움이 되는 시점
라우팅은 워크로드가 혼합되어 있을 때 의미를 가집니다. 같은 시스템에서 분류, 요약, 추론을 모두 수행한다면, 라우터는 비용과 지연 시간을 절감해 줍니다.
수행하는 모든 작업의 복잡성이 동일할 때는 의미가 없습니다. 해당 작업에 능한 모델을 사용하면 됩니다. 라우터는 불필요한 복잡성을 추가할 뿐입니다.
초기 프로토타이핑 단계에서도 라우팅을 건너뛰어야 하는 또 다른 이유입니다. 먼저 하나의 모델로 작업을 동작하게 만든 다음, 비용이나 지연 시간이 실제로 문제가 될 때 라우팅을 추가하세요.
트레이드오프
모든 라우팅 전략은 무언가를 최적화하는 대신 다른 무언가를 희생합니다:
- 단일 모델 — 가장 단순, 가장 비쌈, 일관된 품질
- 역량 기반 — 비용 효율성 향상, 작업당 높은 품질, 중간 수준의 복잡성
- 비용 인식 — 가장 저렴, 품질 변동, 중간 수준의 복잡성
- 지연 시간 인식 — 가장 빠름, 품질 희생 가능, 중간 수준의 복잡성
- 하이브리드 — 최고의 균형, 구현 가장 복잡
프로덕션 시스템은 보통 하이브리드로 수렴합니다. 역량 기반 라우팅으로 시작하고, 비용이 청구서로 나타날 때 비용 인식을 추가하며, 사용자가 느림에 대해 불평할 때 지연 시간 인식을 추가합니다.
관련 문서
- LLM 시스템 비용 최적화 — 토큰 예산 관리, 캐싱, 폴백 모델
- 실무에서의 LLM 가드레일 — 입력 검증, 출력 필터링, 안전성
- 멀티 모델 시스템 설계 — 다중 모델 아키텍처
- Decision LLM: 모델이 결정해야 할 때와 결정하지 말아야 할 때 — 계층 선택 뒤의 결정 역할 분류법, 신뢰도 기반 에스컬레이션
- LLM 아키텍처 — 시스템 설계 핵심 요소: 라우팅, 비용, 가드레일, 오케스트레이션
