
Problemas de salida estructurada de Ollama GPT-OSS
No muy agradable.
Los modelos GPT-OSS de Ollama tienen problemas recurrentes al manejar salidas estructuradas, especialmente cuando se usan con marcos como LangChain, OpenAI SDK, vllm y otros.
No muy agradable.
Los modelos GPT-OSS de Ollama tienen problemas recurrentes al manejar salidas estructuradas, especialmente cuando se usan con marcos como LangChain, OpenAI SDK, vllm y otros.
Un par de formas de obtener una salida estructurada de Ollama
Modelos de Lenguaje a Gran Escala (LLM) son poderosos, pero en producción rara vez deseamos párrafos de formato libre. En cambio, queremos datos predecibles: atributos, hechos u objetos estructurados que puedes proporcionar a una aplicación. Eso es la Salida estructurada de LLM.
Mi propia prueba de programación del modelo ollama
Aquí estoy comparando cómo mucho VRAM la nueva versión de Ollama asigna al modelo con la versión anterior de Ollama. La nueva versión es peor.
Mi perspectiva sobre el estado actual del desarrollo de Ollama
Ollama se ha convertido rápidamente en una de las herramientas más populares para ejecutar LLMs localmente. Su simple CLI y la gestión de modelos simplificada lo han convertido en una opción predilecta para los desarrolladores que desean trabajar con modelos de IA fuera de la nube.
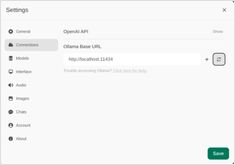
Breve visión general de las interfaces de usuario más destacadas para Ollama en 2025
Locally hosted Ollama permite ejecutar modelos de lenguaje grandes en tu propia máquina, pero usarlo desde la línea de comandos no es muy amigable para el usuario. Aquí hay varios proyectos de código abierto que ofrecen interfaces estilo ChatGPT que se conectan a un Ollama local.
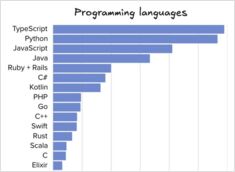
Comparación de herramientas y lenguajes de ingeniería de software
La carta de The Pragmatic Engineer publicada hace unos días presentó estadísticas de una encuesta sobre la popularidad de lenguajes de programación, IDEs, herramientas de IA y otros datos para mediados de 2025.
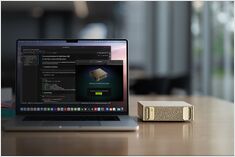
En julio de 2025, pronto estará disponible.
Nvidia está a punto de lanzar NVIDIA DGX Spark, un pequeño superordenador de IA basado en la arquitectura Blackwell, con más de 128 GB de memoria unificada y un rendimiento de IA de 1 PFLOPS. Un dispositivo excelente para ejecutar LLMs.
¿Implementando RAG? Aquí tienes algunos fragmentos de código en Go - 2...
Dado que Ollama estándar no tiene una API de reranking directa, necesitará implementar reranking usando Qwen3 Reranker en GO generando embeddings para pares de consulta-documento y puntuándolos.

Hace bastante tiempo entrené un detector de objetos AI
Un frío día de invierno en julio… que es en Australia… sentí la urgente necesidad de entrenar un modelo de IA para detectar barras de refuerzo de concreto sin tapones…
qwen3 8b, 14b y 30b, devstral 24b, mistral small 24b
En este test estoy comparando cómo diferentes LLMs alojados en Ollama traducen una página Hugo en inglés al alemán.
¿Implementando RAG? Aquí tienes algunos fragmentos de código en Golang.
Este pequeño ejemplo de código Go para reranking que llama a Ollama para generar embeddings se utiliza para la consulta y para cada documento candidato, y luego ordena de forma descendente por similitud coseno.
¿Estás pensando en instalar una segunda GPU para LLMs?
¿Cómo afectan las pistas PCIe al rendimiento de los LLM?? Depende de la tarea. En el entrenamiento y la inferencia con múltiples GPUs, la caída de rendimiento es significativa.
LLM para extraer texto de HTML...
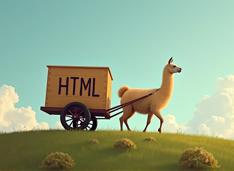
En la biblioteca de modelos de Ollama hay modelos que pueden convertir contenido HTML a Markdown, lo cual es útil para tareas de conversión de contenido. Esta guía forma parte de nuestro Herramientas de Documentación en 2026: Markdown, LaTeX, PDF y Flujos de Trabajo de Impresión hub.
¿Qué modo de investigación de IA se adapta a su tarea?
Cursor AI vs GitHub Copilot vs Cline AI vs...
Aquí se listará algunas herramientas de codificación asistida por IA y Asistentes de Codificación con IA y sus ventajas.
Lista breve de proveedores de LLM
El uso de LLMs no es muy costoso, podría no haber necesidad de comprar una nueva GPU impresionante. Aquí hay una lista si proveedores de LLM en la nube con LLMs que alojan.