AI

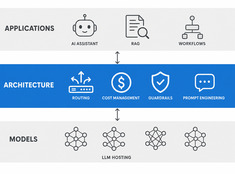
Gravité des données : Le vrai coût des IA API-first

Gravité des données : Le vrai coût des IA API-first

Pourquoi votre pile d’IA devient de plus en plus collante chaque mois.

Chaque appel API ressemble à une simple transaction – jusqu’au moment où ils s’accumulent au point que vos données de fine-tuning, vos harnais d’évaluation et vos schémas d’outils sont tous façonnés autour d’un seul fournisseur, et que le changement ne consiste plus en une simple modification de routage.

Ollama vers vLLM : quand migrer votre serveur de LLM local

Ollama vers vLLM : quand migrer votre serveur de LLM local

« Quand passer d’Ollama à vLLM »

Ollama est l’une des méthodes les plus simples pour exécuter un modèle de langage local, mais la praticité peut masquer le moment où une expérience locale se transforme en service de déduction partagé nécessitant une meilleure planification et une meilleure observabilité.

GPU pour l’IA en 2026 : NVIDIA, AMD et Intel comparés

GPU pour l’IA en 2026 : NVIDIA, AMD et Intel comparés

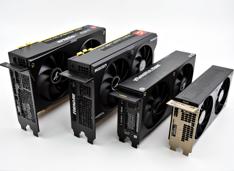
Comparaison des GPU IA entre trois fournisseurs

Le paysage du matériel pour l’IA a considérablement évolué en 2026, avec NVIDIA, AMD et Intel qui rivalisent tous pour attirer les développeurs ayant besoin de GPU capables d’exécuter localement de grands modèles de langage (LLM) et des charges de travail d’inférence IA.

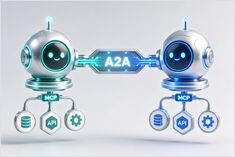
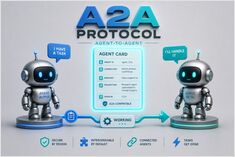
Sécurité des agents A2A et MCP : identité, délégation et traçabilité

Sécurité des agents A2A et MCP : identité, délégation et traçabilité

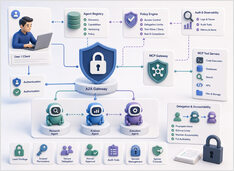
La sécurité du protocole concerne qui peut agir, non le modèle.

L’injection de prompt attire la majeure partie de l’attention en matière de sécurité dans les systèmes de LLM, et cela est justifié, mais ce n’est pas le seul problème une fois que les agents commencent à utiliser des outils et à déléguer du travail à d’autres agents.

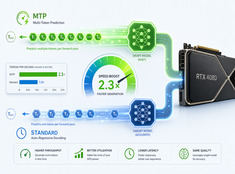
Décodage spéculatif : inférence LLM 20 à 50 % plus rapide

Décodage spéculatif : inférence LLM 20 à 50 % plus rapide

Inférence LLM plus rapide sans perte de qualité : un guide pratique

Un modèle de 70B génère un jeton par passe avant, et chaque passe recharge les poids depuis la VRAM, calcule l’attention sur l’ensemble du contexte et synchronise la mémoire. Entre les jetons, le GPU reste inactif pendant qu’il attend la résolution des dépendances séquentielles.