Llm

Go pour l’orchestration d’IA/ML

Go pour l’orchestration d’IA/ML

Construisez des pipelines IA/ML robustes avec des microservices Go

À mesure que les charges de travail d’IA et de l’apprentissage automatique (ML) deviennent de plus en plus complexes, le besoin de systèmes d’orchestration robustes s’est accru. La simplicité, la performance et la concurrence de Go en font un choix idéal pour construire la couche d’orchestration des pipelines ML, même lorsque les modèles eux-mêmes sont écrits en Python.
Infrastructure IA sur du matériel grand public

Infrastructure IA sur du matériel grand public

Déployez une IA d'entreprise sur du matériel abordable avec des modèles ouverts.

La démocratisation de l’IA est arrivée. Avec des LLM open-source comme Llama, Mistral et Qwen qui rivalisent désormais avec les modèles propriétaires, les équipes peuvent construire une puissante infrastructure IA utilisant du matériel grand public - réduisant les coûts tout en conservant un contrôle total sur la confidentialité des données et le déploiement.

Exécuter FLUX.1-dev GGUF Q8 en Python

Exécuter FLUX.1-dev GGUF Q8 en Python

Accélérer FLUX.1-dev avec la quantification GGUF

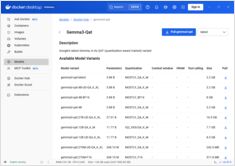
FLUX.1-dev est un modèle puissant de génération d’images à partir de texte qui produit des résultats impressionnants, mais sa demande en mémoire de 24 Go ou plus le rend difficile à exécuter sur de nombreux systèmes. Quantification GGUF de FLUX.1-dev offre une solution, réduisant l’utilisation de la mémoire d’environ 50 % tout en maintenant une excellente qualité d’image.

NVIDIA DGX Spark vs Mac Studio vs RTX-4080 : Comparaison des performances d'Ollama

NVIDIA DGX Spark vs Mac Studio vs RTX-4080 : Comparaison des performances d'Ollama

Benchmarks GPT-OSS 120b sur trois plateformes d'IA

J’ai découvert des tests de performance intéressants sur l’exécution du modèle GPT-OSS 120b avec Ollama sur trois plateformes différentes : NVIDIA DGX Spark, Mac Studio, et RTX 4080. Le modèle GPT-OSS 120b de la bibliothèque Ollama pèse 65 Go, ce qui signifie qu’il ne peut pas s’exécuter dans les 16 Go de VRAM d’un RTX 4080 (ou sur le plus récent RTX 5080).

Convertir HTML en Markdown avec Python : Un guide complet

Convertir HTML en Markdown avec Python : Un guide complet

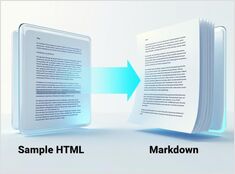
Python pour convertir HTML en Markdown propre et prêt à l'usage avec un LLM

Conversion de HTML en Markdown est une tâche fondamentale dans les workflows de développement modernes, particulièrement lors de la préparation du contenu web pour les grands modèles de langage (LLM), les systèmes de documentation ou les générateurs de sites statiques comme Hugo. Ce guide fait partie de notre Outils de Documentation en 2026 : Markdown, LaTeX, PDF et workflows d’impression hub.

PUAS pour LLM et puces d’inférence spécialisées (leur importance)

PUAS pour LLM et puces d’inférence spécialisées (leur importance)

Les ASIC et le silicium sur mesure boostent la vitesse et l’efficacité de l’inférence des LLM

L’avenir de l’IA ne concerne pas uniquement des modèles plus intelligents. Il s’agit également de la silice qui correspond à la manière dont ces modèles sont réellement servis. Le matériel spécialisé pour l’inférence LLM suit un chemin rappelant la transition du minage de Bitcoin des GPU vers les ASIC dédiés, avec des contraintes plus rigoureuses car les modèles et les recettes de précision continuent d’évoluer.

DGX Spark vs. Mac Studio : analyse détaillée des prix du supercalculateur personnel IA de NVIDIA

DGX Spark vs. Mac Studio : analyse détaillée des prix du supercalculateur personnel IA de NVIDIA

Disponibilité, prix de détail réels dans six pays et comparaison avec le Mac Studio.

NVIDIA DGX Spark est bien réel, en vente à partir du 15/10/2025, et destiné aux développeurs CUDA ayant besoin de travailler sur des LLM locaux avec un NVIDIA AI stack intégré. Le PPU aux États-Unis est de 3 999 $ ; le prix de détail en Royaume-Uni/Allemagne/Japon est plus élevé en raison de la TVA et des coûts de distribution. Les prix publics en AUD/KRW ne sont pas encore largement affichés.