Faites la connaissance de Sisyphus et de son équipe d'agents spécialisés.
Le saut de capacité le plus important dans OpenCode provient des agents spécialisés : séparation délibérée de l’orchestration, de la planification, de l’exécution et de la recherche.
Installez Oh My Opencode et publiez plus rapidement.
Oh My Opencode transforme OpenCode en un harnais de codage multi-agents : un orchestrateur délègue le travail à des agents spécialisés qui s’exécutent en parallèle.
Test LLM OpenCode — statistiques de codage et de précision
J’ai testé comment OpenCode fonctionne avec plusieurs LLM hébergés localement sur Ollama et llama.cpp, et j’ai ajouté pour comparaison quelques modèles gratuits provenant d’OpenCode Zen.
Démarrage rapide d'OpenHands CLI en quelques minutes
OpenHands est une plateforme open-source et agnostique des modèles pour les agents de développement logiciel pilotés par l’IA.
Il permet à un agent de se comporter davantage comme un partenaire de codage que comme un simple outil de complétion automatique.
Hébergez des APIs compatibles avec OpenAI en local avec LocalAI en quelques minutes.
LocalAI est un serveur d’inférence auto-hébergé, conçu en priorité pour une utilisation locale, qui se comporte comme une API OpenAI de remplacement pour exécuter des charges de travail d’IA sur votre propre matériel (ordinateur portable, station de travail ou serveur sur site).
L’inférence LLM ressemble à « une API comme les autres » — jusqu’à ce que les pics de latence apparaissent, les files d’attente s’allongent et que vos GPU atteignent 95 % de mémoire sans explication évidente.
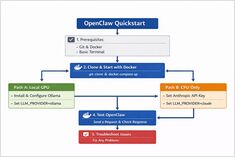
OpenClaw est un assistant IA auto-hébergé conçu pour fonctionner avec des runtime de LLM locaux comme Ollama ou avec des modèles cloud tels que Claude Sonnet.
« AWS S3, Garage ou MinIO – aperçu et comparaison. »
AWS S3 reste le standard de référence pour le stockage d’objets : entièrement géré, fortement cohérent et conçu pour une durabilité et une disponibilité extrêmement élevées. Garage et MinIO sont des alternatives auto-hébergées compatibles S3 : Garage est conçu pour des clusters petits à moyens, légers et géo-répartis, tandis que MinIO met l’accent sur une couverture large des fonctionnalités de l’API S3 et sur les hautes performances dans les déploiements plus importants.
Garage est un système de stockage objet open source, auto-hébergé et compatible S3 conçu pour les déploiements de petite à moyenne envergure, avec une forte emphasis sur la résilience et la géodistribution.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Contrôlez vos données et modèles avec des LLM auto-hébergés
L’auto-hébergement des LLMs permet de garder les données, les modèles et l’inférence sous votre contrôle, ouvrant ainsi une voie pratique vers la souveraineté de l’IA pour les équipes, les entreprises et les nations.
Test de vitesse d'un LLM sur une RTX 4080 avec 16 Go de VRAM
L’exécution de grands modèles de langage en local vous offre confidentialité, capacité hors ligne et zéro coût API.
Ce benchmark révèle exactement ce que l’on peut attendre de 14 modèles
LLM sur Ollama avec une RTX 4080.
L’écosystème Go continue de prospérer avec des projets innovants couvrant l’outillage IA, les applications auto-hébergées et l’infrastructure développeur. Ce panorama analyse les dépôts Go les plus tendance sur GitHub ce mois-ci.
Vérification des prix des GPU et RAM en janvier 2025
Aujourd’hui, nous examinons les GPU grand public haut de gamme et les modules de RAM. Plus précisément, j’étudie les prix des RTX-5080 et RTX-5090, ainsi que les modules de 32GB (2x16GB) DDR5 6000.
vLLM est un moteur d’inférence et de service à haut débit et économe en mémoire pour les modèles de langage de grande taille (LLM), développé par le laboratoire Sky Computing de l’Université de Californie à Berkeley.