
Claude, OpenClaw e la fine della tariffa fissa per gli agenti
Gli abbonamenti a Claude non alimentano più gli agenti
La falla silenziosa che ha alimentato un’onda di sperimentazione con gli agenti è ora chiusa.
Gli abbonamenti a Claude non alimentano più gli agenti
La falla silenziosa che ha alimentato un’onda di sperimentazione con gli agenti è ora chiusa.
Ricerca AI self-hosted con LLM locali
Vane è una delle opzioni più pragmatiche nell’ambito della “ricerca AI con citazioni”: un motore di risposta self-hosted che combina il recupero live dal web con LLM locali o cloud, mantenendo l’intero stack sotto il vostro controllo.
Coding agentico, ora con backend di modelli locali.
Claude Code non è un’autocompletamento con un marketing migliore. È uno strumento di coding agentic: legge la tua codebase, modifica i file, esegue comandi e si integra con i tuoi strumenti di sviluppo.
Installazione e avvio rapido di Hermes Agent per gli sviluppatori
Hermes Agent è un assistente AI self-hosted e indipendente dal modello che funziona su una macchina locale o su un VPS a basso costo, opera attraverso interfacce terminali e di messaggistica e migliora nel tempo trasformando i compiti ripetitivi in abilità riutilizzabili.
Installa TGI, rilascia velocemente, debugga più rapidamente.
Text Generation Inference (TGI) ha un’energia molto specifica. Non è il più nuovo arrivato nella strada dell’inferenza, ma è quello che ha già imparato come la produzione si rompe -
Velocità dei token di llama.cpp su 16 GB di VRAM (tabelle).
Qui sto confrontando la velocità di diversi LLM eseguiti su una GPU con 16 GB di VRAM, per scegliere quello migliore per l’auto-hospitng.
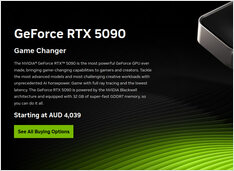
La RTX 5090 in Australia è scarsa e sopravvalutata.
L’Australia ha scorte di RTX 5090. A malapena. E se ne trovate una, pagherete un sovrapprezzo che sembra distaccato dalla realtà.
Accesso remoto a Ollama senza porte pubbliche
Ollama è al suo meglio quando viene trattato come un demone locale: la CLI e le tue applicazioni comunicano con un’API HTTP su loopback, e il resto della rete non viene a sapere della sua esistenza.
Server Ollama con priorità alla configurazione, GPU e persistenza.
Ollama funziona egregiamente su hardware nativo. Diventa ancora più interessante quando lo si tratta come un servizio: un endpoint stabile, versioni bloccate, storage persistente e una GPU che o è disponibile o non lo è.
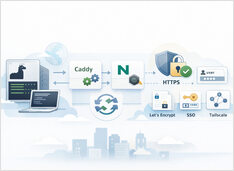
HTTPS per Ollama senza interrompere le risposte in streaming.
Eseguire Ollama dietro un proxy inverso è il modo più semplice per ottenere HTTPS, un controllo degli accessi opzionale e un comportamento di streaming prevedibile.
Embedding RAG - Python, Ollama, API OpenAI.
Se stai approfondendo la generazione potenziata dal recupero (RAG), questa sezione illustra le embeddings testuali in termini semplici: cosa sono, come si integrano nella ricerca e nel recupero, e come invocare due configurazioni locali comuni da Python utilizzando Ollama o un’API HTTP compatibile con OpenAI (come espongono molti server basati su llama.cpp).
Servire modelli open-source rapidamente con SGLang.
SGLang è un framework di serving ad alte prestazioni per grandi modelli linguistici e modelli multimodali, progettato per fornire inferenza a bassa latenza e alto throughput in tutto, da una singola GPU a cluster distribuiti.
Hot-swap dei LLM locali senza modificare i client.
Presto ti ritroverai a gestire vLLM, llama.cpp e altri componenti, ognuno su una porta propria. Tutta l’infrastruttura a valle richiede comunque un unico /v1 come base URL; altrimenti continuerai a riordinare porte, profili e script one-off. llama-swap è il proxy /v1 da posizionare davanti a quegli stack.
La maggior parte delle configurazioni di AI locali parte da un modello e da un runtime.
Cosa accade effettivamente quando esegui Ultrawork.
Oh My Opencode promette un “team virtuale di sviluppatori AI” — Sisyphus che orchestra specialisti, compiti eseguiti in parallelo e la magica parola chiave ultrawork che attiva tutto.
Conoscete Sisyphus e il suo team di agenti specialisti.
Il salto di capacità più significativo in OpenCode deriva dagli agenti specializzati: una separazione deliberata tra orchestrazione, pianificazione, esecuzione e ricerca.