Ollama
Wydajność LLM w 2026 roku: benchmarki, wąskie gardła i optymalizacja
Samodzielny hosting modeli LLM i suwerenność w zakresie sztucznej inteligencji
Kontroluj dane i modele za pomocą własnych, lokalnie hostowanych LLM
Hositing własny LLM daje kontrolę nad danymi, modelami i wnioskowaniem – jest to praktyczna droga do sukwerenności AI dla zespołów, przedsiębiorstw i krajów.
Porównanie wydajności LLM na Ollama z GPU o 16 GB VRAM
Test prędkości LLM na RTX 4080 z 16 GB VRAM
Uruchamianie dużych modeli językowych lokalnie zapewnia prywatność, możliwość pracy offline i zerowe koszty API. Ten benchmark dokładnie pokazuje, czego można oczekiwać od 14 popularnych LLM na Ollama na karcie RTX 4080.
Najpopularniejsze 19 projektów w Go na GitHubie
Popularne repozytoria Go w październiku 2026
Ekosystem Go nadal dynamicznie się rozwija, a tymiesięczny ranking najpopularniejszych projektów jest zdominowany przez infrastrukturę agentów AI. Niniejszy przegląd analizuje najpopularniejsze repozytoria Go na GitHubie w tym miesiącu.
Open WebUI: interfejs LLM do samodzielnej hostowania
Self-hostowana alternatywa dla ChatGPT dla lokalnych LLM-ów
Open WebUI to potężna, rozszerzalna i bogata w funkcje, samodzielnie hostowana przeglądarkowa aplikacja do interakcji z dużymi modelami językowymi.
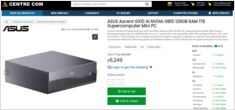
Ceny DGX Spark AU w głównych sklepach: 6 249–7 999 USD.
Prawdziwe ceny w AUD od australijskich sprzedawców już teraz.
NVIDIA DGX Spark](https://www.glukhov.org/pl/hardware/ai/nvidia-dgx-spark/ “NVIDIA DGX Spark - mały superkomputer AI”) (GB10 Grace Blackwell) jest dostępny w Australii w głównych sklepach z komputerami, z miejscowym zapasem. Jeśli śledzicie ceny i dostępność DGX Spark na świecie, zainteresuje Was zapewne, że ceny w Australii wahają się od 6 249 do 7 999 AUD w zależności od konfiguracji pamięci masowej i sprzedawcy.
Autonomiczne hostowanie Cognee: Wybór LLM na Ollama
Testowanie Cognee z lokalnymi modelami LLM - rzeczywiste wyniki
Cognee to framework w Pythonie do budowania grafów wiedzy z dokumentów za pomocą LLM. Ale działa on z modelami samozhostowanymi?
BAML vs Instructor: strukturyzowane wyjścia LLM
Bezpieczne typowo wyjścia LLM z BAML i Instructor
Pracując z dużymi modelami językowymi (LLM) w środowisku produkcyjnym, kluczowe jest uzyskiwanie ustrukturyzowanych wyjść bezpiecznych typowo.
Dwa popularne frameworki – BAML i Instructor – stosują różne podejścia do rozwiązania tego problemu.
Wybór odpowiedniego LLM dla Cognee: lokalna konfiguracja Ollama
Refleksje nad LLM dla samowystarczalnego Cognee
Wybór najlepszego LLM dla Cognee wymaga zrównoważenia jakości budowania grafów, poziomu halucynacji i ograniczeń sprzętowych.
Cognee wyróżnia się w przypadku większych modeli o niskim poziomie halucynacji (32B+) poprzez Ollama, jednak opcje o średnich parametrach są odpowiednie dla prostszych konfiguracji.
Wykorzystanie API wyszukiwania web Ollama w Pythonie
Buduj agenty AI do wyszukiwania w Pythonie i Ollamie
Biblioteka Python Ollama zawiera obecnie natywne możliwości przeszukiwania sieci za pomocą Ollama. Wystarczy kilka linii kodu, aby wzbogacić Twoje lokalne modele LLM o bieżące informacje z sieci, co zmniejsza halucynacje i poprawia dokładność.
Wykorzystanie API Ollama Web Search w Go
Twórz agentów wyszukiwania AI z użyciem Go i Ollama
API wyszukiwania w internecie Ollama umożliwia wzbogacanie lokalnych modeli LLM o bieżące informacje z sieci. Ten przewodnik pokazuje, jak zaimplementować możliwości wyszukiwania w internecie w Go, od prostych wywołań API po w pełni rozbudowanych agentów wyszukiwania.
Ollama a vLLM, a LM Studio: najlepszy sposób na uruchamianie LLM lokalnie w 2026 roku?
Porównanie najlepszych narzędzi do lokalnego hostingu LLM w 2026 roku. Dojrzałość API, obsługa sprzętu, wywoływanie narzędzi oraz zastosowania w praktyce.
Lokalne uruchamianie LLM jest obecnie praktyczne dla deweloperów, startupów, a nawet zespołów korporacyjnych.
Ale wybór odpowiedniego narzędzia — Ollama, vLLM, LM Studio, LocalAI lub innego — zależy od Twoich celów:
Infrastruktura sztucznej inteligencji na sprzęcie konsumenckim
Wdrażanie przedsiębiorstwowej sztucznej inteligencji na budżetowym sprzęcie przy użyciu modeli open-source.
Demokratyzacja sztucznej inteligencji jest tuż przed nami. Dzięki otwartym modelom LLM takim jak Llama, Mistral i Qwen, które dorównują już modelom własnościowym, zespoły mogą budować potężną infrastrukturę AI na sprzęcie konsumenckim – drastycznie obniżając koszty, jednocześnie zachowując pełną kontrolę nad prywatnością danych i wdrożeniem.
NVIDIA DGX Spark vs Mac Studio vs RTX-4080: Porównanie wydajności Ollama
Wyniki testów GPT-OSS 120b na trzech platformach AI
Znalazłem pewne ciekawe testy wydajności GPT-OSS 120b działającego na Ollama na trzech różnych platformach: NVIDIA DGX Spark, Mac Studio, i RTX 4080. Model GPT-OSS 120b z biblioteki Ollama waży 65 GB, co oznacza, że nie mieści się w 16 GB VRAM na RTX 4080 (ani w nowszej RTX 5080).
Docker Model Runner vs Ollama (2026): Który jest lepszy do lokalnych modeli LLM?
Porównaj Docker Model Runner i Ollama w kontekście lokalnych modeli LLM
Uruchamianie dużych modeli językowych (LLM) lokalnie staje się coraz bardziej popularne ze względu na prywatność, kontrolę kosztów i możliwości offline. Landscape zmienił się znacząco w kwietniu 2025 roku, gdy Docker wprowadził Docker Model Runner (DMR), oficjalne rozwiązanie do wdrażania modeli AI.