
Protocolo A2A do Google em 2026: Adoção, Hype e Realidade
A2A não está morto. Apenas não é universal.
O protocolo Agent2Agent da Google, geralmente abreviado para A2A, teve um primeiro ano estranho.
A2A não está morto. Apenas não é universal.
O protocolo Agent2Agent da Google, geralmente abreviado para A2A, teve um primeiro ano estranho.
Padrões confiáveis de polling para agentes de IA.
Os agentes de polling (verificação periódica) são uma das partes menos glamourosas da arquitetura de assistentes de IA, mas também são uma das mais úteis.
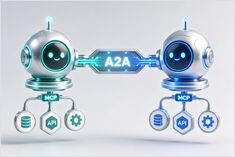
MCP fornece ferramentas para agentes. A2A fornece pares para agentes.
A arquitetura de agentes de IA está começando a se dividir em duas camadas.
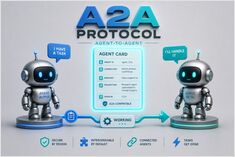
O A2A transforma agentes em pares de rede.
O Protocolo A2A, sigla para Agent2Agent Protocol (Protocolo Agente para Agente), é um padrão aberto para comunicação entre sistemas independentes de agentes de IA.
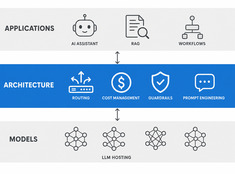
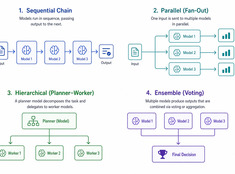
Escolha o padrão mais simples que funcione.
Sistemas de modelo único são simples. Sistemas mult模型 são poderosos. O desafio não está em escolher os modelos — está em projetar a arquitetura que os orquestra.
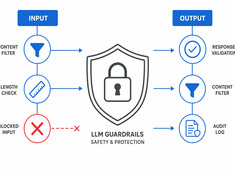
Controle o risco, não apenas o modelo.
Os LLMs são imprevisíveis. Eles alucinam, vazam dados, geram conteúdo prejudicial ou recusam solicitações legítimas. As barreiras de segurança (guardrails) restringem o comportamento do modelo sem sacrificar a capacidade.
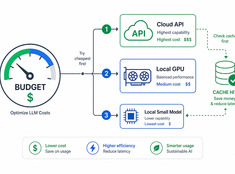
Gaste tokens onde eles realmente importam.
Os custos de LLMs aumentam linearmente com o uso. Um sistema que processa 10.000 requisições por dia a $0,01 por requisição custa $100 por dia — $365 por ano. Em escala empresarial, isso ultrapassa $10.000.
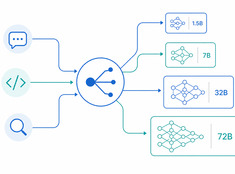
O modelo certo para a tarefa certa.
Executar um modelo com 70 bilhões de parâmetros para resumir um e-mail de 200 palavras é um desperdício. Executar um modelo de 3 bilhões para revisar código de produção é imprudência. A maioria dos sistemas vive em algum ponto intermediário — e é exatamente aí que entra o roteamento de modelos.
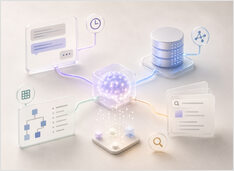
Memória de trabalho, estruturada e de recuperação para assistentes.
A memória transforma assistentes de reativos para persistentes, mas também é onde muitos sistemas se deterioram silenciosamente. Pesquisas argumentam que a divisão entre memória de curto e longo prazo já não é suficiente para a memória de agentes modernos; os SDKs da OpenAI e LangGraph apontam para uma pilha mais simples — memória de trabalho, estado durável e recuperação (retrieval).
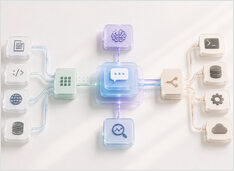
Como assistentes realmente sérios são construídos.
Um assistente de IA de produção não é “um LLM com um prompt”. É um sistema que aceita intenção, mantém estado, decide quando recuperar ou agir e expõe detalhes suficientes em tempo de execução para depurar falhas.
A IA transforma a gestão do conhecimento, não o seu propósito.
A IA não está substituindo a gestão do conhecimento; está mudando a forma dela tanto para indivíduos quanto para equipes.
Estrelas, tokens, downloads — quem realmente vence?
Os frameworks de agentes de IA de código aberto estão explodindo em popularidade no GitHub. Dois projetos no centro do ecossistema de sistemas de IA auto-hospedados — OpenClaw e Hermes Agent — saíram tanto na frente que o restante do campo está lutando por um distante terceiro lugar.
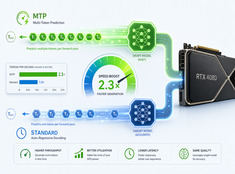
MTP vs. decodificação padrão na RTX 4080 — benchmarks reais
Testei o desempenho da decodificação especulativa (Previsão de Múltiplos Tokens, MTP) no Qwen 3.6 27B e 35B em uma RTX 4080 com 16 GB de VRAM.
VRAM gratuito sem comprometer o llama-server.
o modo roteador do llama.cpp é uma das mudanças mais úteis no llama-server em anos. Ele finalmente oferece aos operadores de LLMs locais uma experiência de gerenciamento de modelos próxima do que as pessoas esperam do Ollama, mantendo o desempenho bruto e o controle de baixo nível que tornam o llama.cpp digno de uso em primeiro lugar.
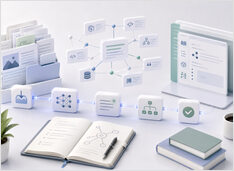
Conhecimento compilado para sistemas de IA
A premissa é simples: o conhecimento compilado é mais reutilizável do que fragmentos recuperados. O RAG tornou-se a resposta padrão para uma questão direta: como fornecer a um LLM acesso a conhecimento externo?