Devops

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Свободная VRAM без остановки llama-server

Режим маршрутизации llama.cpp — одно из самых полезных изменений в llama-server за последние годы. Наконец-то локальным операторам LLM предоставляется опыт управления моделями, близкий к тому, к которому пользователи привыкли в Ollama, при этом сохраняются высокая производительность и низкоуровневый контроль, которые делают llama.cpp стоящими того, чтобы использовать их в первую очередь.
Kanban в Hermes Agent для самохостинговых LLM-воркфлоу

Kanban в Hermes Agent для самохостинговых LLM-воркфлоу

Управляйте нагрузкой Hermes Kanban на вашем собственном LLM.

Hermes Agent поставляется с доской в стиле Kanban и Hermes Gateway, который может перегрузить вашу самохостинговую LLM, если одновременно будет поставлено слишком много задач.

Плагины OpenClaw — руководство по экосистеме и практические рекомендации

Плагины OpenClaw — руководство по экосистеме и практические рекомендации

Сначала плагины. Кратко об именовании навыков.

Эта статья посвящена плагинам OpenClaw — нативным пакетам шлюза, которые добавляют каналы, провайдеры моделей, инструменты, речевые функции, память, медиа, веб-поиск и другие возможности runtime.

Ассистент Hermes AI — установка, настройка, рабочий процесс и устранение неполадок

Ассистент Hermes AI — установка, настройка, рабочий процесс и устранение неполадок

Установка Hermes Agent и быстрое начало работы для разработчиков

Hermes Agent — это хостящийся самостоятельно (self-hosted), независимый от модели ИИ-ассистент, который работает на локальном компьютере или недорогом VPS, функционирует через терминальные и мессенджерские интерфейсы и со временем совершенствуется, превращая повторяющиеся задачи в переиспользуемые навыки (skills).

Удалённый доступ к Ollama через Tailscale или WireGuard без открытия публичных портов.

Удалённый доступ к Ollama через Tailscale или WireGuard без открытия публичных портов.

Доступ к Ollama удаленно без открытых публичных портов

Ollama чувствует себя наиболее комфортно, когда с ним обращаются как с локальным демоном: CLI и ваши приложения взаимодействуют с локальным HTTP-интерфейсом (loopback), а остальная сеть даже не знает о его существовании.

Ollama в Docker Compose с поддержкой GPU и постоянным хранением моделей

Ollama в Docker Compose с поддержкой GPU и постоянным хранением моделей

Сервер Ollama с приоритетом композиции, поддержкой GPU и сохранением данных.

Ollama отлично работает на «голом железе». Всё становится ещё интереснее, когда вы начинаете относиться к нему как к сервису: стабильный эндпоинт, закреплённые версии, постоянное хранилище данных и GPU, который либо доступен, либо нет.

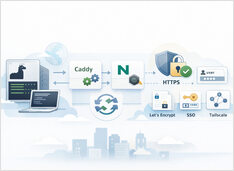
Ollama за обратным прокси-сервером Caddy или Nginx для потоковой передачи через HTTPS

Ollama за обратным прокси-сервером Caddy или Nginx для потоковой передачи через HTTPS

HTTPS для Ollama без нарушения потоковой передачи ответов.

Запуск Ollama через обратный прокси — самый простой способ обеспечить поддержку HTTPS, опциональный контроль доступа и предсказуемое поведение потоковой передачи данных.

Графовая база данных Neo4j для GraphRAG: установка, Cypher, векторы, операции.

Графовая база данных Neo4j для GraphRAG: установка, Cypher, векторы, операции.

Графы, Cypher, векторы и усиление операций.

Neo4j — это то, что вы выбираете, когда связи и есть данные. Если ваша предметная область выглядит как доска с кружками и стрелками, то попытка запихнуть её в таблицы будет болезненной.

Что такое IndexNow: уведомляйте поисковые системы при публикации контента

Что такое IndexNow: уведомляйте поисковые системы при публикации контента

Отправляйте обновленные URL-адреса в поисковые системы после развертывания.

Статические сайты и блоги меняются при каждой деплойке. Поисковые системы, поддерживающие IndexNow, могут узнать об этих изменениях, не дожидаясь следующего слепого сканирования.

Быстрый старт SGLang: установка, настройка и развертывание больших языковых моделей через API OpenAI

Быстрый старт SGLang: установка, настройка и развертывание больших языковых моделей через API OpenAI

Запускайте открытые модели быстро с помощью SGLang.

SGLang — это высокопроизводительный фреймворк для развертывания больших языковых и мультимодальных моделей, созданный для обеспечения низколатентного и высокопроизводительного вывода на устройствах от одной GPU до распределенных кластеров.

Быстрый старт Apache Kafka — установка Kafka 4.2 с помощью CLI и локальные примеры

Быстрый старт Apache Kafka — установка Kafka 4.2 с помощью CLI и локальные примеры

Установите Kafka 4.2 и начните потоковую обработку событий за считанные минуты.

Apache Kafka 4.2.0 — это текущая поддерживаемая ветка релизов, и она является лучшей отправной точкой для современного быстрого старта, поскольку Kafka 4.x полностью работает без ZooKeeper и по умолчанию построена вокруг KRaft.

Быстрый старт с обменом моделей llama для локальных LLM, совместимых с OpenAI

Быстрый старт с обменом моделей llama для локальных LLM, совместимых с OpenAI

Горячая замена локальных LLM без изменения клиентов.

Вскоре вы уже управляете несколькими инструментами: vLLM, llama.cpp и другими — каждый стек работает на своём собственном порту. При этом все последующие звенья цепочки по-прежнему ожидают один базовый URL /v1; иначе вам придётся постоянно перенастраивать порты, профили и разовые скрипты. llama-swap — это прокси для /v1, который размещается перед этими стеками.

Инструменты для разработчиков: Полное руководство по современным рабочим процессам

Инструменты для разработчиков: Полное руководство по современным рабочим процессам

Разработка программного обеспечения включает Git для контроля версий, Docker для контейнеризации, bash для автоматизации, PostgreSQL для баз данных и VS Code для редактирования — помимо множества других инструментов, которые определяют вашу продуктивность. Эта страница собирает необходимые шпаргалки, рабочие процессы и сравнения, которые помогут вам эффективно работать со всем стеком разработки.