
Claude, OpenClaw и конец эпохи фиксированного ценообразования для агентов
Подписки Claude больше не поддерживают агентов
Тихая лазейка, подпитывавшая волну экспериментов с агентами, теперь закрыта.
Подписки Claude больше не поддерживают агентов
Тихая лазейка, подпитывавшая волну экспериментов с агентами, теперь закрыта.
Самохостинговый ИИ-поиск с локальными LLM
Vane — один из наиболее прагматичных проектов в сегменте «AI-поиск со ссылками на источники»: самохостингуемый движок ответов, который сочетает живой веб-поиск с локальными или облачными LLM, сохраняя при этом полный контроль над всем стеком за вами.
Агентное кодирование, теперь с локальными моделями
Claude Code — это не просто автодополнение с лучшей маркетинговой упаковкой. Это агентный инструмент для программирования: он анализирует вашу кодовую базу, редактирует файлы, выполняет команды и интегрируется с вашими инструментами разработки.
Установка Hermes Agent и быстрое начало работы для разработчиков
Hermes Agent — это хостящийся самостоятельно (self-hosted), независимый от модели ИИ-ассистент, который работает на локальном компьютере или недорогом VPS, функционирует через терминальные и мессенджерские интерфейсы и со временем совершенствуется, превращая повторяющиеся задачи в переиспользуемые навыки (skills).
Установите TGI, развертывайте быстро, отлаживайте ещё быстрее.
Text Generation Inference (TGI) обладает очень специфической энергетикой. Это не самый новый проект на улице инференса, но это тот, который уже научился, как происходит работа в продакшене, —
Скорость генерации токенов llama.cpp на 16 ГБ VRAM (таблицы).
Здесь я сравниваю скорость нескольких LLM, работающих на GPU с 16 ГБ видеопамяти, и выбираю лучшую для самохостинга.
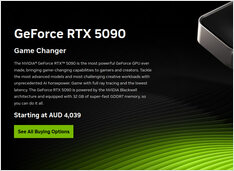
В Австралии RTX 5090 дефицитна и завышена в цене.
В Австралии есть в наличии RTX 5090. Вроде бы. И если вам повезет ее найти, вы заплатите премию, оторванную от реальности.
Доступ к Ollama удаленно без открытых публичных портов
Ollama чувствует себя наиболее комфортно, когда с ним обращаются как с локальным демоном: CLI и ваши приложения взаимодействуют с локальным HTTP-интерфейсом (loopback), а остальная сеть даже не знает о его существовании.
Сервер Ollama с приоритетом композиции, поддержкой GPU и сохранением данных.
Ollama отлично работает на «голом железе». Всё становится ещё интереснее, когда вы начинаете относиться к нему как к сервису: стабильный эндпоинт, закреплённые версии, постоянное хранилище данных и GPU, который либо доступен, либо нет.
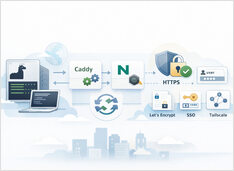
HTTPS для Ollama без нарушения потоковой передачи ответов.
Запуск Ollama через обратный прокси — самый простой способ обеспечить поддержку HTTPS, опциональный контроль доступа и предсказуемое поведение потоковой передачи данных.
Встраивания для RAG — Python, Ollama, API OpenAI.
Если вы работаете с генерацией с расширением поиска (RAG), этот раздел объясняет векторные представления текста (эмбеддинги) простым языком: что это такое, как они работают в поиске и извлечении данных, и как вызывать два распространенных локальных режима из Python с помощью Ollama или OpenAI-совместимого HTTP API (так как многие серверы на базе llama.cpp поддерживают такой интерфейс).
Запускайте открытые модели быстро с помощью SGLang.
SGLang — это высокопроизводительный фреймворк для развертывания больших языковых и мультимодальных моделей, созданный для обеспечения низколатентного и высокопроизводительного вывода на устройствах от одной GPU до распределенных кластеров.
Горячая замена локальных LLM без изменения клиентов.
Вскоре вы уже управляете несколькими инструментами: vLLM, llama.cpp и другими — каждый стек работает на своём собственном порту. При этом все последующие звенья цепочки по-прежнему ожидают один базовый URL /v1; иначе вам придётся постоянно перенастраивать порты, профили и разовые скрипты. llama-swap — это прокси для /v1, который размещается перед этими стеками.
Большинство локальных конфигураций ИИ начинаются с модели и среды выполнения.
Что происходит на самом деле при запуске Ultrawork.
Oh My Opencode обещает «виртуальную команду AI-разработчиков» — Сизиф координирует специалистов, задачи выполняются параллельно, а волшебное ключевое слово ultrawork активирует всё это.
Установите Oh My Opencode и ускоряйте разработку.
Oh My Opencode превращает OpenCode в многоагентскую среду для разработки: оркестратор делегирует работу специализированным агентам, которые выполняются параллельно.