La inferencia de LLM parece ser “solo otra API” hasta que se producen picos de latencia, las colas se saturan y tus GPUs se mantienen al 95% de uso de memoria sin una explicación obvia.
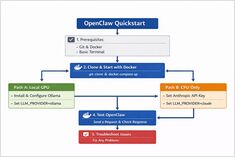
OpenClaw es un asistente de IA autoalojado diseñado para ejecutarse con entornos de ejecución de LLM locales como Ollama o con modelos basados en la nube como Claude Sonnet.
AWS S3, Garage o MinIO: visión general y comparación.
AWS S3 sigue siendo la “opción por defecto” para el almacenamiento de objetos: es completamente gestionado, ofrece consistencia fuerte y está diseñado para una durabilidad y disponibilidad extremadamente altas. Garage y MinIO son alternativas autohospedadas compatibles con S3: Garage está diseñado para clusters pequeños a medianos distribuidos geográficamente, mientras que MinIO se centra en una amplia cobertura de características de la API S3 y en un alto rendimiento en implementaciones más grandes.
Garage es un sistema de almacenamiento de objetos compatible con S3, de código abierto y autohospedado, diseñado para despliegues pequeños a medianos, con un fuerte énfasis en la resiliencia y la distribución geográfica.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Controla los datos y los modelos con LLMs autoalojados
El autoalojamiento de modelos de lenguaje grandes (LLM) mantiene los datos, los modelos y la inferencia bajo su control: una vía práctica hacia la soberanía de la IA para equipos, empresas y naciones.
Prueba de velocidad de LLM en RTX 4080 con 16 GB de VRAM
Ejecutar modelos de lenguaje grandes localmente te ofrece privacidad, capacidad de funcionamiento sin conexión y cero costos de API.
Esta benchmark revela exactamente lo que se puede esperar de 14 populares
LLMs en Ollama en una RTX 4080.
El ecosistema de Go continúa prosperando con proyectos innovadores que abarcan herramientas de IA, aplicaciones autohospedadas y infraestructura para desarrolladores. Este análisis examina los repositorios de Go más trending en GitHub de este mes.
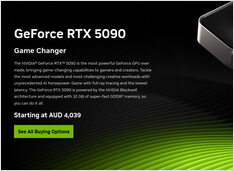
Verificación de precios de GPU y RAM en enero de 2025
Hoy nos estamos enfocando en las GPUs de consumo de alto nivel y módulos de RAM.
Específicamente, me estoy enfocando en
precios de RTX-5080 y RTX-5090, y 32GB (2x16GB) DDR5 6000.
vLLM es un motor de inferencia y servicio de alto rendimiento y eficiente en memoria para Modelos de Lenguaje Grandes (LLMs) desarrollado por el laboratorio Sky Computing de la Universidad de California en Berkeley.
Precios reales en AUD de minoristas australianos ahora
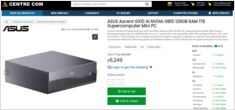
El
NVIDIA DGX Spark
(GB10 Grace Blackwell) ya está
disponible en Australia
en los principales minoristas de PC con stock local.
Si has estado siguiendo los
precios y disponibilidad globales del DGX Spark,
te interesará saber que los precios en Australia oscilan entre $6.249 y $7.999 AUD, dependiendo de la configuración de almacenamiento y del minorista.
Elegir el Mejor LLM para Cognee requiere equilibrar la calidad de construcción de gráficos, las tasas de alucinación y las restricciones de hardware.
Cognee destaca con modelos grandes de baja alucinación (32B+) a través de Ollama pero las opciones de tamaño medio funcionan para configuraciones más ligeras.
Construya agentes de búsqueda de IA con Python y Ollama
La biblioteca de Python de Ollama ahora incluye capacidades nativas de búsqueda web de OLLama. Con solo unas pocas líneas de código, puedes mejorar tus LLMs locales con información en tiempo real desde la web, reduciendo las alucinaciones e incrementando la precisión.
Elija la base de datos vectorial adecuada para su pila RAG.
Elegir el almacén de vectores adecuado puede hacer o deshacer el rendimiento, el costo y la escalabilidad de tu aplicación RAG. Esta comparación integral cubre las opciones más populares en 2024-2025.