Inicio rápido de llama.cpp con CLI y servidor
Ejecuta modelos GGUF con la CLI y el servidor
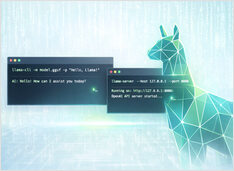
llama.cpp es un motor de inferencia en C/C++ para modelos GGUF: llama-cli para chat interactivo, llama-completion para prompts guiados por guion, y llama-server para una API HTTP compatible con OpenAI.