Hosting

Strategie cache w Hugo dla wydajności

Strategie cache w Hugo dla wydajności

Optymalizacja tworzenia i uruchamiania witryn Hugo

Caching strategie w Hugo są kluczowe dla maksymalizacji wydajności generatora statycznych stron. Choć Hugo generuje statyczne pliki, które są w naturze szybkie, implementacja odpowiedniego cacheowania na wielu warstwach może znacząco poprawić czas budowania, zmniejszyć obciążenie serwera i poprawić doświadczenie użytkownika.
ASIC LLM i specjalizowane układy do inferencji (dlaczego są ważne)

ASIC LLM i specjalizowane układy do inferencji (dlaczego są ważne)

ASICy i dedykowane układy półprzewodnikowe zwiększają szybkość i wydajność inferencji modeli LLM

Przyszłość AI to nie tylko kwestia bardziej inteligentnych modeli. Dotyczy ona również półprzewodników, które są dostosowane do rzeczywistego sposobu uruchamiania tych modeli. Specjalistyczny sprzęt do wnioskowania LLM podąża ścieżką przypominającą ewolucję kopania Bitcoina od GPU po dedykowane układy ASIC, jednak w znacznie trudniejszych warunkach, ponieważ modele i schematy precyzji wciąż się zmieniają.

Porównanie dystrybucji Kubernetes dla homelaba z 3 węzłami

Porównanie dystrybucji Kubernetes dla homelaba z 3 węzłami

Wybór najlepszego wariantu Kubernetes dla naszej domowej laboratorium

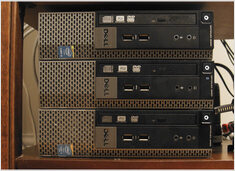
Porównuję wersje samowystarczalnego Kubernetesa, które nadają się do homelaba opartego na Ubuntu z 3 węzłami (16 GB RAM, 4 rdzenie CPU każdy), skupiając się na łatwości instalacji i konserwacji, obsłudze persistent volumes i LoadBalancers.