
Protokół A2A Google w 2026 roku: adopcja, hype i rzeczywistość
A2A nie umarło. Po prostu nie jest uniwersalne.
Pierwszy rok protokołu Agent2Agent Google (zazwyczaj skracanego do A2A) był dość niezwykły.
A2A nie umarło. Po prostu nie jest uniwersalne.
Pierwszy rok protokołu Agent2Agent Google (zazwyczaj skracanego do A2A) był dość niezwykły.
Niezawodne wzory oparte na zapytywaniu dla agentów AI.
Agenci pollingowi to jedna z najmniej glamour części architektury asystentów AI, ale jednocześnie jedna z najbardziej przydatnych.
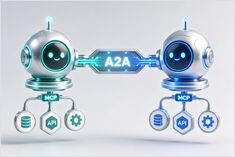
MCP daje agentom narzędzia. A2A daje agentom równe partnerstwo.
Architektura agentów AI zaczyna dzielić się na dwie warstwy.
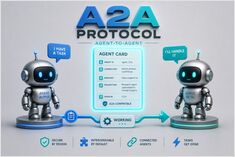
A2A zamienia agentów w węzły sieciowe.
Protokół A2A, skrótem od Agent2Agent Protocol, to otwarty standard komunikacji między niezależnymi systemami agentów AI.
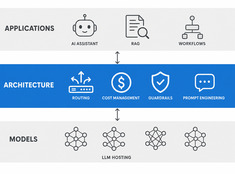
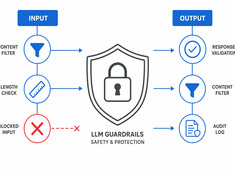
Kontroluj ryzyko, nie tylko model.
Modele językowe (LLM) są nieprzewidywalne. Mogą halucynować, wyciekać dane, generować szkodliwe treści lub odmawiać spełnienia legalnych żądań. Mechanizmy ochronne (guardrails) ograniczają zachowanie modelu, nie tracąc przy tym jego możliwości.
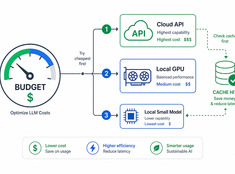
Wykorzystuj tokeny tam, gdzie naprawdę liczą się one najbardziej.
Koszt LLM-ów rośnie liniowo wraz z wolumenem używania. System przetwarzający 10 000 zapytań dziennie przy cenie 0,01 USD za zapytanie kosztuje 100 USD dziennie — 365 USD rocznie. W skali przedsiębiorstwa to ponad 10 000 USD.
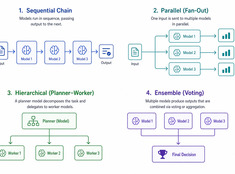
Wybierz najprostszy wzorzec, który spełnia zadanie.
Systemy oparte na pojedynczym modelu są proste. Systemy wielomodelowe są potężne. Wyzwanie nie polega na wyborze modeli – ale na zaprojektowaniu architektury, która je orkiestruje.
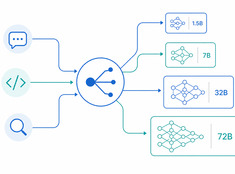
Dopasuj odpowiedni model do właściwego zadania.
Uruchamianie modelu o 70 miliardach parametrów w celu podsumowania maila na 200 słów to marnotrawstwo. Używanie 3-miliardowego modelu do weryfikacji kodu produkcyjnego jest z kolei nieodpowiedzialne. Większość systemów funkcjonuje gdzieś pomiędzy tymi skrajnościami — i właśnie tutaj wchodzi model routing.
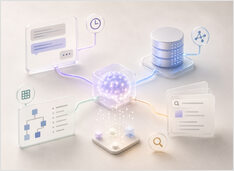
Pamięć robocza, strukturalna i odzyskiwania dla asystentów.
Pamięć zamienia asystentów w systemy trwałych, a nie tylko reaktywnych, ale to właśnie tam wiele systemów cichnie i podlega degradacji. Ankiety wskazują, że podział na pamięć krótkotrwałą i długotrwałą już nie wystarczy dla pamięci nowoczesnych agentów; SDK OpenAI i LangGraph wskazują na prostszy stos — pamięć roboczą, trwały stan i pobieranie danych (retrieval).
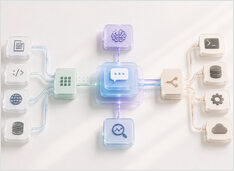
Jak w rzeczywistości tworzony jest poważny asystent.
Produkcjonalny asystent AI to nie „LLM z promptem”. To system, który przyjmuje intencję, zachowuje stan, decyduje, kiedy odpytać źródła lub podjąć działanie, i ujawnia wystarczające detale runtime’u, aby debugować błędy.
AI zmienia zarządzanie wiedzą, nie jej cel.
AI nie zastępuje zarządzania wiedzą; zmienia jej kształt zarówno dla osób indywidualnych, jak i zespołów.
Gwiazdki, tokeny, pobrania — kto naprawdę wygrywa?
Otwartoźródłowe frameworki agentów AI przeżywają na GitHubie okres wybuchowego wzrostu popularności. Dwa projekty, które stanowią rdzeń ekosystemu systemów AI self-hostowanych — OpenClaw i Hermes Agent — odniosły tak ogromną przewagę, że reszta branży walczy o daleko odległe trzecie miejsce.
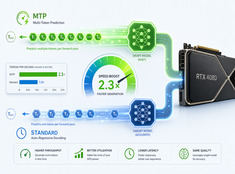
MTP vs. standardowe dekoding na karcie RTX 4080 — rzeczywiste benchmarki
Przetestowałem wydajność dekodowania spekulatywnego (Predykcja Wielu Tokenów, MTP) w modelach Qwen 3.6 27B i 35B na karcie RTX 4080 z 16 GB pamięci VRAM.
Darmowa pamięć VRAM bez zabijania llama-server.
Tryb routera w llama.cpp to jedna z najbardziej przydatnych zmian wprowadzonych do llama-server w ciągu ostatnich lat. Wreszcie daje lokalnym operatorom modeli LLM coś w rodzaju zarządzania modelami, do którego są przyzwyczajeni z Ollama, jednocześnie zachowując surową wydajność i kontrolę na niskim poziomie, która sprawia, że warto korzystać z llama.cpp w pierwszej kolejności.
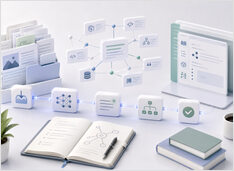
Złożona wiedza dla systemów AI
Premisa jest prosta: skompilowana wiedza jest bardziej ponownie wykorzystywalna niż pobrane fragmenty. RAG stał się domyślną odpowiedzią na proste pytanie – jak zapewnić LLM dostęp do zewnętrznej wiedzy?