LLM

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

Dlaczego kontekst 128K zawodzi na 16 GB

Model może reklamować okno kontekstowe 128K i mimo to zawiedzie przy 40K tokenach na karcie GPU 16 GB. Architektoniczny limit nigdy nie gwarantował, że wagi, cache KV, bufora obliczeniowe i kompozytor pulpitu zmieszczą się jednocześnie na Twojej karcie.
Czym są LLM-y? Mamba, modele dyfuzyjne i światowe

Czym są LLM-y? Mamba, modele dyfuzyjne i światowe

Co po LLM-ach? Era posttransformerowa.

Hype wokół AI podąża za pewnym rytmem: mniej więcej co trzy lata architektura, w którą wszyscy grają, zostaje zastąpiona przez nowszą. Kolejna zmiana już kształtuje się w laboratoriach badawczych.

Szybki start z Superpowers: instalacja, przepływ pracy i testowanie

Szybki start z Superpowers: instalacja, przepływ pracy i testowanie

Wymuszone umiejętności SDD, instalowane jednym poleceniem.

Superpowers to pakiet, który integruje kompletną, specyfikacyjną metodologię programowania w instalowalne Claude Skills, wymuszając burzę mózgów, planowanie, implementację opartą na subagentach oraz rygorystyczne TDD, zamiast pozostawiać tę strukturę Twojej dyscyplinie.

Grawitacja danych: prawdziwa koszt strategii API-first w sztucznej inteligencji

Grawitacja danych: prawdziwa koszt strategii API-first w sztucznej inteligencji

Dlaczego Twój stos AI staje się co miesiąc bardziej kleisty.

Każde wywołanie API wydaje się prostą transakcją – dopóki nie gromadzi się ich na tyle dużo, że dane do dostrojenia, zestawy do ewaluacji oraz schematy narzędzi nie zaczynają być ukształtowane wokół jednego dostawcy, a zmiana dostawcy przestaje być jedynie zmianą routingu.

Claude Code Subagenci: konfiguracja, ustawienia i przypadki użycia

Claude Code Subagenci: konfiguracja, ustawienia i przypadki użycia

Deleguj hałaśliwe zadania, utrzymuj czysty kontekst.

Większość sesji w Claude Code spowalnia i staje się nieczytelna z tego samego powodu: każde eksploracyjne użycie grep, każdy zrzut logów oraz każde „sprawdzę jeszcze jeden plik” pozostaje w głównej konwersacji na stałe.

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Kiedy przejść z Ollamy na vLLM

Ollama to jeden z najprostszych sposobów na uruchomienie lokalnego modelu językowego, jednak wygoda może ukrywać moment, w którym lokalny eksperyment staje się współdzieloną usługą inferencyjną wymagającą lepszego planowania zadań i obserwowalności.

Utrzymywanie spójności specyfikacji, testów i kodu w procesie rozwoju AI

Utrzymywanie spójności specyfikacji, testów i kodu w procesie rozwoju AI

Zapobiegaj odchyleniom agentów AI od specyfikacji, testów i kodu.

Agenci kodujący z wykorzystaniem sztucznej inteligencji (AI) szybkodostarczają funkcje, ale specyfikacje, testy i kod cicho się od siebie oddalają. Ten przewodnik omawia model śledzenia (traceability), mapowanie specyfikacji na testy oraz kodu, a także sprawdzenia CI, które wychwytują rozbieżności przed scaleniem (merge).

GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

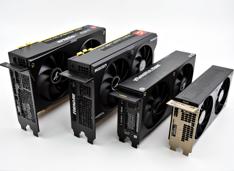
Porównanie GPU AI trzech dostawców

Krajobraz sprzętu do sztucznej inteligencji uległ znaczącej zmianie w 2026 roku, przy czym NVIDIA, AMD i Intel rywalizują o deweloperów potrzebujących kart graficznych (GPU) zdolnych do uruchamiania lokalnie dużych modeli językowych (LLM) oraz obciążeń wnioskowania (inference).

Spekulacyjne dekodowanie: 20–50% szybsza inferencja modeli LLM

Spekulacyjne dekodowanie: 20–50% szybsza inferencja modeli LLM

Szybsza inferencja LLM bez utraty jakości – praktyczny przewodnik

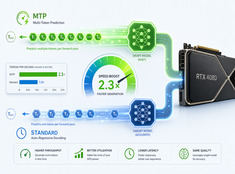
Model o 70 mld parametrów generuje jeden token w jednym przebiegu przodowym (forward pass), przy czym każda taka operacja powoduje ponowne wczytywanie wag z pamięci VRAM, obliczanie mechanizmu uwagi na całym kontekście oraz synchronizację pamięci. W odstępach między tokenami GPU pozostaje nieczynne, czekając na wyznaczenie zależności sekwencyjnych.