
Wzory konfiguracji OpenClaw w środowisku produkcyjnym z użyciem wtyczek i umiejętności
Jak naprawdę są skonstruowane systemy OpenClaw
OpenClaw wygląda prosto w demonstracjach. W środowisku produkcyjnym staje się on systemem.
Jak naprawdę są skonstruowane systemy OpenClaw
OpenClaw wygląda prosto w demonstracjach. W środowisku produkcyjnym staje się on systemem.
Subskrypcje Claude’a nie są już wykorzystywane do zasilania agentów
Cicha luka, która napędzała falę eksperymentów z agentami, została teraz zamknięta.
Własna wyszukiwarka AI z lokalnymi modelami LLM
Vane to jeden z bardziej pragmatycznych projektów w przestrzeni „AI-search z cytatami”: samodzielnie hostowany silnik odpowiedzi, który łączy wyszukiwanie na żywej sieci z modelami LLM (lokalnymi lub w chmurze), a jednocześnie pozwala zachować pełną kontrolę nad całym stackiem.
Agencjonalne kodowanie, teraz z lokalnymi backendami modeli.
Claude Code to nie autouzupełnianie z lepszym marketingiem. To narzędzie kodowania agentowe: czyta Twoją bazę kodu, edytuje pliki, uruchamia polecenia i integruje się z Twoimi narzędziami developerskimi.
Instalacja i szybki start dla developerów: Hermes Agent
Hermes Agent to hostowany we własnym zakresie, agnostyczny względem modelu asystent AI, działający na komputerze lokalnym lub tanim VPS. Komunikuje się przez interfejs terminala i komunikatory, z czasem zwiększając swoje możliwości, zmieniając powtarzalne zadania w ponownie używalne umiejętności.
Zainstaluj TGI, wdrażaj szybko, debuguj jeszcze szybciej.
Text Generation Inference (TGI) ma bardzo specyficzną energię. Nie jest najmłodszym dzieckiem na ulicy inferencji, ale jest tym, które już nauczyło się, jak produkcja się psuje –
Szybkość generowania tokenów llama.cpp na VRAM 16 GB (tabele).
Oto porównuję szybkość kilku modeli LLM działających na GPU z 16 GB pamięci VRAM i wybieram najlepszy z nich do samodzielnego hostingu.
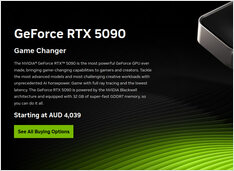
RTX 5090 w Australii jest rzadkością i zawyżona cenowo.
Australia ma na stanie karty RTX 5090. Ledwie. A jeśli którąś znajdziesz, zapłacisz cenę, która wydaje się oderwana od rzeczywistości.
Zdalny dostęp do Ollamy bez otwierania portów publicznych
Ollama czuje się najlepiej, gdy jest traktowane jak lokalny demon: CLI i Twoje aplikacje komunikują się z API HTTP na pętli lokalnej (loopback), a reszta sieci nigdy nie dowiaduje się o jego istnieniu.
Serwer Ollama w stylu Compose-first z obsługą GPU i trwałym zapisem danych.
Ollama świetnie działa na “gołym” metalu (bez warstwy wirtualizacji). Staje się jeszcze ciekawszy, gdy traktujesz go jak usługę: stabilny punkt końcowy, przypięte wersje, trwałe przechowywanie danych oraz GPU, które jest dostępne, lub go nie ma.
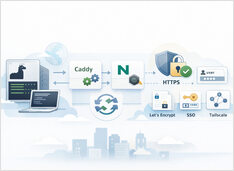
HTTPS z Ollama bez przerywania strumieniowych odpowiedzi.
Uruchomienie Ollama za pośrednictwem proxy odwrotnego to najprostszy sposób na uzyskanie HTTPS, opcjonalnej kontroli dostępu oraz przewidywalnego zachowania strumieniowego.
RAG embeddings – Python, Ollama, API OpenAI.
Jeśli pracujesz nad generacją wspieraną odzyskiwaniem (RAG), ta sekcja wyjaśnia wektory tekstowe (embeddings) prostym językiem — czym są, jak pasują do wyszukiwania i odzyskiwania informacji, oraz jak wywołać dwa popularne lokalne rozwiązania z Pythonu przy użyciu Ollama lub kompatybilnego z OpenAI interfejsu HTTP (jakiego używają serwery oparte na llama.cpp).
SGLang – szybkie uruchamianie otwartych modeli.
SGLang to wysokowydajny framework do obsługi dużych modeli językowych i multimodalnych, zaprojektowany do zapewnienia niskiego opóźnienia i wysokiej przepustowości podczas wnioskowania, niezależnie od tego, czy działa na pojedynczej karcie GPU, czy w rozproszonych klastrach.
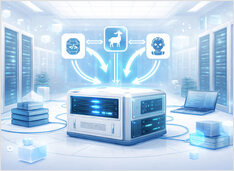
Gorąca wymiana lokalnych LLMów bez zmian w klientach.
Wkrótce będziesz jugglingiem w vLLM, llama.cpp i wielu innych — każdy stack na własnym porcie. Wszystkie komponenty dół wciąż wymagają jednego /v1 bazowego adresu URL; inaczej będziesz w nieskończoność przesuwać porty, profile i jednorazowe skrypty. llama-swap to /v1 proxy umieszczane przed tymi stackami.
Większość lokalnych konfiguracji AI zaczyna się od modelu i środowiska wykonawczego.
Co tak naprawdę dzieje się, gdy uruchamiasz Ultrawork.
Oh My Opencode obiecuje „wirtualny zespół deweloperski AI" — Sisyphus koordynuje specjalistów, zadania są wykonywane równolegle, a magiczne słowo kluczowe ultrawork uruchamia całą tę machinę.