
Wydajność LLM w 2026 roku: benchmarki, wąskie gardła i optymalizacja
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.
Kontroluj dane i modele za pomocą własnych, lokalnie hostowanych LLM
Hositing własny LLM daje kontrolę nad danymi, modelami i wnioskowaniem – jest to praktyczna droga do sukwerenności AI dla zespołów, przedsiębiorstw i krajów.
Test prędkości LLM na RTX 4080 z 16 GB VRAM
Uruchamianie dużych modeli językowych lokalnie zapewnia prywatność, możliwość pracy offline i zerowe koszty API. Ten benchmark dokładnie pokazuje, czego można oczekiwać od 14 popularnych LLM na Ollama na karcie RTX 4080.
Najpopularniejsze repozytoria Python w październiku 2026
Ekosystem Python w tym miesiącu dominują Claude Skills oraz narzędzia do agentów AI. Ten przegląd analizuje najwyżej trendujące repozytoria Python na GitHubie.
Trendowe repozytoria Rusta na październik 2026
Strona trendująca Rust tego miesiąca czyta się jak mapa infrastruktury agentów: przeglądarki, sandboxy, wyszukiwarki i warstwy pamięci zbudowane dla agentów AI, obok ugruntowanych środowisk i frameworków do tworzenia aplikacji desktopowych i gier. Niniejszy przegląd analizuje najpopularniejsze repozytoria Rust na GitHubie tego miesiąca.
Popularne repozytoria Go w październiku 2026
Ekosystem Go nadal dynamicznie się rozwija, a tymiesięczny ranking najpopularniejszych projektów jest zdominowany przez infrastrukturę agentów AI. Niniejszy przegląd analizuje najpopularniejsze repozytoria Go na GitHubie w tym miesiącu.
Self-hostowana alternatywa dla ChatGPT dla lokalnych LLM-ów
Open WebUI to potężna, rozszerzalna i bogata w funkcje, samodzielnie hostowana przeglądarkowa aplikacja do interakcji z dużymi modelami językowymi.
Instalacja, wdrażanie i optymalizacja vLLM w 2026 roku
vLLM to silnik inferencji i serwowania o wysokiej przepustowości i wydajnym zarządzaniu pamięcią dla dużych modeli językowych (LLM), opracowany przez Sky Computing Lab na UC Berkeley.
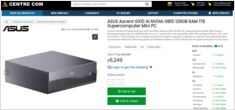
Prawdziwe ceny w AUD od australijskich sprzedawców już teraz.
NVIDIA DGX Spark](https://www.glukhov.org/pl/hardware/ai/nvidia-dgx-spark/ “NVIDIA DGX Spark - mały superkomputer AI”) (GB10 Grace Blackwell) jest dostępny w Australii w głównych sklepach z komputerami, z miejscowym zapasem. Jeśli śledzicie ceny i dostępność DGX Spark na świecie, zainteresuje Was zapewne, że ceny w Australii wahają się od 6 249 do 7 999 AUD w zależności od konfiguracji pamięci masowej i sprzedawcy.
Techniczny przewodnik po wykrywaniu treści wygenerowanych przez AI
Proliferacja treści wygenerowanych przez AI stworzyła nowe wyzwania: rozróżnianie rzeczywistego pisania ludzkiego od “AI slop” - niskiej jakości, masowo produkowanej syntetycznej treści.
Testowanie Cognee z lokalnymi modelami LLM - rzeczywiste wyniki
Cognee to framework w Pythonie do budowania grafów wiedzy z dokumentów za pomocą LLM. Ale działa on z modelami samozhostowanymi?
Bezpieczne typowo wyjścia LLM z BAML i Instructor
Pracując z dużymi modelami językowymi (LLM) w środowisku produkcyjnym, kluczowe jest uzyskiwanie ustrukturyzowanych wyjść bezpiecznych typowo.
Dwa popularne frameworki – BAML i Instructor – stosują różne podejścia do rozwiązania tego problemu.
Refleksje nad LLM dla samowystarczalnego Cognee
Wybór najlepszego LLM dla Cognee wymaga zrównoważenia jakości budowania grafów, poziomu halucynacji i ograniczeń sprzętowych.
Cognee wyróżnia się w przypadku większych modeli o niskim poziomie halucynacji (32B+) poprzez Ollama, jednak opcje o średnich parametrach są odpowiednie dla prostszych konfiguracji.
Buduj agenty AI do wyszukiwania w Pythonie i Ollamie
Biblioteka Python Ollama zawiera obecnie natywne możliwości przeszukiwania sieci za pomocą Ollama. Wystarczy kilka linii kodu, aby wzbogacić Twoje lokalne modele LLM o bieżące informacje z sieci, co zmniejsza halucynacje i poprawia dokładność.
Wybierz odpowiednią bazę wektorową dla swojej architektury RAG.
Wybór odpowiedniej bazy wektorowej może zadecydować o powodzeniu Twojej aplikacji RAG pod względem wydajności, kosztów i skalowalności. To kompleksowe porównanie obejmuje najpopularniejsze opcje w latach 2024-2025.
Twórz agentów wyszukiwania AI z użyciem Go i Ollama
API wyszukiwania w internecie Ollama umożliwia wzbogacanie lokalnych modeli LLM o bieżące informacje z sieci. Ten przewodnik pokazuje, jak zaimplementować możliwości wyszukiwania w internecie w Go, od prostych wywołań API po w pełni rozbudowanych agentów wyszukiwania.