LLM

Ollama a vLLM, a LM Studio: najlepszy sposób na uruchamianie LLM lokalnie w 2026 roku?

Ollama a vLLM, a LM Studio: najlepszy sposób na uruchamianie LLM lokalnie w 2026 roku?

Porównanie najlepszych narzędzi do lokalnego hostingu LLM w 2026 roku. Dojrzałość API, obsługa sprzętu, wywoływanie narzędzi oraz zastosowania w praktyce.

Lokalne uruchamianie LLM jest obecnie praktyczne dla deweloperów, startupów, a nawet zespołów korporacyjnych.
Ale wybór odpowiedniego narzędzia — Ollama, vLLM, LM Studio, LocalAI lub innego — zależy od Twoich celów:
Go w usłudze mikroserwisowe do orkiestracji AI/ML

Go w usłudze mikroserwisowe do orkiestracji AI/ML

Tworzenie solidnych potoków AI/ML z mikrousługami w Go

W miarę jak obciążenia związane z AI i ML stają się coraz bardziej złożone, rośnie potrzeba wdrożenia solidnych systemów orkiestracji. Prostota, wydajność i konkurencja języka Go sprawiają, że jest on idealnym wyborem do budowy warstwy orkiestracji w potokach ML, nawet wtedy, gdy same modele są napisane w Pythonie.

Infrastruktura sztucznej inteligencji na sprzęcie konsumenckim

Infrastruktura sztucznej inteligencji na sprzęcie konsumenckim

Wdrażanie przedsiębiorstwowej sztucznej inteligencji na budżetowym sprzęcie przy użyciu modeli open-source.

Demokratyzacja sztucznej inteligencji jest tuż przed nami. Dzięki otwartym modelom LLM takim jak Llama, Mistral i Qwen, które dorównują już modelom własnościowym, zespoły mogą budować potężną infrastrukturę AI na sprzęcie konsumenckim – drastycznie obniżając koszty, jednocześnie zachowując pełną kontrolę nad prywatnością danych i wdrożeniem.

Uruchamianie FLUX.1-dev GGUF Q8 w Pythonie

Uruchamianie FLUX.1-dev GGUF Q8 w Pythonie

Przyspiesz FLUX.1-dev za pomocą kwantyzacji GGUF

FLUX.1-dev to potężny model generowania obrazów na podstawie tekstu, który daje wspaniałe wyniki, ale jego wymagania co do pamięci (24 GB i więcej) sprawiają, że trudno go uruchomić na wielu systemach. GGUF quantization of FLUX.1-dev oferta rozwiązania, które zmniejsza zużycie pamięci o około 50%, jednocześnie zachowując bardzo dobre jakość obrazów.

Konwersja HTML na Markdown za pomocą Pythona: Kompletny przewodnik

Konwersja HTML na Markdown za pomocą Pythona: Kompletny przewodnik

Python do konwersji HTML na czysty, gotowy do przetwarzania przez LLM Markdown

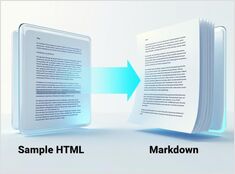
Konwersja HTML na Markdown to fundamentalna czynność w nowoczesnych przepływach pracy programistycznych, szczególnie przygotowując treści sieciowe do Large Language Models (LLM), systemów dokumentacji lub generatorów stron statycznych takich jak Hugo. Niniejszy przewodnik jest częścią naszego Narzędzi do Dokumentacji w 2026: Markdown, LaTeX, PDF i Pracy z Drukowaniem.

ASIC LLM i specjalizowane układy do inferencji (dlaczego są ważne)

ASIC LLM i specjalizowane układy do inferencji (dlaczego są ważne)

ASICy i dedykowane układy półprzewodnikowe zwiększają szybkość i wydajność inferencji modeli LLM

Przyszłość AI to nie tylko kwestia bardziej inteligentnych modeli. Dotyczy ona również półprzewodników, które są dostosowane do rzeczywistego sposobu uruchamiania tych modeli. Specjalistyczny sprzęt do wnioskowania LLM podąża ścieżką przypominającą ewolucję kopania Bitcoina od GPU po dedykowane układy ASIC, jednak w znacznie trudniejszych warunkach, ponieważ modele i schematy precyzji wciąż się zmieniają.