Teste do LLM OpenCode — estatísticas de codificação e precisão
Testei como o OpenCode funciona com vários LLMs hospedados localmente no Ollama e llama.cpp, e, para comparação, adicionei alguns modelos gratuitos do OpenCode Zen.
Instalação via CLI, flags, headless, modelos locais
O OpenHands é um agente de codificação open-source que edita ficheiros e executa comandos num sandbox. Este guia rápido de CLI foi verificado em 26/10/2026 contra o pacote 1.16.0.
Hospede APIs compatíveis com OpenAI com o LocalAI em minutos.
O LocalAI é um servidor de inferência de auto-hospedagem, com prioridade local, projetado para funcionar como uma API OpenAI plug-and-play para executar cargas de trabalho de IA no seu próprio hardware (laptop, estação de trabalho ou servidor local).
Instale o Oh My Opencode e desenvolva mais rápido.
O Oh My Opencode transforma o OpenCode em um harness de codificação multi-agente: um orquestrador delega trabalhos para agentes especialistas que executam em paralelo.
llama.cpp é um motor de inferência em C/C++ para modelos GGUF: llama-cli para chat interativo, llama-completion para prompts roteirizados e llama-server para uma API HTTP compatível com OpenAI.
A Inteligência Artificial está a remodelar a forma como o software é escrito, revisto, implantado e mantido. Desde assistentes de codificação com IA até automação GitOps e fluxos de trabalho DevOps, os desenvolvedores dependem agora de ferramentas impulsionadas por IA em todo o ciclo de vida do software.
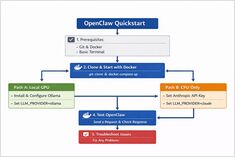
OpenCode é um agente de codificação com IA de código aberto que você pode executar no terminal (TUI + CLI), com interfaces opcionais para desktop e IDEs. Este é o Início Rápido do OpenCode: instalar, verificar, conectar um modelo/provedor e executar fluxos de trabalho reais (CLI + API).
A inferência de LLM parece ser “apenas outra API” — até que a latência dispare, as filas se acumulem e suas GPUs fiquem com 95% de memória sem uma explicação óbvia.
O OpenClaw é um assistente de IA auto-hospedado projetado para funcionar com tempos de execução de LLM locais, como Ollama, ou com modelos baseados em nuvem, como o Claude Sonnet.
Construa fluxos de trabalho em Go com o SDK Temporal
Temporal é um mecanismo de workflow de código aberto e nível empresarial que permite aos desenvolvedores construir aplicações de workflow duráveis, escaláveis e tolerantes a falhas, utilizando linguagens de programação familiares como Go.
Estratégia de observabilidade ponta a ponta para inferência de LLM e aplicações de LLM
Os sistemas de LLM falham de maneiras que a monitorização tradicional de APIs não consegue revelar — as filas enchem-se silenciosamente, a memória da GPU satura-se muito antes de a CPU parecer ocupada e a latência explode na camada de loteamento (batching) em vez da camada de aplicação.
Métricas, painéis, logs e alertas para sistemas de produção — Prometheus, Grafana, Kubernetes e cargas de trabalho de IA.
Observabilidade é a base de sistemas de produção confiáveis.
Sem métricas, painéis e alertas, os clusters Kubernetes se desviam, as cargas de trabalho de IA falham silenciosamente e as regressões de latência passam despercebidas até que os usuários reclame.
De RAG básico à produção: chunking, busca vetorial, reranking e avaliação em um único guia.
Production-focused guide to building RAG systems: chunking, vector stores, hybrid retrieval, reranking, evaluation, and when to choose RAG over fine-tuning.
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.