Llm

Что дальше после LLM: Mamba, диффузия и world models

Что дальше после LLM: Mamba, диффузия и world models

Что последует за LLM? Посттрансформерская эра.

Хайп вокруг ИИ подчиняется определённому ритму: примерно раз в три года архитектура, на которую все делают ставку, вытесняется чем-то более новым. Смена парадигмы уже начинается в исследовательских лабораториях.
OpenCode CLI на практике: рабочие процессы, автоматизация и подводные камни

OpenCode CLI на практике: рабочие процессы, автоматизация и подводные камни

«OpenCode из командной строки: на практике»

Командная строка OpenCode разработана для скриптов, CI-конвейеров и автономного запуска агентов. Эта статья представляет собой практическое руководство по её использованию в повседневной работе.

Быстрый старт Superpowers: установка, рабочий процесс и примеры

Быстрый старт Superpowers: установка, рабочий процесс и примеры

Навыки SDD, внедрённые одной командой.

Пакет Superpowers инкапсулирует полноценную методику разработки по спецификациям в устанавливаемые навыки Claude (Claude Skills), навязывая мозговой штурм, планирование, реализацию с помощью субагентов и строгий TDD, вместо того чтобы оставлять формирование этой структуры на ваше усмотрение.

Обзор агента Pi Coding: минималистичный CLI для AI-кодинга с возможностью кастомизации

Обзор агента Pi Coding: минималистичный CLI для AI-кодинга с возможностью кастомизации

«Небольшой агент для программирования, который требует, чтобы вы его настраивали».

Pi Coding Agent — это минималистичный, открытый терминальный каркас для программирования, который поставляется с четырьмя инструментами по умолчанию и оставляет большую часть поведения на усмотрение расширений, навыков и вашего собственного рабочего процесса.

Гравитация данных: реальная стоимость API-first ИИ

Гравитация данных: реальная стоимость API-first ИИ

«Почему ваш AI-стек становится всё более «липким» каждый месяц»

Каждый вызов API кажется простой транзакцией - пока их накопится достаточно много, и ваши данные для дообучения, системы оценки и схемы инструментов не начнут формироваться вокруг одного вендора, после чего смена провайдера перестанет быть простой сменой маршрутизации.

Subагенты Claude Code: настройка, конфигурация и сценарии использования

Subагенты Claude Code: настройка, конфигурация и сценарии использования

Делегируйте шумные задачи, сохраняйте контекст чистым.

Большинство сессий Claude Code становятся медленными и загроможденными по одной и той же причине: каждый исследовательский grep, каждый дамп логов и каждое «подождите, я проверю еще один файл» навсегда остаются в основном разговоре.

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Когда переходить с Ollama на vLLM

Ollama — один из самых простых способов запуска локальной языковой модели, но удобство может скрывать момент, когда локальный эксперимент превращается в общий сервис инференса, требующий лучшего планирования и наблюдаемости.

Синхронизация спецификаций, тестов и кода в разработке ИИ

Синхронизация спецификаций, тестов и кода в разработке ИИ

Не позволяйте AI-агентам отклоняться от спецификаций, тестов и кода.

Агенты ИИ для написания кода быстро выпускают функции, но спецификации, тесты и код незаметно расходятся. Этот гид описывает модель прослеживаемости, маппинг спецификаций на тесты и код, а также проверки CI, которые выявляют расхождения перед слиянием.

Обслуживание LLM Wiki: дрейф, противоречия и рецензирование

Обслуживание LLM Wiki: дрейф, противоречия и рецензирование

Обеспечьте достоверность скомпилированных знаний

Неудача в использовании LLM Wiki наступает тогда, когда старые факты остаются правдоподобными, противоречия становятся гладкими, а сгенерированные резюме отдаляются от своих источников.

GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

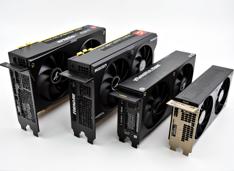
Сравнение AI-GPU от трёх производителей

Ландшафт аппаратных решений для ИИ значительно изменился в 2026 году: NVIDIA, AMD и Intel соревнуются за разработчиков, которым требуются GPU, способные запускать локальные большие языковые модели (LLM) и выполнять задачи инференса.

Безопасность агентов A2A и MCP: идентификация, делегирование и журналы аудита

Безопасность агентов A2A и MCP: идентификация, делегирование и журналы аудита

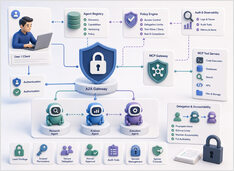
Безопасность протокола определяет, кто может действовать, а не модель.

Инъекция промптов привлекает основное внимание в области безопасности систем на базе больших языковых моделей (LLM), и это заслужено, но это не вся проблема, когда агенты начинают вызывать инструменты и делегировать работу другим агентам.

A2A-стриминг и асинхронные задачи для длительных агентных рабочих процессов

A2A-стриминг и асинхронные задачи для длительных агентных рабочих процессов

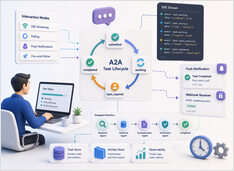
Долгоживущие A2A-задачи продолжают существовать после завершения чат-сессий.

Большинство демонстраций AI-агентов по-прежнему ведут себя как чат-завершения с дополнительными шагами: вы отправляете промпт, ждете несколько секунд и получаете ответ в одном сообщении.

Спекулятивное декодирование: ускорение инференса LLM на 20–50%

Спекулятивное декодирование: ускорение инференса LLM на 20–50%

Более быстрый инференс LLM без потери качества — практическое руководство

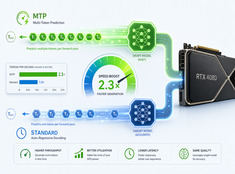
Модель 70B генерирует один токен за один прямой проход (forward pass), и каждый проход перезагружает веса из видеопамяти (VRAM), вычисляет внимание (attention) для всего контекста и синхронизирует память. Между токенами GPU простаивает, ожидая разрешения последовательных зависимостей.

Что такое спецификация-ориентированная разработка? Спецификация как источник истины

Что такое спецификация-ориентированная разработка? Спецификация как источник истины

«Спецификация как источник истины, а не вспомогательный документ».

Разработка на основе спецификаций (Spec-Driven Development) — это одна из тех идей, к которым инженеры по софту обращались ранее, а затем откладывали, когда усилия переставали приносить отдачу.