
Агенты опроса в ИИ-ассистентах: 11 шаблонов реализации
Надёжные паттерны опроса для AI-агентов.
Агенты с опросом (polling agents) — одна из наименее гламурных частей архитектуры AI-ассистентов, но одновременно и одна из самых полезных.
Надёжные паттерны опроса для AI-агентов.
Агенты с опросом (polling agents) — одна из наименее гламурных частей архитектуры AI-ассистентов, но одновременно и одна из самых полезных.
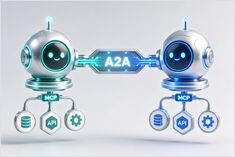
MCP предоставляет агентам инструменты. A2A предоставляет агентам коллег.
Архитектура AI-агентов начинает разделяться на два уровня.
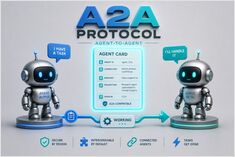
A2A превращает агентов в равноправных участников сети.
Протокол A2A (Agent-to-Agent Protocol), аббревиатура от Agent2Agent Protocol, представляет собой открытый стандарт для взаимодействия между независимыми системами ИИ-агентов.
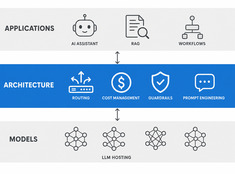
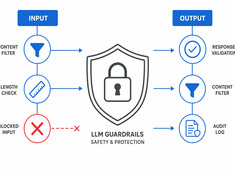
Управляйте риском, а не только моделью.
Языковые модели (LLM) непредсказуемы. Они галлюцинируют, утекают данные, генерируют вредоносный контент или отказывают в выполнению легитимных запросов. Ограничители (guardrails) constraining поведение модели без ущерба для её возможностей.
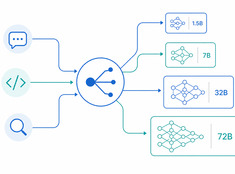
Правильная модель для правильной задачи.
Запуск модели с 70 миллиардами параметров для суммаризации электронного письма из 200 слов — это расточительство. Запуск модели с 3 миллиардами параметров для ревью продакшн-кода — это безрассудство. Большинство систем находятся где-то посередине, и именно здесь в игру вступает роутинг моделей (маршрутизация запросов).
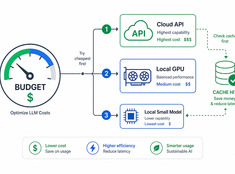
Тратьте токены там, где это действительно важно.
Стоимость LLM растёт линейно в зависимости от объёма использования. Система, обрабатывающая 10 000 запросов в день по цене 0,01 долл. за запрос, обходится в 100 долл. ежедневно — 365 долл. в год. В масштабах предприятия это превышает 10 000 долл.
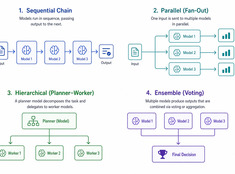
Выберите самый простой работающий паттерн.
Системы с одной моделью просты. Системы с несколькими моделями мощны. Сложность заключается не в выборе моделей, а в проектировании архитектуры, которая ими управляет.
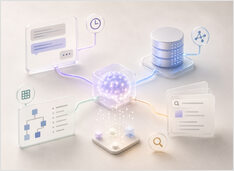
Рабочая, структурная и поисковая память для ассистентов.
Память превращает ассистентов из реактивных в персистентные, но именно в ней множество систем тихо деградируют. Исследования утверждают, что разделения на краткосрочную и долгосрочную память больше недостаточно для современных агентных систем памяти; SDK от OpenAI и LangGraph указывают на более простую стек-модель — рабочая память, персистентное состояние и поиск (retrieval).
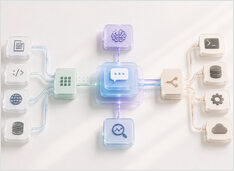
Как на самом деле создаются серьезные ассистенты.
Продолжающий работу ИИ-ассистент — это не «языковая модель с промптом». Это система, которая принимает намерения пользователя, сохраняет состояние, принимает решения о том, когда извлекать данные или выполнять действия, и предоставляет достаточно деталей времени выполнения для отладки сбоев.
ИИ меняет управление знаниями, а не его цель.
Искусственный интеллект не заменяет управление знаниями; он меняет его форму как для отдельных лиц, так и для команд.
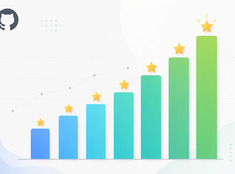
Звёзды, токены, загрузки — кто на самом деле побеждает?
Фреймворки AI-агентов с открытым исходным кодом стремительно набирают популярность на GitHub. Два проекта, лежащих в основе экосистемы самохостинг-систем ИИ — OpenClaw и Hermes Agent — настолько опередили остальных, что вся остальная ниша борется за отдаленное третье место.
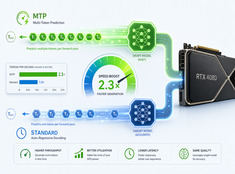
MTP и стандартная декодировка на RTX 4080 — реальные результаты тестов
Я протестировал производительность спекулятивного декодирования (Multi-Token Prediction, MTP) для моделей Qwen 3.6 27B и 35B на видеокарте RTX 4080 с 16 ГБ видеопамяти (VRAM).
Свободная VRAM без остановки llama-server
Режим маршрутизации llama.cpp — одно из самых полезных изменений в llama-server за последние годы. Наконец-то локальным операторам LLM предоставляется опыт управления моделями, близкий к тому, к которому пользователи привыкли в Ollama, при этом сохраняются высокая производительность и низкоуровневый контроль, которые делают llama.cpp стоящими того, чтобы использовать их в первую очередь.
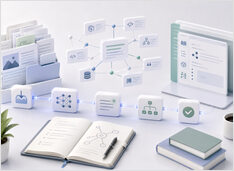
Скомпилированные знания для ИИ-систем
Основная идея проста: скомпилированные знания более пригодны для повторного использования, чем извлеченные фрагменты. RAG стал стандартным ответом на простой вопрос — как предоставить LLM доступ к внешним знаниям?
Перестаньте полагаться на интуицию. Валидируйте контракты.
Большинство руководств по «структурированному выводу» (structured output) для больших языковых моделей (LLM) не обладают должной серьезностью. Они учат вас вежливо просить модель выдавать JSON и затем надеяться, что она поступит правильно. Это не валидация. Это оптимизм, обернутый в фигурные скобки.