
Patrones de configuración de producción de OpenClaw con plugins y habilidades
Cómo están realmente estructurados los sistemas OpenClaw
OpenClaw parece simple en las demostraciones. En producción, se convierte en un sistema.
Cómo están realmente estructurados los sistemas OpenClaw
OpenClaw parece simple en las demostraciones. En producción, se convierte en un sistema.
Las suscripciones a Claude ya no impulsan agentes
La puerta trasera silenciosa que impulsó una ola de experimentación con agentes ahora está cerrada.
Búsqueda de IA autoalojada con LLMs locales
Vane es una de las entradas más pragmáticas en el espacio de “búsqueda de IA con citas”: un motor de respuestas autoalojado que combina la recuperación en tiempo real de la web con LLMs locales o en la nube, manteniendo toda la pila bajo tu control.
Programación con agentes, ahora con backends de modelos locales.
Claude Code no es autocompletado con mejor marketing. Es una herramienta de codificación agéntica: lee tu base de código, edita archivos, ejecuta comandos y se integra con tus herramientas de desarrollo.
Instalación y arranque rápido de Hermes Agent para desarrolladores
Hermes Agent es un asistente de IA autoalojado, agnóstico de modelos, que se ejecuta en una máquina local o en un VPS de bajo coste, funciona a través de interfaces de terminal y mensajería, y mejora con el tiempo al convertir tareas repetitivas en habilidades reutilizables.
Instala TGI, despliega rápido, depura más rápido.
Text Generation Inference (TGI) tiene una energía muy específica. No es el último en llegar en la calle de la inferencia, pero es el que ya aprendió cómo se rompen las cosas en producción -
Velocidad de tokens de llama.cpp con 16 GB de VRAM (tablas).
Aquí estoy comparando la velocidad de varios LLM que se ejecutan en una GPU con 16GB de VRAM, y eligiendo el mejor para autoalojar.
La RTX 5090 en Australia es escasa y sobrevalorada.
Australia tiene existencias de la RTX 5090. Escasamente. Y si encuentras una, pagarás un sobreprecio que parece desconectado de la realidad.
Acceso remoto a Ollama sin puertos públicos
Ollama funciona mejor cuando se trata como un demonio local: la CLI y sus aplicaciones se comunican con una API HTTP de bucle local, y el resto de la red nunca descubre su existencia.
Servidor de Ollama con enfoque en composición, GPU y persistencia.
Ollama funciona muy bien en hardware sin intermediarios (bare metal). Se vuelve aún más interesante cuando lo tratas como un servicio: un punto de conexión estable, versiones fijas, almacenamiento persistente y una GPU que está disponible o no está.
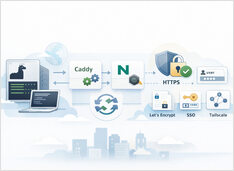
HTTPS con Ollama sin interrumpir las respuestas en streaming.
Ejecutar Ollama detrás de un proxy inverso es la forma más sencilla de obtener HTTPS, control de acceso opcional y un comportamiento de transmisión predecible.
Incrustaciones RAG: Python, Ollama y las APIs de OpenAI.
Si estás trabajando en generación aumentada con recuperación (RAG), esta sección explica los incrustados de texto (text embeddings) en términos sencillos: qué son, cómo se integran en la búsqueda y la recuperación, y cómo llamar a dos configuraciones locales comunes desde Python usando Ollama o una API HTTP compatible con OpenAI (como la que exponen muchos servidores basados en llama.cpp).
Sirva modelos abiertos rápidamente con SGLang.
SGLang es un marco de servicio de alto rendimiento para grandes modelos de lenguaje y modelos multimodales, diseñado para ofrecer inferencia de baja latencia y alto rendimiento en todo, desde una sola GPU hasta clústeres distribuidos.
Intercambia modelos LLM locales en caliente sin modificar los clientes.
Pronto estarás gestionando vLLM, llama.cpp y más—cada pila en su propio puerto. Todo lo que hay aguas abajo sigue requiriendo una única URL base /v1; de lo contrario, seguirás intercambiando puertos, perfiles y scripts de un solo uso. llama-swap es el proxy /v1 que se sitúa antes de esas pilas.
La mayoría de las configuraciones de IA locales comienzan con un modelo y un entorno de ejecución (runtime).
¿Qué sucede realmente cuando ejecutas Ultrawork?
Oh My Opencode promete un “equipo de desarrollo de IA virtual”: Sisyphus orquestando especialistas, tareas ejecutándose en paralelo y la palabra mágica ultrawork activando todo ello.