
Rendimiento de los LLM en 2026: Benchmarks, cuellos de botella y optimización
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.
Controla los datos y los modelos con LLMs autoalojados
El autoalojamiento de modelos de lenguaje grandes (LLM) mantiene los datos, los modelos y la inferencia bajo su control: una vía práctica hacia la soberanía de la IA para equipos, empresas y naciones.
Prueba de velocidad de LLM en RTX 4080 con 16 GB de VRAM
Ejecutar grandes modelos de lenguaje (LLM) localmente te ofrece privacidad, capacidad de funcionamiento sin conexión y cero costos de API. Esta benchmark revela exactamente lo que se puede esperar de 14 populares LLMs en Ollama en una RTX 4080.
Repositorios de Python en tendencia en octubre de 2026
El ecosistema de Python este mes está dominado por Claude Skills y herramientas de agentes de IA. Este análisis resume los repositorios de Python más populares en tendencia en GitHub.
Repositorios de Rust en tendencia de octubre de 2026
La página de tendencias de Rust este mes se lee como un mapa de la infraestructura de agentes: navegadores, entornos aislados (sandboxes), motores de búsqueda y capas de memoria diseñadas para agentes de IA, junto con establecidos marcos de trabajo para aplicaciones de escritorio y desarrollo de juegos. Esta presentación analiza los principales repositorios de Rust en tendencia en GitHub de este mes.
Repositorios de Go en tendencia de octubre de 2026
El ecosistema de Go continúa prosperando, y la lista de tendencias de este mes está fuertemente dominada por la infraestructura de agentes de IA. Esta descripción general analiza los principales repositorios de Go en tendencia en GitHub de este mes.
Alternativa autoalojada de ChatGPT para LLMs locales
Open WebUI es una potente, extensible y completa interfaz web autoalojada para interactuar con modelos de lenguaje de gran escala.
Instala, sirve y ajusta vLLM en 2026
vLLM es un motor de inferencia y servicio de alto rendimiento y eficiente en memoria para Modelos de Lenguaje Grandes (LLMs), desarrollado por el Sky Computing Lab de UC Berkeley.
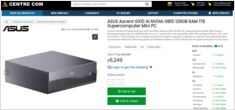
Precios reales en AUD de minoristas australianos ahora
El NVIDIA DGX Spark (GB10 Grace Blackwell) ya está disponible en Australia en los principales minoristas de PC con stock local. Si has estado siguiendo los precios y disponibilidad globales del DGX Spark, te interesará saber que los precios en Australia oscilan entre $6.249 y $7.999 AUD, dependiendo de la configuración de almacenamiento y del minorista.
Guía técnica para la detección de contenido generado por IA
La proliferación de contenido generado por IA ha creado un nuevo desafío: distinguir entre escritura humana auténtica y “IA slop” - texto sintético de baja calidad, producido en masa.
Pruebas de Cognee con LLMs locales - resultados reales
Cognee es un marco de Python para construir grafos de conocimiento a partir de documentos utilizando LLMs. ¿Pero funciona con modelos autohospedados?
Salidas de LLMs con verificación de tipos mediante BAML e Instructor
Al trabajar con modelos de lenguaje grandes (LLM) en producción, obtener salidas estructuradas y seguras en cuanto a tipos es fundamental. Dos marcos de trabajo populares, BAML e Instructor, adoptan enfoques diferentes para resolver este problema.
Reflexiones sobre LLMs para Cognee autohospedado
Elegir el Mejor LLM para Cognee requiere equilibrar la calidad de construcción de gráficos, las tasas de alucinación y las restricciones de hardware. Cognee destaca con modelos grandes de baja alucinación (32B+) a través de Ollama pero las opciones de tamaño medio funcionan para configuraciones más ligeras.
Crea agentes de búsqueda con IA en Python y Ollama
La librería de Python de Ollama ahora incluye capacidades nativas de búsqueda web de Ollama. Con solo unas pocas líneas de código, puedes enriquecer tus LLM locales con información en tiempo real de la web, reduciendo alucinaciones y mejorando la precisión.
Elija la base de datos vectorial adecuada para su pila RAG.
Elegir el almacén de vectores adecuado puede hacer o deshacer el rendimiento, el costo y la escalabilidad de tu aplicación RAG. Esta comparación integral cubre las opciones más populares en 2024-2025.
Construye agentes de búsqueda con IA usando Go y Ollama
La API de Búsqueda Web de Ollama permite aumentar los LLM locales con información web en tiempo real. Esta guía te muestra cómo implementar capacidades de búsqueda web en Go, desde llamadas API simples hasta agentes de búsqueda completos.