LLM

Ollama vs. vLLM vs. LM Studio: la mejor forma de ejecutar LLMs localmente en 2026.

Ollama vs. vLLM vs. LM Studio: la mejor forma de ejecutar LLMs localmente en 2026.

Compare las mejores herramientas de alojamiento local de LLM en 2026. Madurez de la API, soporte de hardware, tool calling y casos de uso reales.

Ejecutar LLMs localmente es ahora práctico para desarrolladores, startups e incluso equipos de empresa. Pero elegir la herramienta adecuada — Ollama, vLLM, LM Studio, LocalAI u otras — depende de tus objetivos:
Infraestructura de IA en hardware de consumo

Infraestructura de IA en hardware de consumo

Despliegue de IA empresarial en hardware económico con modelos abiertos

La democratización de la IA está aquí. Con modelos de lenguaje de gran tamaño (LLM) de código abierto como Llama, Mistral y Qwen rivalizando ahora con los modelos propietarios, los equipos pueden construir una infraestructura de IA utilizando hardware de consumo, reduciendo drásticamente los costos mientras mantienen el control total sobre la privacidad de los datos y el despliegue.

Ejecutar FLUX.1-dev GGUF Q8 en Python

Ejecutar FLUX.1-dev GGUF Q8 en Python

Acelere FLUX.1-dev con cuantización GGUF

FLUX.1-dev es un modelo poderoso de generación de imágenes a partir de texto que produce resultados asombrosos, pero su requisito de memoria de 24GB+ hace que sea difícil de ejecutar en muchos sistemas. GGUF quantization of FLUX.1-dev ofrece una solución, reduciendo el uso de memoria en aproximadamente un 50% mientras se mantiene una excelente calidad de imagen.

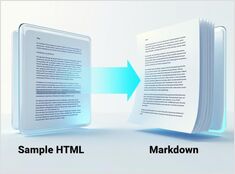
Convertir HTML a Markdown con Python: Una guía completa

Convertir HTML a Markdown con Python: Una guía completa

Python para convertir HTML en Markdown limpio y listo para LLM

Convertir HTML a Markdown es una tarea fundamental en los flujos de trabajo de desarrollo modernos, especialmente cuando se prepara contenido web para Modelos de Lenguaje Grande (LLMs), sistemas de documentación o generadores de sitios estáticos como Hugo. Esta guía forma parte de nuestro Herramientas de Documentación en 2026: Markdown, LaTeX, PDF y Flujos de Trabajo de Impresión centro.

Los ASICs de LLM y los chips especializados para inferencia (por qué son importantes)

Los ASICs de LLM y los chips especializados para inferencia (por qué son importantes)

Los ASIC y los circuitos de silicio personalizados aumentan la velocidad y la eficiencia de la inferencia de LLM.

El futuro de la IA no se trata solo de modelos más inteligentes, sino de modelos capaces de razonar. También se trata del silicio que se adapta a la forma en que esos modelos se sirven realmente. El hardware especializado para la inferencia de LLM sigue un camino reminiscente de la transición de la minería de Bitcoin de las GPU a las ASIC diseñadas a medida, solo que con restricciones más duras porque los modelos y las recetas de precisión continúan evolucionando.