
Claude, OpenClaw et la fin du prix unique pour les agents
Les abonnements à Claude n'alimentent plus les agents
La faille discrète qui a alimenté une vague d’expérimentation d’agents est désormais close.
Les abonnements à Claude n'alimentent plus les agents
La faille discrète qui a alimenté une vague d’expérimentation d’agents est désormais close.
Recherche d’IA auto-hébergée avec des LLM locaux
Vane est l’une des entrées les plus pragmatiques de l’espace de la « recherche IA avec citations » : un moteur de réponses auto-hébergé qui mêle la récupération web en direct avec des LLM locaux ou cloud, tout en gardant toute la pile sous votre contrôle.
Le codage agentique, désormais avec des backends de modèles locaux.
Claude Code n’est pas un simple autocomplétion avec un meilleur marketing. C’est un outil de codage agentique : il lit votre base de code, modifie des fichiers, exécute des commandes et s’intègre à vos outils de développement.
Installation et prise en main rapide de Hermes Agent pour les développeurs
L’Agent Hermes est un assistant IA auto-hébergé, agnostique quant au modèle, qui fonctionne sur une machine locale ou un VPS à faible coût. Il opère via des interfaces de terminal et de messagerie, et s’améliore au fil du temps en transformant les tâches répétitives en compétences réutilisables.
Installez TGI, déployez rapidement, déboguez encore plus vite.
Text Generation Inference (TGI) possède une énergie très particulière. Ce n’est pas le nouveau venu de la rue de l’inférence, mais c’est celui qui a déjà appris comment la production peut se briser -
Vitesse de génération des jetons de llama.cpp sur 16 Go de VRAM (tableaux).
Ici, je compare la vitesse de plusieurs LLMs exécutés sur GPU avec 16 Go de VRAM, et je choisis le meilleur pour l’auto-hébergement.
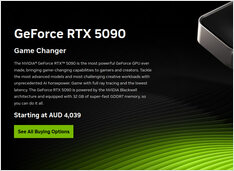
La RTX 5090 est rare et surcotée en Australie.
L’Australie dispose de stock pour la RTX 5090. À peine. Et si vous en trouvez une, vous paierez une prime qui semble déconnectée de la réalité.
Accès distant à Ollama sans ports publics
Ollama est à son meilleur lorsque l’on le traite comme un démon local : la CLI et vos applications communiquent avec une API HTTP en boucle locale (loopback), et le reste du réseau ignore son existence.
Serveur Ollama axé sur la composition, avec GPU et persistance.
Ollama fonctionne très bien sur du matériel nu. Cela devient encore plus intéressant lorsque vous la traitez comme un service : un point de terminaison stable, des versions épinglées, un stockage persistant et une carte graphique (GPU) qui est soit disponible, soit ne l’est pas.
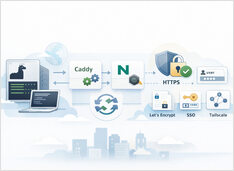
HTTPS Ollama sans interrompre les réponses en flux.
Exécuter Ollama derrière un proxy inversé est le moyen le plus simple d’obtenir HTTPS, un contrôle d’accès facultatif et un comportement de streaming prévisible.
Intégration RAG - Python, Ollama, API OpenAI.
Si vous travaillez sur la génération augmentée par récupération (RAG), cette section explique les incorporations de texte (text embeddings) en termes simples : ce qu’elles sont, comment elles s’intègrent dans la recherche et la récupération, et comment appeler deux configurations locales courantes depuis Python en utilisant Ollama ou une API HTTP compatible OpenAI (comme le font de nombreux serveurs basés sur llama.cpp).
Faites fonctionner rapidement les modèles ouverts avec SGLang.
SGLang est un framework de service haute performance pour les grands modèles de langage et les modèles multimodaux, conçu pour fournir une inférence à faible latence et à haut débit sur tout, d’une seule GPU à des clusters distribués.
Échange à chaud des LLM locaux sans modifier les clients.
Vous voilà bientôt à jongler avec vLLM, llama.cpp et d’autres composants — chaque pile sur son propre port. Tout en aval exige toujours une URL de base /v1 unique ; sinon, vous continuez à jongler avec des ports, des profils et des scripts spécifiques. llama-swap est le proxy /v1 situé devant ces piles.
La plupart des configurations locales d’IA commencent par un modèle et un runtime.
Que se passe-t-il réellement lorsque vous lancez Ultrawork.
Oh My Opencode promet une « équipe de développement IA virtuelle » : Sisyphus orchestre des spécialistes, les tâches s’exécutent en parallèle et le mot magique ultrawork active tout cela.
Faites la connaissance de Sisyphus et de son équipe d'agents spécialisés.
Le saut de capacité le plus important dans OpenCode provient des agents spécialisés : séparation délibérée de l’orchestration, de la planification, de l’exécution et de la recherche.