Ai

Ochronne mechanizmy dla LLM w praktyce: co naprawdę działa

Ochronne mechanizmy dla LLM w praktyce: co naprawdę działa

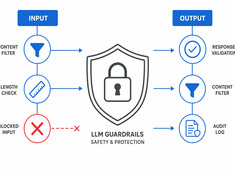
Kontroluj ryzyko, nie tylko model.

Modele językowe (LLM) są nieprzewidywalne. Mogą halucynować, wyciekać dane, generować szkodliwe treści lub odmawiać spełnienia legalnych żądań. Mechanizmy ochronne (guardrails) ograniczają zachowanie modelu, nie tracąc przy tym jego możliwości.
Optymalizacja kosztów w systemach LLM: gdzie naprawdę idą pieniądze

Optymalizacja kosztów w systemach LLM: gdzie naprawdę idą pieniądze

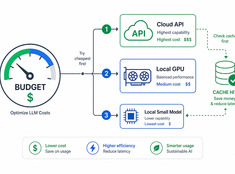
Wykorzystuj tokeny tam, gdzie naprawdę liczą się one najbardziej.

Koszt LLM-ów rośnie liniowo wraz z wolumenem używania. System przetwarzający 10 000 zapytań dziennie przy cenie 0,01 USD za zapytanie kosztuje 100 USD dziennie — 365 USD rocznie. W skali przedsiębiorstwa to ponad 10 000 USD.

Routerowanie modeli: przestań używać jednego modelu do wszystkiego

Routerowanie modeli: przestań używać jednego modelu do wszystkiego

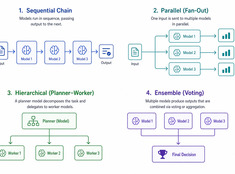
Dopasuj odpowiedni model do właściwego zadania.

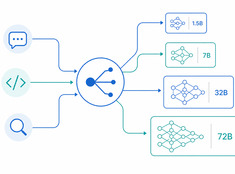
Uruchamianie modelu o 70 miliardach parametrów w celu podsumowania maila na 200 słów to marnotrawstwo. Używanie 3-miliardowego modelu do weryfikacji kodu produkcyjnego jest z kolei nieodpowiedzialne. Większość systemów funkcjonuje gdzieś pomiędzy tymi skrajnościami — i właśnie tutaj wchodzi model routing.

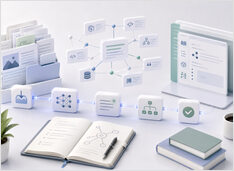
Systemy pamięci w asystentach AI

Systemy pamięci w asystentach AI

Pamięć robocza, strukturalna i odzyskiwania dla asystentów.

Pamięć zamienia asystentów w systemy trwałych, a nie tylko reaktywnych, ale to właśnie tam wiele systemów cichnie i podlega degradacji. Ankiety wskazują, że podział na pamięć krótkotrwałą i długotrwałą już nie wystarczy dla pamięci nowoczesnych agentów; SDK OpenAI i LangGraph wskazują na prostszy stos — pamięć roboczą, trwały stan i pobieranie danych (retrieval).

Usuń wszystkie modele routera llama.cpp bez restartowania

Usuń wszystkie modele routera llama.cpp bez restartowania

Darmowa pamięć VRAM bez zabijania llama-server.

Tryb routera w llama.cpp to jedna z najbardziej przydatnych zmian wprowadzonych do llama-server w ciągu ostatnich lat. Wreszcie daje lokalnym operatorom modeli LLM coś w rodzaju zarządzania modelami, do którego są przyzwyczajeni z Ollama, jednocześnie zachowując surową wydajność i kontrolę na niskim poziomie, która sprawia, że warto korzystać z llama.cpp w pierwszej kolejności.

Sterowanie głosem Hermes z telefonu

Sterowanie głosem Hermes z telefonu

Pozwól, by Hermes rozmawiał z Tobą przez telefon

Już teraz rozmawiasz z agentem Hermes przez telefon za pomocą wiadomości tekstowych. Teraz chcesz rozmawiać z nim bezpośrednio i otrzymywać odpowiedzi w formie mowy. Zazwyczaj jest to słuszny krok, zwłaszcza jeśli już korzystasz z Hermesa jako trwałego, lokalnie hostowanego asystenta. Pisanie długich promptów na małym ekranie jest powolne i podatne na błędy.