Ai

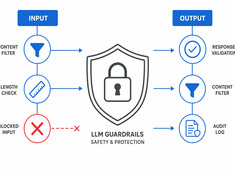
Guarda-redes para LLMs na Prática: O Que Realmente Funciona

Guarda-redes para LLMs na Prática: O Que Realmente Funciona

Controle o risco, não apenas o modelo.

Os LLMs são imprevisíveis. Eles alucinam, vazam dados, geram conteúdo prejudicial ou recusam solicitações legítimas. As barreiras de segurança (guardrails) restringem o comportamento do modelo sem sacrificar a capacidade.

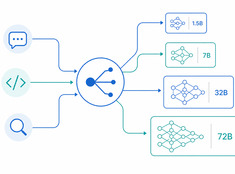
Roteamento de Modelos: Pare de usar um único modelo para tudo

Roteamento de Modelos: Pare de usar um único modelo para tudo

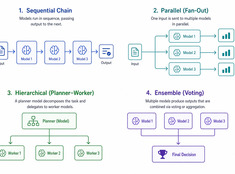
O modelo certo para a tarefa certa.

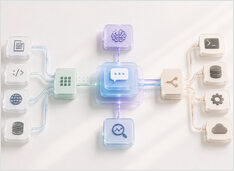
Executar um modelo com 70 bilhões de parâmetros para resumir um e-mail de 200 palavras é um desperdício. Executar um modelo de 3 bilhões para revisar código de produção é imprudência. A maioria dos sistemas vive em algum ponto intermediário — e é exatamente aí que entra o roteamento de modelos.

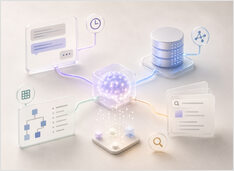
Sistemas de Memória em Assistentes de IA

Sistemas de Memória em Assistentes de IA

Memória de trabalho, estruturada e de recuperação para assistentes.

A memória transforma assistentes de reativos para persistentes, mas também é onde muitos sistemas se deterioram silenciosamente. Pesquisas argumentam que a divisão entre memória de curto e longo prazo já não é suficiente para a memória de agentes modernos; os SDKs da OpenAI e LangGraph apontam para uma pilha mais simples — memória de trabalho, estado durável e recuperação (retrieval).

Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB

Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB

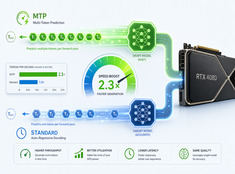
MTP vs. decodificação padrão na RTX 4080 — benchmarks reais

Testei o desempenho da decodificação especulativa (Previsão de Múltiplos Tokens, MTP) no Qwen 3.6 27B e 35B em uma RTX 4080 com 16 GB de VRAM.

PKM vs RAG vs Wiki vs Sistemas de Memória: Explicado com Clareza

PKM vs RAG vs Wiki vs Sistemas de Memória: Explicado com Clareza

Um mapa dos sistemas de conhecimento modernos

PKM, RAG, wikis, sistemas de memória de IA e, agora, fluxos de trabalho práticos assistidos por IA são frequentemente discutidos como se resolvessem o mesmo problema. Eles não o fazem. Todos lidam com conhecimento, mas operam em camadas diferentes:

Validação de Saída Estruturada de LLMs em Python que Funciona

Validação de Saída Estruturada de LLMs em Python que Funciona

Pare de interpretar vibes. Valide contratos.

A maioria dos tutoriais sobre “saída estruturada” de LLMs é superficial. Eles ensinam você a pedir JSON educadamente e depois torcer para que o modelo se comporte. Isso não é validação. Isso é otimismo com chaves.