Заметки, которые не теряют актуальности: составляйте заметки, которые приносят всё большую пользу с течением времени

Заметки, которые не теряют актуальности: составляйте заметки, которые приносят всё большую пользу с течением времени

Заметки, которые улучшаются, а не приходят в негодность.

Большинство инженерных заметок пишутся один раз и забываются. Вы фиксируете что-то во время отладки, вставляете это в какое-то место и находите через два года, не имея контекста, почему это было важно.
Проектирование многомоделевых систем: когда одной модели недостаточно

Проектирование многомоделевых систем: когда одной модели недостаточно

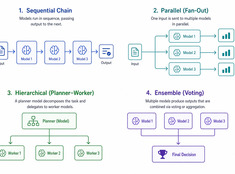
Выберите самый простой работающий паттерн.

Системы с одной моделью просты. Системы с несколькими моделями мощны. Сложность заключается не в выборе моделей, а в проектировании архитектуры, которая ими управляет.

Оптимизация затрат в системах LLM: куда реально уходят деньги

Оптимизация затрат в системах LLM: куда реально уходят деньги

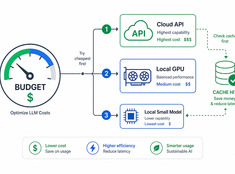
Тратьте токены там, где это действительно важно.

Стоимость LLM растёт линейно в зависимости от объёма использования. Система, обрабатывающая 10 000 запросов в день по цене 0,01 долл. за запрос, обходится в 100 долл. ежедневно — 365 долл. в год. В масштабах предприятия это превышает 10 000 долл.

Маршрутизация моделей: перестаньте использовать одну модель для всего

Маршрутизация моделей: перестаньте использовать одну модель для всего

Правильная модель для правильной задачи.

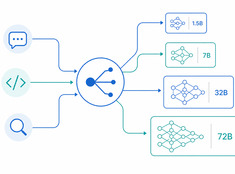
Запуск модели с 70 миллиардами параметров для суммаризации электронного письма из 200 слов — это расточительство. Запуск модели с 3 миллиардами параметров для ревью продакшн-кода — это безрассудство. Большинство систем находятся где-то посередине, и именно здесь в игру вступает роутинг моделей (маршрутизация запросов).

LLM Guardrails на практике: что действительно работает

LLM Guardrails на практике: что действительно работает

Управляйте риском, а не только моделью.

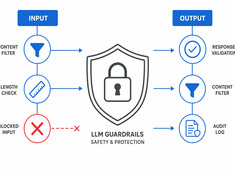
Языковые модели (LLM) непредсказуемы. Они галлюцинируют, утекают данные, генерируют вредоносный контент или отказывают в выполнению легитимных запросов. Ограничители (guardrails) constraining поведение модели без ущерба для её возможностей.

Системы памяти в ИИ-ассистентах

Системы памяти в ИИ-ассистентах

Рабочая, структурная и поисковая память для ассистентов.

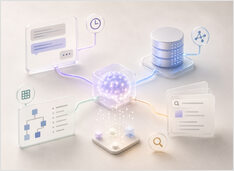
Память превращает ассистентов из реактивных в персистентные, но именно в ней множество систем тихо деградируют. Исследования утверждают, что разделения на краткосрочную и долгосрочную память больше недостаточно для современных агентных систем памяти; SDK от OpenAI и LangGraph указывают на более простую стек-модель — рабочая память, персистентное состояние и поиск (retrieval).

Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

Как на самом деле создаются серьезные ассистенты.

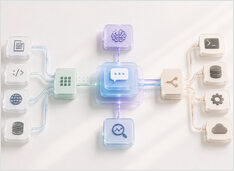
Продолжающий работу ИИ-ассистент — это не «языковая модель с промптом». Это система, которая принимает намерения пользователя, сохраняет состояние, принимает решения о том, когда извлекать данные или выполнять действия, и предоставляет достаточно деталей времени выполнения для отладки сбоев.

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

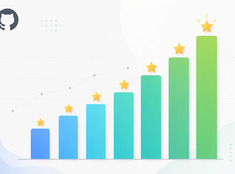
Звёзды, токены, загрузки — кто на самом деле побеждает?

Фреймворки AI-агентов с открытым исходным кодом стремительно набирают популярность на GitHub. Два проекта, лежащих в основе экосистемы самохостинг-систем ИИ — OpenClaw и Hermes Agent — настолько опередили остальных, что вся остальная ниша борется за отдаленное третье место.

Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ

Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ

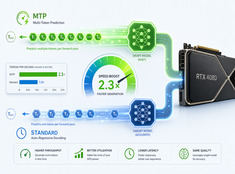
MTP и стандартная декодировка на RTX 4080 — реальные результаты тестов

Я протестировал производительность спекулятивного декодирования (Multi-Token Prediction, MTP) для моделей Qwen 3.6 27B и 35B на видеокарте RTX 4080 с 16 ГБ видеопамяти (VRAM).

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Свободная VRAM без остановки llama-server

Режим маршрутизации llama.cpp — одно из самых полезных изменений в llama-server за последние годы. Наконец-то локальным операторам LLM предоставляется опыт управления моделями, близкий к тому, к которому пользователи привыкли в Ollama, при этом сохраняются высокая производительность и низкоуровневый контроль, которые делают llama.cpp стоящими того, чтобы использовать их в первую очередь.

Получение данных против репрезентации в системах знаний

Получение данных против репрезентации в системах знаний

Поиск — это не структура знаний

Большинство современных систем знаний оптимизируют процесс поиска, и это вполне понятно. Поиск нагляден, его легко продемонстрировать, и он кажется магией, когда работает. Введи вопрос — получи ответ.

LLM Wiki: систематизированные знания, которые невозможно заменить с помощью RAG

LLM Wiki: систематизированные знания, которые невозможно заменить с помощью RAG

Скомпилированные знания для ИИ-систем

Основная идея проста: скомпилированные знания более пригодны для повторного использования, чем извлеченные фрагменты. RAG стал стандартным ответом на простой вопрос — как предоставить LLM доступ к внешним знаниям?

PKM, RAG, Wiki и системы памяти: чёткое объяснение

PKM, RAG, Wiki и системы памяти: чёткое объяснение

«Карта современных систем знаний»

PKM, RAG, вики, системы памяти ИИ и сейчас практические рабочие процессы с помощью ИИ часто обсуждаются так, будто они решают одну и ту же проблему. Это не так. Все они имеют дело с знаниями, но работают на разных уровнях:

«Вторая голова. Объяснение для инженеров и работников интеллектуального труда»

«Вторая голова. Объяснение для инженеров и работников интеллектуального труда»

Заметки — это хранилище. Второй мозг — это вычисление.

Информационная перегрузка связана не столько с огромным объемом данных, сколько с нерешенными входящими потоками информации. Современная интеллектуальная работа оставляет за собой след из открытых вкладок, чатов, документов, выделенных фрагментов, цитат, транскриптов, скриншотов и недописанных заметок.

Подписаться

Получайте новые материалы про системы, инфраструктуру и AI engineering.