AI

Обзор агента Pi Coding: минималистичный CLI для AI-кодинга с возможностью кастомизации

Обзор агента Pi Coding: минималистичный CLI для AI-кодинга с возможностью кастомизации

«Небольшой агент для программирования, который требует, чтобы вы его настраивали».

Pi Coding Agent — это минималистичный, открытый терминальный каркас для программирования, который поставляется с четырьмя инструментами по умолчанию и оставляет большую часть поведения на усмотрение расширений, навыков и вашего собственного рабочего процесса.
Гравитация данных: реальная стоимость API-first ИИ

Гравитация данных: реальная стоимость API-first ИИ

«Почему ваш AI-стек становится всё более «липким» каждый месяц»

Каждый вызов API кажется простой транзакцией - пока их накопится достаточно много, и ваши данные для дообучения, системы оценки и схемы инструментов не начнут формироваться вокруг одного вендора, после чего смена провайдера перестанет быть простой сменой маршрутизации.

Subагенты Claude Code: настройка, конфигурация и сценарии использования

Subагенты Claude Code: настройка, конфигурация и сценарии использования

Делегируйте шумные задачи, сохраняйте контекст чистым.

Большинство сессий Claude Code становятся медленными и загроможденными по одной и той же причине: каждый исследовательский grep, каждый дамп логов и каждое «подождите, я проверю еще один файл» навсегда остаются в основном разговоре.

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

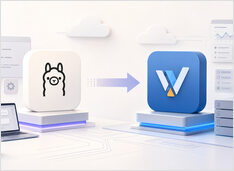
Когда переходить с Ollama на vLLM

Ollama — один из самых простых способов запуска локальной языковой модели, но удобство может скрывать момент, когда локальный эксперимент превращается в общий сервис инференса, требующий лучшего планирования и наблюдаемости.

Обслуживание LLM Wiki: дрейф, противоречия и рецензирование

Обслуживание LLM Wiki: дрейф, противоречия и рецензирование

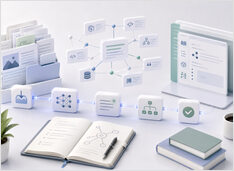
Обеспечьте достоверность скомпилированных знаний

Неудача в использовании LLM Wiki наступает тогда, когда старые факты остаются правдоподобными, противоречия становятся гладкими, а сгенерированные резюме отдаляются от своих источников.

GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

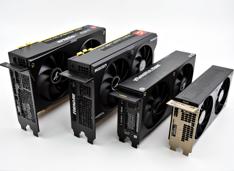
Сравнение AI-GPU от трёх производителей

Ландшафт аппаратных решений для ИИ значительно изменился в 2026 году: NVIDIA, AMD и Intel соревнуются за разработчиков, которым требуются GPU, способные запускать локальные большие языковые модели (LLM) и выполнять задачи инференса.

Агент Hermes: настройка безголового сервера и удалённого рабочего стола

Агент Hermes: настройка безголового сервера и удалённого рабочего стола

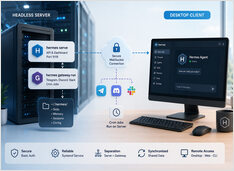
Сервер Headless Hermes с доступом по удаленному рабочему столу

Запуск агента Hermes на сервере без графического интерфейса (headless) при подключении с настольного клиента на другом компьютере требует наличия двух процессов на сервере и одного клиентского соединения.

Безопасность агентов A2A и MCP: идентификация, делегирование и журналы аудита

Безопасность агентов A2A и MCP: идентификация, делегирование и журналы аудита

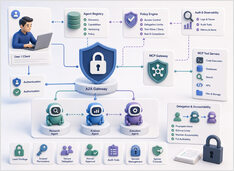
Безопасность протокола определяет, кто может действовать, а не модель.

Инъекция промптов привлекает основное внимание в области безопасности систем на базе больших языковых моделей (LLM), и это заслужено, но это не вся проблема, когда агенты начинают вызывать инструменты и делегировать работу другим агентам.

A2A-стриминг и асинхронные задачи для длительных агентных рабочих процессов

A2A-стриминг и асинхронные задачи для длительных агентных рабочих процессов

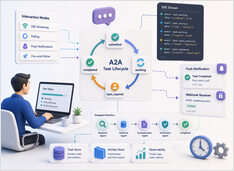
Долгоживущие A2A-задачи продолжают существовать после завершения чат-сессий.

Большинство демонстраций AI-агентов по-прежнему ведут себя как чат-завершения с дополнительными шагами: вы отправляете промпт, ждете несколько секунд и получаете ответ в одном сообщении.

Спекулятивное декодирование: ускорение инференса LLM на 20–50%

Спекулятивное декодирование: ускорение инференса LLM на 20–50%

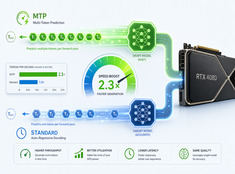
Более быстрый инференс LLM без потери качества — практическое руководство

Модель 70B генерирует один токен за один прямой проход (forward pass), и каждый проход перезагружает веса из видеопамяти (VRAM), вычисляет внимание (attention) для всего контекста и синхронизирует память. Между токенами GPU простаивает, ожидая разрешения последовательных зависимостей.

Что такое протокол A2A? Разбираем Agent Cards и Tasks

Что такое протокол A2A? Разбираем Agent Cards и Tasks

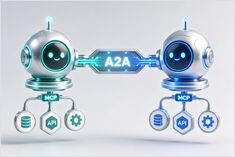
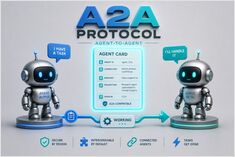
A2A превращает агентов в равноправных участников сети.

Протокол A2A (Agent-to-Agent Protocol), аббревиатура от Agent2Agent Protocol, представляет собой открытый стандарт для взаимодействия между независимыми системами ИИ-агентов.

LLM Guardrails на практике: что действительно работает

LLM Guardrails на практике: что действительно работает

Управляйте риском, а не только моделью.

Языковые модели (LLM) непредсказуемы. Они галлюцинируют, утекают данные, генерируют вредоносный контент или отказывают в выполнению легитимных запросов. Ограничители (guardrails) constraining поведение модели без ущерба для её возможностей.