Self-Hosting

Практическое руководство NemoClaw по безопасным операциям с OpenClaw в 2026 году

Практическое руководство NemoClaw по безопасным операциям с OpenClaw в 2026 году

Запускайте OpenClaw безопасно с помощью NemoClaw

Большинство стеков ИИ-агентов по-прежнему рассматривают безопасность как проблему, которую нужно решать после демонстрации. NemoClaw исходит из противоположного предположения и делает изоляцию, политики и маршрутизацию настройками по умолчанию с первого дня.
Управление знаниями в 2026 году: инструменты PKM, самохостинговые вики и цифровые системы

Управление знаниями в 2026 году: инструменты PKM, самохостинговые вики и цифровые системы

Сравнение инструментов, методов и самохостинговых вики для персонального управления знаниями

Управление персональными знаниями охватывает Obsidian, Logseq, DokuWiki, Zettelkasten и PARA — правильный выбор зависит от того, хотите ли вы локальный граф заметок, собственный вики-движок или рабочий процесс, основанный на аутлайнерах.

Быстрый старт с Vane (Perplexica 2.0) с использованием Ollama и llama.cpp

Быстрый старт с Vane (Perplexica 2.0) с использованием Ollama и llama.cpp

Самохостинговый ИИ-поиск с локальными LLM

Vane — один из наиболее прагматичных проектов в сегменте «AI-поиск со ссылками на источники»: самохостингуемый движок ответов, который сочетает живой веб-поиск с локальными или облачными LLM, сохраняя при этом полный контроль над всем стеком за вами.

TGI — Text Generation Inference: установка, настройка и устранение неполадок

TGI — Text Generation Inference: установка, настройка и устранение неполадок

Установите TGI, развертывайте быстро, отлаживайте ещё быстрее.

Text Generation Inference (TGI) обладает очень специфической энергетикой. Это не самый новый проект на улице инференса, но это тот, который уже научился, как происходит работа в продакшене, —

Удалённый доступ к Ollama через Tailscale или WireGuard без открытия публичных портов.

Удалённый доступ к Ollama через Tailscale или WireGuard без открытия публичных портов.

Доступ к Ollama удаленно без открытых публичных портов

Ollama чувствует себя наиболее комфортно, когда с ним обращаются как с локальным демоном: CLI и ваши приложения взаимодействуют с локальным HTTP-интерфейсом (loopback), а остальная сеть даже не знает о его существовании.

Ollama в Docker Compose с поддержкой GPU и постоянным хранением моделей

Ollama в Docker Compose с поддержкой GPU и постоянным хранением моделей

Сервер Ollama с приоритетом композиции, поддержкой GPU и сохранением данных.

Ollama отлично работает на «голом железе». Всё становится ещё интереснее, когда вы начинаете относиться к нему как к сервису: стабильный эндпоинт, закреплённые версии, постоянное хранилище данных и GPU, который либо доступен, либо нет.

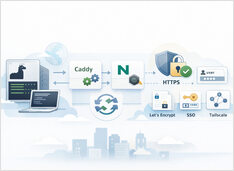
Ollama за обратным прокси-сервером Caddy или Nginx для потоковой передачи через HTTPS

Ollama за обратным прокси-сервером Caddy или Nginx для потоковой передачи через HTTPS

HTTPS для Ollama без нарушения потоковой передачи ответов.

Запуск Ollama через обратный прокси — самый простой способ обеспечить поддержку HTTPS, опциональный контроль доступа и предсказуемое поведение потоковой передачи данных.

Векторные представления текста для RAG и поиска — Python, Ollama, совместимые с API OpenAI

Векторные представления текста для RAG и поиска — Python, Ollama, совместимые с API OpenAI

Встраивания для RAG — Python, Ollama, API OpenAI.

Если вы работаете с генерацией с расширением поиска (RAG), этот раздел объясняет векторные представления текста (эмбеддинги) простым языком: что это такое, как они работают в поиске и извлечении данных, и как вызывать два распространенных локальных режима из Python с помощью Ollama или OpenAI-совместимого HTTP API (так как многие серверы на базе llama.cpp поддерживают такой интерфейс).

Что такое IndexNow: уведомляйте поисковые системы при публикации контента

Что такое IndexNow: уведомляйте поисковые системы при публикации контента

Отправляйте обновленные URL-адреса в поисковые системы после развертывания.

Статические сайты и блоги меняются при каждой деплойке. Поисковые системы, поддерживающие IndexNow, могут узнать об этих изменениях, не дожидаясь следующего слепого сканирования.

Быстрый старт SGLang: установка, настройка и развертывание больших языковых моделей через API OpenAI

Быстрый старт SGLang: установка, настройка и развертывание больших языковых моделей через API OpenAI

Запускайте открытые модели быстро с помощью SGLang.

SGLang — это высокопроизводительный фреймворк для развертывания больших языковых и мультимодальных моделей, созданный для обеспечения низколатентного и высокопроизводительного вывода на устройствах от одной GPU до распределенных кластеров.

Быстрый старт Apache Kafka — установка Kafka 4.2 с помощью CLI и локальные примеры

Быстрый старт Apache Kafka — установка Kafka 4.2 с помощью CLI и локальные примеры

Установите Kafka 4.2 и начните потоковую обработку событий за считанные минуты.

Apache Kafka 4.2.0 — это текущая поддерживаемая ветка релизов, и она является лучшей отправной точкой для современного быстрого старта, поскольку Kafka 4.x полностью работает без ZooKeeper и по умолчанию построена вокруг KRaft.

Быстрый старт с обменом моделей llama для локальных LLM, совместимых с OpenAI

Быстрый старт с обменом моделей llama для локальных LLM, совместимых с OpenAI

Горячая замена локальных LLM без изменения клиентов.

Вскоре вы уже управляете несколькими инструментами: vLLM, llama.cpp и другими — каждый стек работает на своём собственном порту. При этом все последующие звенья цепочки по-прежнему ожидают один базовый URL /v1; иначе вам придётся постоянно перенастраивать порты, профили и разовые скрипты. llama-swap — это прокси для /v1, который размещается перед этими стеками.

Обзор Opencode: честные результаты, риски биллинга и когда это того стоит

Обзор Opencode: честные результаты, риски биллинга и когда это того стоит

Что происходит на самом деле при запуске Ultrawork.

Oh My Opencode обещает «виртуальную команду AI-разработчиков» — Сизиф координирует специалистов, задачи выполняются параллельно, а волшебное ключевое слово ultrawork активирует всё это.