
Architektur von KI-Assistenten: LLM, Memory, Tools, Routing, Observability
Wie ernsthafte Assistenten tatsächlich aufgebaut sind.
Ein produktionsreifes KI-Assistenzsystem ist nicht „ein LLM mit einem Prompt“. Es ist ein System, das Absicht akzeptiert, Zustand behält, entscheidet, wann es Informationen abrufen oder Aktionen ausführen soll, und genügend Laufzeitdetails offenlegt, um Fehlfunktionen zu debuggen.
Diese systemische Perspektive wird im KI-Systeme-Bereich erforscht, wenn Assistenten über eine einzelne Modellaufruf-Ebene hinauswachsen.
OpenAI beschreibt Agenten als Anwendungen, die planen, Tools aufrufen, zusammenarbeiten und genügend Zustand für mehrstufige Aufgaben beibehalten, während Anthropic das gleiche Problem als gemanagtes Gerüst (Harness) rahmt, das Dateien, Befehle, Webzugriff und Code sicher ausführen kann.
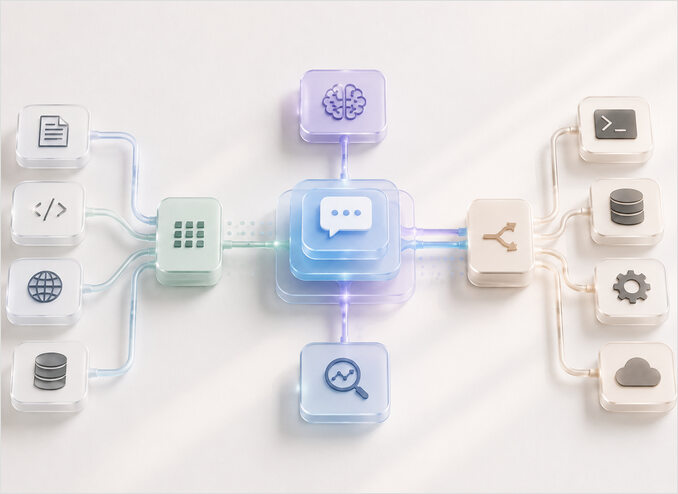
Die sauberste Architektur trennt die Zuständigkeiten in fünf Ebenen auf: LLM, Gedächtnis, Tooling, Routing und Observability. Diese Aufteilung entspricht den Funktionen, die von großen Anbieter-APIs, von MCP, von selbst gehosteten Laufzeitumgebungen wie vLLM und llama.cpp sowie von tatsächlichen Assistentensystemen wie OpenClaw und Hermes bereitgestellt werden.
Gedächtnis sollte als mehr behandelt werden als „längerer Kontext“. Abrufsysteme (Retrieval Systems) wandeln externes Wissen in explizites nicht-parametrisches Gedächtnis um – denselben Designraum, der in [Retrieval-Augmented Generation (RAG)](https://www.glukhov.org/de/rag/ “Schritt-für-Schritt-RAG-Tutorial: Bauen Sie Retrieval-Augmented-Generation-Systeme mit Vektordatenbanken, hybrider Suche, Reranking und Websuche. Architektur, Implementierung und Best Practices für die Produktion.”}) eingehend behandelt wird – und sowohl die Kontextleitfäden von Anthropic als auch der Paper „Lost in the Middle“ warnen davor, dass bloßes Stopfen von mehr Tokens in den Kontext keinen zuverlässigen Abruf garantiert.
Der Einsatz von Tools ist eine Vertragsgrenze, keine Magie. OpenAI Function Calling, Anthropic Tool Use und MCP stützen sich alle auf denselben Mechanismus: Das Modell gibt eine strukturierte Anfrage aus, eine Laufzeitumgebung führt sie aus und das Ergebnis fließt in das Gespräch zurück. Wenn diese Grenze schlampig gehandhabt wird, wird der Assistent schlampig.
Meine Neigung ist einfach: Beginnen Sie langweilig. Ein Orchestrierer, ein dauerhafter Speicherpfad, ein Trace pro Anfrage und eine explizite Richtlinie für die Tool-Ausführung. Multi-Agenten-Graphen sind nützlich, aber erst dann, wenn Sie Ihre Single-Agent-Fehlfälle ohne Ratelei erklären können.
Was ein KI-Assistentensystem ist
Eine praktische Definition lautet: Ein KI-Assistentensystem ist eine Laufzeitumgebung, die Nutzerabsicht in eine Antwort oder Aktion umwandelt, indem sie eine Modell-Schnittstelle, Kontextzusammenstellung, Tool-Ausführung, Zustandsverwaltung und Telemetrie kombiniert. Deshalb sind die nützlichen Dokumente nicht nur Modellbeschreibungen. Die nützlichen Dokumente sind API-Referenzen, Tool-Verträge, Abruf-Leitfäden, Routing-Dokumentationen und Tracing-Dokumentationen. Die Responses API von OpenAI bietet zustandsbehaftete Interaktionen, integrierte Tools und Function Calling. Die Claude API von Anthropic bietet sowohl direkten Messages-Zugang als auch Managed Agents. OpenClaw und Hermes gehen einen Schritt weiter und zeigen, was passiert, wenn man diese Fähigkeiten hinter persistenten Gateways, Kanälen, Sitzungen und Gedächtnis platziert.
Anders gesagt hat ein Assistentensystem einen breiteren Vertrag als eine Chat-Vervollständigung. Ein guter interner Vertrag könnte wie folgt aussehen:
AssistantRequest  = Nutzerabsicht + Identität + Sitzung + Anhänge + Richtlinie
AssistantResponse = Antwort + Aktionen + Zitate + Zustandsänderungen + Trace-ID
Dieser Vertrag ist wichtig, weil jede produktionsbezogene Diskrepanz am Ende auf eine dieser Fragen hinausläuft: Welcher Kontext war sichtbar, welches Tool wurde ausgeführt, welches Modell antwortete, welches Gedächtnis wurde gelesen oder geschrieben und wo sagt der Trace, wo das System Zeit verbracht hat. OpenTelemetry definiert Traces als den Pfad einer Anfrage durch eine Anwendung, was genau die Abstraktion ist, die ernsthafte Assistenten benötigen. LangSmith und OpenLIT spezialisieren diese Idee dann für LLMs, Tools, Vektorspeicher und Agenten-Workflows.
Kernkomponenten und Schnittstellen
Die nachfolgende Komponentenaufteilung ist die, die ich als am haltbarsten empfinde. Sie ist auch die Aufteilung, die am besten mit den offiziellen APIs und den Open-Source-Laufzeitumgebungen übereinstimmt, die Menschen tatsächlich betreiben.
| Ebene | Hauptverantwortung | Typische Schnittstelle | Beispiel-Technologien |
|---|---|---|---|
| LLM-Ebene | Denken, generieren, entscheiden, strukturierte Aufrufe ausgeben | Responses API, Messages API, OpenAI-kompatible oder Anthropic-kompatible Endpunkte | OpenAI, Anthropic, vLLM, llama.cpp, Ollama |
| Gedächtnisebene | Sitzungsstatus, dauerhafte Notizen und durchsuchbares Wissen bewahren | Embeddings, Vektorsuche, Speicherleseauf-/-schreibtools, Abruf-APIs | OpenAI-Embeddings und Vektorspeicher, Pinecone, Weaviate, pgvector, Milvus, Hermes-Gedächtnis, OpenClaw-Gedächtnis |
| Tooling-Ebene | Daten außerhalb des Modells lesen und Aktionen ausführen | JSON-Schema-Tools, MCP-Tools, Datei- und Websuche, native Laufzeit-Tools | OpenAI Function Calling, Anthropic Tool Use, MCP, LangChain-Tools, LlamaIndex-Query-Tools |
| Routing-Ebene | Modell, Backend, Richtlinie und Tenant-Pfad auswählen | Modell-Aliase, Failover-Gruppen, Health-Checks, Budgets, Kanal-Bindings | LiteLLM, OpenClaw-Multi-Agenten-Routing, Hermes-Provider-Laufzeit-Auflösung |
| Observability | Erklären, was passiert ist und warum | Traces, Spans, Logs, Metriken, Eval-Läufe | OpenTelemetry, LangSmith, OpenLIT |
Die obige Tabelle basiert auf den offiziellen Anbieter-Schnittstellen, MCP, Vektordatenbank-Dokumentationen und den Laufzeit-Dokumentationen für vLLM, llama.cpp, OpenClaw und Hermes.
Die LLM-Ebene sollte drei Dinge gut können: den aktuellen Arbeitskontext konsumieren, entweder eine finale Antwort oder eine strukturierte Aktionsanfrage ausgeben und genügend Metadaten zurückgeben, um Wiederholungen und Tracing zu unterstützen. Die Responses API von OpenAI ist explizit für zustandsbehaftete Interaktionen plus integrierte Tools und Function Calling konzipiert. Die Messages API von Anthropic stellt dieselbe Kernschleife über tool_use-Blöcke und tool_result-Rückgaben bereit, während Managed Agents ein gehostetes Gerüst bieten, wenn man die Schleife nicht selbst bauen möchte. Selbst gehostete Laufzeitumgebungen wie vLLM und llama.cpp sind wichtig, weil sie vertraute anbieterseitige Schnittstellen beibehalten, während sie es erlauben, Inferenzen in der eigenen Umgebung zu platzieren.
Die Gedächtnisebene sollte gedanklich in drei Buckets aufgeteilt werden: Arbeitsgedächtnis, dauerhafter symbolisches Gedächtnis und durchsuchbares semantisches Gedächtnis. OpenAI-Embeddings liefern Vektoren, die indexiert und durchsucht werden können; OpenAI Retrieval und File Search legen semantische und Keyword-Suche auf Vektorspeicher ab. Pinecone, Weaviate, pgvector und Milvus repräsentieren vier gängige Speicherformen: voll gemanagt, Open-Source-Vektor-nativ, Postgres-nativ und verteilte Vektordatenbank. Hermes und OpenClaw liefern einen nützlichen Hinweis, dass nicht alles Gedächtnis in einen Vektorspeicher gehört: dateibasierte Notizen, geprüfte Promotionen und sitzungsbezogene Snapshots sind oft der ehrlichere Designansatz. Gedächtnissysteme in KI-Assistenten kartografiert das Cross-Framework-Modell; Hermes Agent Memory System erläutert begrenztes Kerngedächtnis und eingefrorene Sitzungssnapshots in einem Produkt.
Die Tooling-Ebene ist der Ort, an dem ein Assistent aufhört, nur ein Zusammenfasser zu sein, und anfängt, Software zu werden. OpenAI Function Calling betrachtet Tools als schemabasierte Funktionalität, die das Modell aufrufen kann. Anthropic sagt dies noch expliziter: Tool-Use ist ein Vertrag zwischen Ihrer Anwendung und dem Modell, und das Modell führt niemals eigenständig etwas aus. MCP verallgemeinert diesen Vertrag in ein Client-Server-Protokoll, bei dem Hosts mit einem oder mehreren Servern verbunden sind, die Tools, Prompts und Ressourcen bereitstellen – dieselbe Grenze, die in MCP Server in Go Schritt für Schritt beschrieben wird. LangChain und LlamaIndex sitzen bequem hier als Orchestrierungsbibliotheken: LangChain konzentriert sich auf eine vordefinierte Agentenarchitektur und Integrationen, während LlamaIndex sich auf kontextergänzenden Datenzugriff, Query-Engines und Workflows konzentriert.
Die Routing-Ebene existiert, weil „welches Modell?“ nie die einzige Frage ist. Man benötigt auch „welcher Pfad des Providers, welcher Tenant, welches Budget, welche Latenzklasse und welches Fallback?“. LiteLLM ist nützlich, weil seine offiziellen Doku refreshend konkret sind: gewichtete Auswahl, wenigste Auslastung, latenzbasiertes, kostengestütztes Routing und begrenzte Failovers sind alles First-Class-Patterns. OpenClaw erweitert das Routing nach oben hin in Kanal- und Agenten-Isolation, während Hermes es nach unten hin in Modell-Slots für Haupt- und Hilfsarbeit wie Zusammenfassung, Kontextkompression und MCP-Tool-Routing ausdehnt. Das ist das richtige mentale Modell: Der Router wählt mehr als ein Modell, er wählt eine Ausführungsspur.
Die Observability-Ebene verhindert, dass Architektur zu Folklore wird. OpenTelemetry liefert die Trace-Abstraktion. LangSmith bietet End-to-End-Sichtbarkeit über LLM-Anwendungsschritte und unterstützt Cloud-, Hybrid- und Self-Hosted-Deployments. OpenLIT bietet OpenTelemetry-native KI-Observability mit Zero-Code- und manueller Instrumentierungsoptionen, einschließlich Unterstützung für LLMs, Agenten-Frameworks, Vektordatenbanken und GPUs. Für Produktionsmetriken, Traces und SLO-Patterns über Inferenz- und Agenten-Workflows hinweg siehe Observability für LLM-Systeme. Wenn Ihr Assistent keinen Trace pro Anfrage, keinen Span pro Modellaufruf und keine Ereignishistorie für die Tool-Ausführung hat, haben Sie noch keine echte Architektur. Sie haben Vibrationen.
Erfassen, anreichern, antworten
Die Sequenz, die in echten Systemen immer wieder auftaucht, ist erfassen -> anreichern -> antworten -> protokollieren. Verschiedene Frameworks kapseln dies unterschiedlich, aber der Fluss ist stabil genug, um als Rückgrat zu gelten.
Der Erfassen-Schritt ist meist wichtiger, als er aussieht. OpenClaw und Hermes platzieren beide ein persistentes Gateway vor dem Assistenten, weil der Eingang (Ingress) nicht nur Texteingabe ist. Er umfasst Kanalmetadaten, Identitäten, Autorisierung, Sitzungsgränzen, Direktnachrichten, Gruppen, Cron-Ticks und Liefersemantiken. Wenn man diese Ebene überspringt und sich auf eine rohe Chat-Widget-Abstraktion verlässt, wird man sie am Ende ohnehin als Ad-hoc-Middleware wieder anbauen.
Der Anreichern-Schritt ist der Ort, an dem reife Systeme von Spielzeug-Demos abweichen. OpenAI Retrieval und File Search machen den Abruf explizit über Vektorspeicher und Suchaufrufe. LlamaIndex formalisiert dasselbe Muster über Datenconnectoren, Indizes, Query-Engines und Workflows. Hermes geht weiter, indem es das Modellvermögen in Haupt- und Hilfs-Slots aufteilt und Arbeit wie Kompression, Zusammenfassung und Routing auf kleinere oder spezialisierte Modelle auslagert. Das ist ein Design-Muster, das man sich aneignen sollte: Verbrauchen Sie keine tokens Ihres teuersten Modells für Routineaufgaben.
Der Antworten-Schritt ist nicht „Text generieren“. Er ist „aktuelle Schleife schließen“. Wenn das Modell direkt antworten kann, tut es das. Wenn es ein Tool benötigt, gibt es eine strukturierte Anfrage aus. Der Tool-Use-Vertrag von Anthropic und der Function-Calling-Leitfaden von OpenAI machen dies explizit. Der Grund, warum dies architektonisch wichtig ist, liegt darin, dass Ausgaben nun sowohl Sprache als auch Steuerfluss umfassen. Ihr Response-Objekt ist teilweise Prosa und teilweise Laufzeitplan.
Der Protokollieren-Schritt ist der Ort, an dem Konsistenzsemantiken auftauchen. Pinecone trennt Schreib- und Lesewege und verarbeitet Schreibvorgänge nach beständiger Bestätigung. Das Hermes-Gedächtnis wird als eingefrorener Snapshot pro Sitzung injiziert, damit die Präfix-Cache-Performance erhalten bleibt, was bedeutet, dass neue Schreibvorgänge nicht automatisch im aktuellen Sitzungskontext erscheinen. Das Dreaming-System von OpenClaw fördert nur geprüfte, fundierte Kandidaten in MEMORY.md, und es ist opt-in und nicht immer aktiv. Die praktische Lektion ist, dass Gedächtnis selten wirklich read-after-write über jede Ebene hinweg ist. Man muss für gestufte Sichtbarkeit designen.
OpenClaw und Hermes als Referenzsysteme
OpenClaw und Hermes sind nützliche Referenzfälle, weil sie nicht nur Wrapper um eine einzige Provider-API sind. Beide präsentieren einen Assistenten als langes Laufzeit-System mit Gateways, Sitzungen, Tools, Gedächtnis und mehreren Modell-Backends.
| Architektonische Sorge | OpenClaw-Zuordnung | Hermes-Zuordnung |
|---|---|---|
| Eingang und Oberflächen | Selbst gehostetes Gateway, das Chat-Apps und Kanaloberflächen verbindet | Ein einzelnes Hintergrund-Messaging-Gateway, das viele externe Plattformen verbindet |
| Orchestrierung | Gateway-zentrierte Steuerungsfläche für Kanäle und KI-Interaktionen | AIAgent-Schleife, die Prompt-Zusammenstellung, Provider-Auswahl, Tool-Disposition, Wiederholungen und Failover handhabt |
| Routing | Multi-Agenten-Routing bindet eingehenden Verkehr an isolierte Agenten mit getrennten Arbeitsbereichen und Sitzungen | Haupt- und Hilfs-Modell-Slots trennen Kernlogik von Kompression, Zusammenfassung, Genehmigungen und MCP-Routing |
| Gedächtnis | Dateibasiertes Gedächtnis plus optionales aktives Gedächtnis und Hintergrund-Dreaming-Promotions | MEMORY.md und USER.md werden als eingefrorener Sitzungssnapshot injiziert, plus externe Gedächtnis-Provider |
| Tooling und Erweiterung | Eingebaute Tools, Sitzungstools, Provider-Plugins, benutzerdefinierte und selbst gehostete Endpunkte | 40+ Tools, eingebauter MCP-Client, Toolsets, Skills und Gedächtnis-Provider-Plugins |
Diese Zuordnung basiert auf den offiziellen OpenClaw- und Hermes-Dokumentationen und Repositories. OpenClaw dokumentiert eine Gateway-Architektur, Multi-Agenten-Routing, Unterstützung für benutzerdefinierte und selbst gehostete Provider einschließlich vLLM und Ollama, optionales aktives Gedächtnis und Dreaming-basierte Promotionen. Hermes dokumentiert ein Messaging-Gateway, eine zentrale AIAgent-Schleife, Haupt- und Hilfs-Modell-Slots, eingebautes Gedächtnis und native MCP-Integration.
Meine leicht meinungsstarke Lesart ist, dass beide Systeme dasselbe architektonische Argument in verschiedenen Akzenten liefern. OpenClaw ist stark gateway-first. Hermes ist stark agent-loop-first. Aber beide lehnen den flachen Gedanken ab, dass ein Assistent nur „Prompt plus Modell“ ist. Sie modellieren Kanäle, Identitäten, Gedächtnissemantik, Tool-Oberflächen und Backend-Heterogenität als First-Class-Sorgen. Das ist genau das, was eine Produktionsarchitektur tun sollte.
Ein praktischer Hybrid-Stack, der von beiden Systemen inspiriert ist, sieht so aus:
edge:
  gateway: hermes oder openclaw

routing:
  proxy: litellm
  policy: latenz- und budgetbewusst
  tenancy: sitzungs- und kanalbezogen

llm:
  primary: openai responses oder anthropic messages
  local_fallback: vllm
  local_dev: ollama oder llama.cpp

memory:
  session: sqlite oder postgres
  semantic: pgvector oder weaviate
  embeddings: openai embeddings oder ollama embeddings

tools:
  contract: json schema tools plus mcp
  examples: dateisystem, browser, websuche, interne apis

observability:
  traces: opentelemetry
  ai_dashboards: openlit oder langsmith
  evals: openai evals plus anwendungsspezifische regression sets
Dieser Stack ist ein begründetes Deployment-Muster und kein von einem Anbieter vorgeschriebenes Blueprint. Er funktioniert, weil die offiziellen Schnittstellen übereinstimmen: OpenAI und Anthropic bieten tool-orientierte APIs, vLLM und llama.cpp emulieren anbieterseitige Endpunkte, Ollama handhabt lokale Modelle und Embeddings, MCP standardisiert externe Tools, LiteLLM handhabt Routing und Failover und OpenTelemetry-kompatible Plattformen können den gesamten Pfad tracken.
Patterns, Tabellen und Tradeoffs
Es gibt einige wiederholbare Assistenten-Pattern, die benannt werden sollten. Ein gemanagter Assistent behält die meiste Laufzeit innerhalb der Provider-APIs. Ein retrieval-first-Assistent betrachtet Gedächtnis und Suche als den Hauptunterscheidungsmerkmal. Ein tool-first-Assistent verhält sich eher wie ein Operator als wie ein Chatbot. Ein gateway-Assistent priorisiert Always-on-Zugriff über Messaging-Oberflächen. Ein Spezialisten-Mesh dekomponiert Arbeit in mehrere Agenten oder Routen. Offizielle Doku über OpenAI, Anthropic, LlamaIndex, LiteLLM, OpenClaw und Hermes stützen alle Versionen dieser Patterns, auch wenn sie sie unterschiedlich benennen.
| Pattern | Wofür es optimiert wird | Best Use Case | Versteckter Preis |
|---|---|---|---|
| Gemanagter Assistent | Geschwindigkeit der Lieferung | Interne Copilots und Support-Bots | Provider-Lock-in und weniger Kontrolle über Laufzeitdetails |
| Retrieval-first-Assistent | Fundierte Antworten über eigene Daten | Doku, Support, Wissensarbeit | Abrufqualität wird zum eigentlichen Produkt |
| Tool-first-Assistent | Aktion über Konversation | Ops-Workflows, Datenabruf, Automatisierungen | Seiteneffekte, Wiederholungen und Genehmigungen werden zu Kernsorgen |
| Gateway-Assistent | Ubiquiter Zugang | Persönliche und Team-Assistenten über Chat-Oberflächen | Komplexität bei Identität, Sitzung und Sicherheit |
| Spezialisten-Mesh | Arbeitsteilung | Komplexe Workflows mit echten Ownership-Grenzen | Schwerer zu debuggen, orchestrieren und Eval-Design |
Das Spezialisten-Mesh-Pattern wächst zu einer eigenständigen Disziplin der Informatik, wenn die Agentenzahl steigt. Für die sechs kanonischen Koordinations-Patterns – Orchestrator-Worker, sequentielle Pipeline, Fan-out, hierarchisch, Schwarm und Mesh – mit spezifischen Fehlmustern und einem Produktions-Entscheidungsrahmen siehe Multi-Agent-Orchestrierungs-Patterns.
Diese Pattern-Tabelle ist eine Synthese aus den Anbieter-, Framework- und Referenzsystem-Dokumentationen, nicht eine Behauptung eines einzelnen Anbieters.
| Option-Form | Typische Komponenten | Stärke | Schwäche |
|---|---|---|---|
| Gemanagt | OpenAI Responses oder Anthropic Managed Agents, gehostete Dateisuche oder Vektorspeicher | Schnellster Pfad, weniger bewegliche Teile, gehostete Tools | Geringste Kontrolle über Datenpfad und Laufzeitsemantik |
| Hybrid | Provider-API plus selbst gehosteter Router und Vektorspeicher | Gutes Gleichgewicht zwischen Geschwindigkeit und Kontrolle | Mehr Verträge zu warten |
| Selbst gehostet | vLLM oder llama.cpp oder Ollama, MCP, selbst gehostete Vektordatenbank, OTel | Starke Datenschutz- und Deployment-Kontrolle | Höchster Betriebsaufwand, Hardware- und Tuning-Overhead |
Tabellenanmerkung: OpenAI gehostete Dateisuche ist ein gemanagtes Tool, Anthropic bietet ein gemanagtes Gerüst, Pinecone ist ein gemanagter Vektor-Service, während vLLM, llama.cpp, Ollama, pgvector, Weaviate, Milvus, LangSmith Self-Hosted und OpenLIT alle selbst verwaltete oder Hybrid-Betrieb in unterschiedlichem Maße unterstützen.
| Vektorspeicher | Form | Warum Teams ihn wählen | Warnung |
|---|---|---|---|
| Pinecone | Gemanagter Vektor-Service | Starke operative Einfachheit und skalierbare gemanagte Architektur | Externe Abhängigkeit und Ökonomie des gemanagten Services |
| Weaviate | Open-Source-Vektordatenbank | Vektoren plus invertierte Indizes und flexible Indexauswahl | Mehr Cluster-Tuning als bei einem rein gehosteten Pfad |
| pgvector | Postgres-Erweiterung | Vektoren mit relationalen Daten und dem bestehenden SQL-Stack behalten | Nicht die beste Passform für jede hochskalierende ANN-Last |
| Milvus | Verteilte Vektordatenbank | Maßgeschneiderte Skalierung und Ökosystem um gemanagte Zilliz Cloud | Eine weitere spezialisierte Datenspeicherinstanz zu betreiben |
Tabellenanmerkung: Pinecone dokumentiert eine gemanagte Steuerungsfläche und regionale Datenflächen. Weaviate dokumentiert Vektor- und invertierte Indizes mit mehreren Vektor-Index-Typen. pgvector fügt exakte und ungenaue Next-Neighbor-Suche zu Postgres hinzu. Milvus positioniert sich als Open-Source-hochleistungs-scalable Vektordatenbank, mit Zilliz Cloud als gemanagter Option.
| LLM-Option | Schnittstellenstil | Am besten geeignet für | Warnung |
|---|---|---|---|
| OpenAI Responses | Zustandsbehaftete Antworten plus integrierte Tools | Schneller Start, gehostete Tools, strukturierte Schleifen | Sie erben plattformspezifische Abstraktionen |
| Anthropic Messages | Direkter Modellzugriff mit explizitem Tool-Use-Vertrag | Klare Tool-Grenzen und gute Kontrolle in Custom-Schleifen | Mehr Laufzeit ist Ihre Verantwortung, außer Sie nutzen Managed Agents |
| vLLM | OpenAI-kompatibler und Anthropic-kompatibler selbst gehosteter Serving | Hocheffiziente selbst gehostete Inferenz | Echte Infrastruktur- und Modell-Serving-Arbeit |
| Ollama | Einfacher lokaler Modell- und Embedding-Laufzeitumgebung | Lokale Entwicklung und kleine selbst gehostete Stacks | Nicht dieselbe Klasse von Serving-System wie eine getunte verteilte Laufzeitumgebung |
| llama.cpp | Leichter lokaler Server mit provider-kompatiblen Routen | Edge, CPU-first, eingeschränkte Umgebungen | Sie führen mehr manuelles Tuning und Fähigkeitsabgleich durch |
Tabellenanmerkung: OpenAI dokumentiert Responses als seine fortschrittliche Schnittstelle für zustandsbehaftete Antworten und integrierte Tools. Anthropic dokumentiert die Messages API und den Tool-Use-Vertrag getrennt von Managed Agents. vLLM stellt einen OpenAI-kompatiblen Server plus Anthropic Messages API-Unterstützung bereit. Ollama dokumentiert lokale Embedding- und Modell-Workflows. llama.cpp dokumentiert OpenAI-kompatible Chat-, Response- und Embedding-Routen, plus Anthropic-kompatible Chat-Vervollständigungen.
| Einschränkung oder Tradeoff | Neigung zu gemanagt | Neigung zu selbst gehostet | Praktische Minderung |
|---|---|---|---|
| Latenz | Oft bessere erste Iteration und weniger lokale Tuning-Aufgaben | Kann gewinnen, wenn Modell und Daten kollokiert und warm gehalten werden | Verwenden Sie Routing-Stufen, heiße Caches und kleinere Hilfsmodelle |
| Kosten | Leicht zu starten, variabel bei Token-Skala | Bessere Amortisation bei stabiler Auslastung | Messen Sie echten Verkehr, bevor Sie nach Instinkt optimieren |
| Datenschutz und Datenresidenz | Einfacher für nicht-sensitive Daten | Stärkere Kontrolle für sensitive und regulierte Flows | Verwenden Sie Hybrid-Grenzen und behalten Sie nur das, was sich bewegen muss |
| Konsistenz | Gehostete Tools haben immer noch gestufte Sichtbarkeitssemantiken | Selbst gehostete Gedächtnispipelines stufen und promovieren Daten ebenfalls | Definieren Sie Read-after-Write-Regeln explizit pro Ebene |
| Skalierung | Weniger Steuerungsfläche-Schmerz | Bessere Anpassung für stabile, spezialisierte Workloads | Verwenden Sie Batching, Queueing und isolierte Tenants |
| Debuggbarkeit | Leicht, intransparente Provider-Internals zu übersehen | Leicht, in selbstgeschaffener Komplexität zu ertrinken | Tracen Sie jede Anfrage und evalen Sie jede Route |
Diese Tradeoff-Matrix ist eine architektonische Inferenz aus den offiziellen Doku, kein Anbieter-Benchmark. Die Konsistenzzeile ist wichtiger, als viele Blog-Posts zugeben: Pinecone trennt Schreib- und Lesewege, Hermes friert Gedächtnis in Start-Sitzung-Prompts ein und OpenClaw fördert dauerhafter Gedächtnis über gestufte Prüfung. Das bedeutet, dass „Gedächtnis aktualisiert“ und „Gedächtnis für die aktuelle Antwort sichtbar“ oft verschiedene Wahrheiten sind.
Fehlmuster und Minderungen
Die meisten Assistenten scheitern nicht, weil das Basis-Modell „schlecht“ ist. Sie scheitern, weil das umgebende System dem Modell die Lüge erzählt, es den richtigen Kontext entzieht, Tools driften lässt oder das Debugging unmöglich macht.
| Wo es bricht | Typisches Symptom | Übliche Ursache | Minderung |
|---|---|---|---|
| Prompt-Zusammenstellung | Selbstbewusste, aber nicht treffende Antwort | Zu viel irrelevanter Kontext, schlechte Sortierung | Kontext-Budget setzen, reranken, Schlüsseltatsachen nach oben halten |
| Abruf (Retrieval) | Korrekter Ton, falsche Fakten | Schlechtes Chunking, veralteter Index, schwache Filter | Retrieval separat evaluieren, Metadatenfilter und hybride Suche hinzufügen |
| Tool-Grenze | Falsche Aktion oder doppelte Aktion | Lose Schemata, Wiederholungen ohne Idempotenz | Strikte Schemata, Idempotenzschlüssel, Genehmigungstore |
| Routing | Wild inkonsistentes Verhalten pro Anfrage | Kosten- oder Latenz-Routing ohne Qualitätskontrollen | Sticky Sessions und pro Route Evals hinzufügen |
| Gedächtnis | Veraltete oder vergiftete Erinnerung | Übertriebenes Schreiben, schwache Prüfung, Cross-Session-Leckagen | Arbeits- und dauerhafter Gedächtnis trennen, Promotionen prüfen |
| Observability | Keine Ahnung, was passiert ist | Fehlende Traces oder keine Span-Granularität | Wurzel- und Subspans für Abruf, Modell- und Tool-Aufrufe ausgeben |
| Halluzinationskontrolle | Plausible, aber unbelegte Behauptungen | Schwache Verankerung oder keine Validierungsschleife | Referenzdokument-Validierung, Selbstkonsistenz-Checks, Eval-Tore |
Die Evidenzbasis für diese Tabelle ist breit, aber konsistent. Die Tool-Doku von Anthropic macht klar, dass Tool-Use eine Vertragsgrenze ist. OpenAI Guardrails umfasst Halluzinationserkennung gegen eine Referenzwissenbank über File Search. SelfCheckGPT zeigt, dass Selbstkonsistenz über Proben helfen kann, unbelegte Behauptungen zu erkennen. Die Ergebnisse von „Lost in the Middle“ und die Kontextleitfäden von Anthropic unterstreichen beide dieselbe operative Lektion: Mehr Tokens beseitigen nicht die Notwendigkeit der Kontextkuratierung.
Der bevorzugte Minderungs-Stack könnte langweilig und repetitiv sein: jede Anfrage tracken, Prompts versionieren, Retrieval unabhängig evaluieren, Tools idempotent halten und Regressions-Evals ausführen, bevor man Routen oder Gedächtnispolicy ändert. Die Evals-Doku und das Repository von OpenAI sind offen darüber: ohne Evals ist es schwierig und zeitaufwändig zu verstehen, wie Modell- oder Prompt-Änderungen Ihren Use Case beeinflussen. Das gilt genauso für Router und Retrieval wie für Prompts.
Weitere Lektüre
Wenn Sie tiefer einsteigen möchten, sind dies die nützlichsten Primärquellen, die offen bleiben sollten, während Sie eine Assistentenarchitektur designen oder überprüfen.
-
OpenAI: Responses Overview, Function Calling, Using Tools, Retrieval, File Search, Evals und MCP für Remote-Tool-Server.
-
Anthropic: API Overview, Tool Use, der Tool-Use-Vertrag, Managed Agents, Context Windows und der MCP-Connector.
-
MCP selbst: Die Architecture Overview und Specification sind lesenswert, weil sie Hosts, Clients, Server, Tools, Prompts, Ressourcen, Transports und Capability-Negotiation klar erklären. Für einen praktischen Vergleich von MCP mit dem Agent2Agent-Protokoll und wann ein Multi-Agenten-System beide Ebenen benötigt, siehe A2A vs MCP: Benötigen KI-Agenten wirklich beide Protokolle?. Und für die A2A-Konzepte selbst – Agent Cards, Task-Lebenszyklus, Nachrichten, Teile und Artefakte – siehe Was ist das A2A-Protokoll? Agent Cards und Tasks erklärt.
-
Hintergrund- und proaktive Assistenten: Die Tooling-Ebene ist nur ein Teil davon, wie Assistenten handeln. Für wie man einen Assistenten dazu bringt, zu beobachten, zu entscheiden und eigenständig zu handeln – Scheduler, Queue-basierte Worker, Claim-Protokolle, dauerhafte Workflows und semantisches Polling – siehe Polling Agents in KI-Assistenten: 11 Implementierungspatterns.
-
Entscheidungsbefugnis: Für welche Entscheidungen ein Modell treffen, empfehlen oder nur informieren sollte – die fünf Entscheidungsrollen, konfidenzbasiertes Routing in die kleinste kompetente Stufe und Genehmigungstore, die an den Blast Radius angepasst sind – siehe Decision LLMs: Wann ein Modell entscheiden sollte – und wann nicht.
-
A2A-Protokoll und Adoption: Sobald Agenten unabhängig deployed werden und über Ownership-Grenzen hinweg zusammenarbeiten müssen, wird A2A relevant. Für eine praktische 2026-Perspektive darauf, wo A2A tatsächlich Traktion hat, die Sicherheitsfragen, die es aufwirft, und einen Entscheidungsrahmen für die Adoption, siehe Google A2A-Protokoll in 2026: Adoption, Hype und Realität. Wenn diese Agenten langlaufende Aufgaben austauschen, anstatt einzelne Chat-Runden, deckt [A2A Streaming und Async Tasks für langlaufende Agenten-Workflows](https://www.glukhov.org/de/ai-systems/architecture/a2a-streaming-async-task-lifecycle/ “Wie man A2A-Protokoll-Streaming, Async-Tasks, Push-Benachrichtigungen und langlaufende Agenten-Workflows designen kann.”} SSE, Push und input_required-Design an der Protokollgrenze ab.
-
Frameworks und Routing: LangChain Overview, LlamaIndex Kontextergänzungs-Doku, LiteLLM Routing-Doku, LangSmith Observability-Doku.
-
Selbst gehostete Laufzeitumgebungen und Assistentensysteme: vLLM, llama.cpp Server, Ollama Embeddings, OpenClaw Doku und Repository, Hermes Doku und Repository.
-
Speicherung und Observability: Pinecone, Weaviate, pgvector, Milvus, OpenTelemetry, OpenLIT.
-
Forschungs-Papiere: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Lost in the Middle und SelfCheckGPT.
