Docker

Rückblick für Hermes-Agent: Selbst gehostetes Gedächtnis mit lokalen LLMs

Rückblick für Hermes-Agent: Selbst gehostetes Gedächtnis mit lokalen LLMs

Permanenter Hermes-Speicher auf Ihrer eigenen Hardware.

Ein selbst gehosteter KI-Agent benötigt mehr als ein langes Kontextfenster. Er braucht eine Möglichkeit, nützliche Fakten beizubehalten, frühere Entscheidungen abzurufen und seine Kenntnis davon, was er weiß, zu revidieren, während sich Projekte weiterentwickeln.
Ollama zu vLLM: Wann Sie Ihren lokalen LLM-Server migrieren sollten

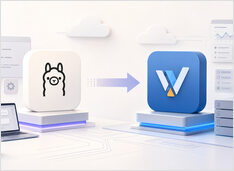
Ollama zu vLLM: Wann Sie Ihren lokalen LLM-Server migrieren sollten

Wann von Ollama auf vLLM wechseln

Ollama ist einer der einfachsten Wege, ein lokales Sprachmodell auszuführen, aber die Bequemlichkeit kann den Moment verbergen, in dem ein lokales Experiment zu einem gemeinsamen Inferenzdienst wird, der eine bessere Planung und Beobachtbarkeit benötigt.

Podman Quadlet vs. Docker Compose für Linux-Dienste

Podman Quadlet vs. Docker Compose für Linux-Dienste

Wählen Sie den richtigen Container-Workflow.

Docker Compose und Podman Quadlet lösen überlappende Probleme, stammen jedoch aus unterschiedlichen Designzentren. Die Wahl zwischen ihnen hängt davon ab, ob Sie in Anwendungsstacks oder in Linux-Dienste denken.

Docker Compose als Linux-Dienst mit systemd ausführen

Docker Compose als Linux-Dienst mit systemd ausführen

Docker Compose beim Systemstart, verwaltet durch systemd.

Ein Docker Compose-Projekt auf einem Linux-Server sollte beim Booten starten, beim Herunterfahren sauber gestoppt werden und Neustarts ohne manuelle Eingriffe überstehen.

Vane (Perplexica 2.0) Quickstart mit Ollama und llama.cpp

Vane (Perplexica 2.0) Quickstart mit Ollama und llama.cpp

Selbst gehostete KI-Suche mit lokalen LLMs

Vane ist einer der pragmatischeren Vertreter im Bereich „KI-Suche mit Quellenangaben": eine selbst gehostete Antwort-Engine, die die Live-Webrecherche mit lokalen oder Cloud-LLMs kombiniert, während der gesamte Stack unter Ihrer Kontrolle bleibt.

Hermes KI-Assistent – Installation, Einrichtung, Workflow und Fehlerbehebung

Hermes KI-Assistent – Installation, Einrichtung, Workflow und Fehlerbehebung

Hermes-Agent: Installation und Schnellstart für Entwickler

Hermes Agent ist ein selbst gehosteter, modell-agnostischer KI-Assistent, der auf einem lokalen Rechner oder einem kostengünstigen VPS läuft, über Terminal- und Messaging-Schnittstellen arbeitet und mit der Zeit besser wird, indem er wiederkehrende Aufgaben in wiederverwendbare Skills umwandelt.

Ollama in Docker Compose mit GPU und persistenter Model-Speicherung

Ollama in Docker Compose mit GPU und persistenter Model-Speicherung

Compose-first Ollama-Server mit GPU und Persistenz.

Ollama läuft hervorragend auf Bare-Metal-Systemen. Es wird noch interessanter, wenn man es wie einen Dienst behandelt: mit einem stabilen Endpunkt, festgelegten Versionen, persistentem Speicher und einer GPU, die entweder verfügbar ist oder eben nicht.

llama.swap Modellumschalter: Schnelleinstieg für OpenAI-kompatible lokale LLMs

llama.swap Modellumschalter: Schnelleinstieg für OpenAI-kompatible lokale LLMs

Lokale LLMs per Hot-Swap austauschen, ohne die Clients anzupassen.

Bald jonglierst du mit vLLM, llama.cpp und weiteren – jeder Stack auf seinem eigenen Port. Alles, was downstream liegt, erwartet weiterhin eine einzige /v1-Basis-URL; andernfalls musst du ständig Ports, Profile und Einmalskripte umstellen. llama-swap ist die /v1-Proxy-Schicht vor diesen Stacks.

Entwickler-Tools: Der vollständige Leitfaden zu modernen Entwicklungs-Workflows

Entwickler-Tools: Der vollständige Leitfaden zu modernen Entwicklungs-Workflows

Die Softwareentwicklung umfasst Git für die Versionskontrolle, Docker für die Containerisierung, Bash für die Automatisierung, PostgreSQL für Datenbanken und VS Code für die Bearbeitung – zusammen mit unzähligen anderen Tools, die Ihre Produktivität maßgeblich beeinflussen können. Diese Seite bündelt die wichtigsten Spickzettel, Workflows und Vergleichsübersichten, die Sie benötigen, um effizient über den gesamten Entwicklungsstapel hinweg zu arbeiten.