WordPress-SEO-Plugins fügen dem WordPress-Kern eine Metadaten-, Sitemap-, Schema- und KI-Schicht hinzu. Im Jahr 2026 umfasst diese Schicht auch Plugins, die Inferenz auf Ihrer eigenen Hardware ausführen.
Self-hosted SEO deckt inzwischen Crawler, Search-Console-Dashboards, Ranking-Tracker, MCP-Server und lokale KI ab. Dieser Leitfaden vergleicht die wichtigsten Open-Source-Plattformen und welche Funktionen ohne kostenpflichtige SEO-APIs funktionieren.
Selbst gehostete Agenten, die über die Suche hinaus recherchieren
Deep Research ist inzwischen eine eigene Softwarekategorie geworden, nicht mehr nur ein Modell, das auf ein Suchfeld angewiesen ist. Dieser Artikel vergleicht zwölf selbst gehostete Systeme und die dahinterliegenden Forschungsarchitekturen.
Ollama und llama.cpp werden oft so verglichen, als wären sie konkurrierende Inferenz-Engines. Die eigentliche Wahl besteht zwischen einem verwalteten Modell-Service und einem Toolkit, das Sie direkt betreiben.
Das passende AMD-Backend für jede Engine auswählen
Sowohl ROCm als auch Vulkan beschleunigen AMD-GPUs für den lokalen Betrieb von LLMs, aber sie sind nicht austauschbar. Die richtige Wahl hängt von der Engine, der GPU und der Arbeitslast ab.
Ein Modell kann einen 128K-Kontextfenster bewerben und trotzdem bei 40K Tokens auf einer 16-GB-GPU scheitern. Die architektonische Obergrenze hat nie versprochen, dass Modellgewichte, KV-Cache, Rechenspeicher und der Desktop-Compositor gleichzeitig auf Ihrer Grafikkarte Platz finden würden.
Jeder API-Aufruf fühlt sich wie eine simple Transaktion an – bis genug von ihnen akkumuliert sind, sodass Ihre Feinabstimmungsdaten, Bewertungsumgebungen und Tool-Schemata alle um einen einzigen Anbieter herum geformt werden, und der Wechsel keine bloße Routing-Änderung mehr ist.
Ollama ist einer der einfachsten Wege, ein lokales Sprachmodell auszuführen, aber die Bequemlichkeit kann den Moment verbergen, in dem ein lokales Experiment zu einem gemeinsamen Inferenzdienst wird, der eine bessere Planung und Beobachtbarkeit benötigt.
Vane ist einer der pragmatischeren Vertreter im Bereich „KI-Suche mit Quellenangaben": eine selbst gehostete Antwort-Engine, die die Live-Webrecherche mit lokalen oder Cloud-LLMs kombiniert, während der gesamte Stack unter Ihrer Kontrolle bleibt.
Ollama ist am glücklichsten, wenn es wie ein lokaler Daemon behandelt wird: Die CLI und Ihre Apps kommunizieren mit einer Loopback-HTTP-API, und der Rest des Netzwerks erfährt nie von ihrer Existenz.
Compose-first Ollama-Server mit GPU und Persistenz.
Ollama läuft hervorragend auf Bare-Metal-Systemen. Es wird noch interessanter, wenn man es wie einen Dienst behandelt: mit einem stabilen Endpunkt, festgelegten Versionen, persistentem Speicher und einer GPU, die entweder verfügbar ist oder eben nicht.
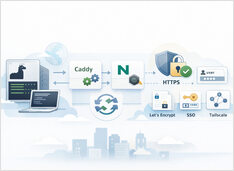
HTTPS mit Ollama, ohne die Streaming-Antworten zu beeinträchtigen.
Das Betreiben von Ollama hinter einem Reverse-Proxy ist der einfachste Weg, HTTPS, optionale Zugriffskontrolle und ein vorhersagbares Streaming-Verhalten zu erhalten.
Wenn Sie sich mit retrieval-augmented generation (RAG) beschäftigen, führt dieser Abschnitt Sie in einfachen Worten durch Text-Embeddings – was sie sind, wie sie in Suche und Abruf passen und wie man zwei gängige lokale Setups von Python aus mit Ollama oder einer OpenAI-kompatiblen HTTP-API aufruft (wie sie von vielen llama.cpp-basierten Servern bereitgestellt werden).
OpenCode LLM-Test — Statistiken zu Codierung und Genauigkeit
Ich habe getestet, wie sich OpenCode mit mehreren lokal auf Ollama und llama.cpp gehosteten LLMs verhält, und habe zum Vergleich einige kostenlose Modelle von OpenCode Zen hinzugefügt.
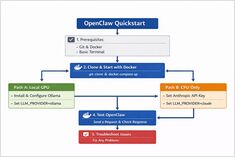
OpenClaw ist ein selbst gehosteter KI-Assistent, der mit lokalen LLM-Runtimes wie Ollama oder mit cloudbasierten Modellen wie Claude Sonnet ausgeführt werden kann.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.