Ein Modell kann einen 128K-Kontextfenster werben und dennoch bei 40K Tokens auf einer 16-GB-GPU scheitern. Die architektonische Obergrenze hat nie versprochen, dass Gewichte, KV-Cache, Rechenpuffer und der Desktop-Compositor gleichzeitig auf Ihrer Karte Platz finden.
Ollama ist einer der einfachsten Wege, ein lokales Sprachmodell auszuführen, doch der Komfort kann den Moment verbergen, in dem ein lokales Experiment zu einem gemeinsam genutzten Inferenzdienst wird, der bessere Planung und Observability benötigt.
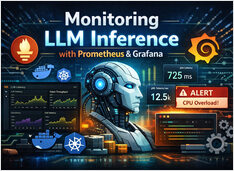
LLM-Inferenz sieht aus wie „nur eine weitere API" – bis die Latenzspitzen auftreten, Warteschlangen sich stauen und Ihre GPUs eine Speichernutzung von 95 % haben, ohne dass eine offensichtliche Erklärung dafür vorhanden ist.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
vLLM ist eine hochleistungsfähige, speichereffiziente Engine für die Inferenz und Bereitstellung von großen Sprachmodellen (LLMs), entwickelt vom Sky Computing Lab der UC Berkeley.
Vergleichen Sie die besten Tools für das lokale Hosting von LLMs im Jahr 2026. API-Reife, Hardware-Unterstützung, Tool-Calling und praxisnahe Anwendungsfälle.
Das lokale Ausführen von LLMs (Large Language Models) ist für Entwickler, Startups und sogar Enterprise-Teams jetzt praktikabel.
Die Wahl des richtigen Tools — Ollama, vLLM, LM Studio, LocalAI oder andere — hängt jedoch von Ihren Zielen ab: