OpenAI

llama.swap Modellwechsler: Schnellstart für OpenAI-kompatible lokale LLMs

llama.swap Modellwechsler: Schnellstart für OpenAI-kompatible lokale LLMs

Lokale LLMs ohne Änderung der Clients austauschen.

Bald jonglieren Sie mit vLLM, llama.cpp und mehr – jeder Stack auf einem eigenen Port. Alles nachgeschaltete System erwartet dennoch eine einzige /v1-Basis-URL; andernfalls sortieren Sie ständig Ports, Profile und Einmal-Skripte neu. llama-swap ist der /v1-Proxy vor diesen Stacks.

Schnellstart für llama.cpp mit CLI und Server

Schnellstart für llama.cpp mit CLI und Server

OpenCode installieren, konfigurieren und verwenden

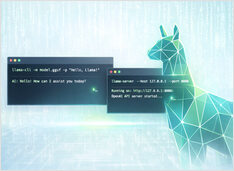
Ich komme immer wieder auf llama.cpp für lokale Inferenz zurück – es bietet eine Kontrolle, die Ollama und andere abstrahieren, und es funktioniert einfach. GGUF-Modelle lassen sich mit llama-cli interaktiv und mühelos ausführen oder eine OpenAI-kompatible HTTP-API mit llama-server bereitstellen.