
Design moderner Alerting-Systeme für Observability-Teams
Alerting ist ein Reaktionssystem, kein Lärm-System.
Alerting wird viel zu oft als ein Überwachungsfunktion beschrieben. Diese Einordnung ist bequem, verschleiert aber das eigentliche Problem.
Alerting ist ein Reaktionssystem, kein Lärm-System.
Alerting wird viel zu oft als ein Überwachungsfunktion beschrieben. Diese Einordnung ist bequem, verschleiert aber das eigentliche Problem.
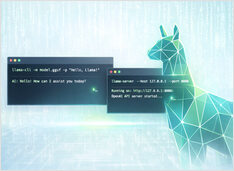
OpenCode installieren, konfigurieren und verwenden
Ich komme immer wieder auf llama.cpp für lokale Inferenz zurück – es bietet eine Kontrolle, die Ollama und andere abstrahieren, und es funktioniert einfach. GGUF-Modelle lassen sich mit llama-cli interaktiv und mühelos ausführen oder eine OpenAI-kompatible HTTP-API mit llama-server bereitstellen.
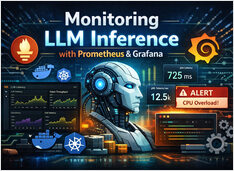
Überwachen von LLMs mit Prometheus und Grafana
LLM-Inferenz sieht aus wie „nur eine weitere API" – bis die Latenzspitzen auftreten, Warteschlangen sich stauen und Ihre GPUs eine Speichernutzung von 95 % haben, ohne dass eine offensichtliche Erklärung dafür vorhanden ist.
End-to-End-Beobachtbarkeitsstrategie für LLM-Inferenz und LLM-Anwendungen
LLM-Systeme versagen auf Arten, die herkömmliches API-Monitoring nicht aufdecken kann – Warteschlangen füllen sich stillschweigend, der GPU-Speicher sättigt lange bevor die CPU ausgelastet wirkt, und die Latenz steigt im Batching-Layer an, nicht im Anwendungslayer.
Metriken, Dashboards, Logs und Alerting für Produktionssysteme – Prometheus, Grafana, Kubernetes und KI-Workloads.
Beobachtbarkeit ist das Fundament zuverlässiger Produktionsumgebungen.
Ohne Metriken, Dashboards und Alarmierung treiben Kubernetes-Cluster unbeobachtet umher, KI-Workloads fallen still aus und Latenzverschlechterungen werden übersehen, bis Benutzer sich beschweren.
Richten Sie eine robuste Infrastrukturüberwachung mit Prometheus ein
Prometheus ist zum de facto Standard für die Überwachung cloud-nativer Anwendungen und Infrastruktur geworden und bietet Metriken-Sammlung, Abfragen und Integration mit Visualisierungstools.
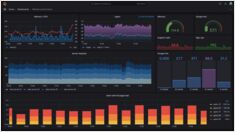
Optimierte Grafana-Konfiguration für Überwachung und Visualisierung
Grafana ist die führende Open-Source-Plattform für Überwachung und Observability, die Metriken, Protokolle und Spuren in handlungsorientierte Erkenntnisse durch beeindruckende Visualisierungen umwandelt.