API

Concurrency in Go begrenzen: errgroup, Worker Pools und Backpressure

Concurrency in Go begrenzen: errgroup, Worker Pools und Backpressure

Begrenze die parallele Arbeit, statt sie einfach abzubrechen.

Unbegrenztes Fan-out ist der Standardausfallmodus der Go-Konkurrenz: Jede go-Anweisung ist eine weitere laufende Aufgabe, ohne Obergrenze und ohne Verantwortlichen. Dieser Artikel behandelt die Einführung beider: Obergrenzen und Verantwortung.
Go-Web-Frameworks 2026: net/http, chi, Gin, Echo und Fiber im Vergleich

Go-Web-Frameworks 2026: net/http, chi, Gin, Echo und Fiber im Vergleich

Fünf Go-HTTP-Stacks, ein Benchmark-Setup, echte Zahlen.

Go liefert einen produktionsreifen HTTP-Server in seiner Standardbibliothek mit, und seit Go 1.22 übernimmt der eingebaute Router selbstständig die Methodenabgleichung und Pfadparameter. Die Frage nach dem Framework hat sich verengt, ist aber nicht verschwunden.

Ollama zu vLLM: Wann Sie Ihren lokalen LLM-Server migrieren sollten

Ollama zu vLLM: Wann Sie Ihren lokalen LLM-Server migrieren sollten

Wann von Ollama auf vLLM wechseln

Ollama ist einer der einfachsten Wege, ein lokales Sprachmodell auszuführen, aber die Bequemlichkeit kann den Moment verbergen, in dem ein lokales Experiment zu einem gemeinsamen Inferenzdienst wird, der eine bessere Planung und Beobachtbarkeit benötigt.

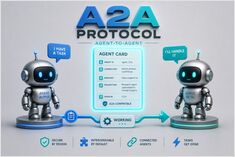
Sicherheit von A2A- und MCP-Agenten: Identität, Delegation und Audit-Trails

Sicherheit von A2A- und MCP-Agenten: Identität, Delegation und Audit-Trails

Protokollsicherheit definiert, wer handeln darf, nicht das Modell.

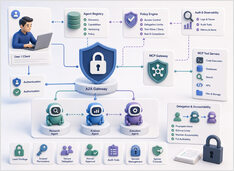
Prompt-Injection erhält den größten Teil der Aufmerksamkeit im Bereich der Sicherheit von LLM-Systemen, und das zu Recht, aber sie ist nicht das einzige Problem, sobald Agenten beginnen, Tools aufzurufen und Arbeit an andere Agenten zu delegieren.

Idempotenz in verteilten Systemen, die tatsächlich funktioniert

Idempotenz in verteilten Systemen, die tatsächlich funktioniert

Duplizierte Seiteneffekte vermeiden

Idempotenz in verteilten Systemen ist die Eigenschaft, die Sie rettet, wenn das Netzwerk lügt, die Warteschlange Wiederholungen versucht, der Client in Panik verfällt und der Operator den Replay-Button betätigt. In Produktionssystemen sind doppelte Zustellungen normal. Doppelte Nebeneffekte sind der Fehler.

Vane (Perplexica 2.0) Quickstart mit Ollama und llama.cpp

Vane (Perplexica 2.0) Quickstart mit Ollama und llama.cpp

Selbst gehostete KI-Suche mit lokalen LLMs

Vane ist einer der pragmatischeren Vertreter im Bereich „KI-Suche mit Quellenangaben": eine selbst gehostete Antwort-Engine, die die Live-Webrecherche mit lokalen oder Cloud-LLMs kombiniert, während der gesamte Stack unter Ihrer Kontrolle bleibt.

Schnellstart von llama.cpp mit CLI und Server

Schnellstart von llama.cpp mit CLI und Server

GGUF-Modelle mit der CLI und dem Server ausführen

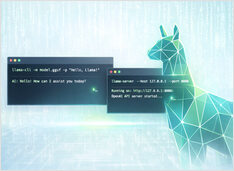
llama.cpp ist eine C/C++-Inferenz-Engine für GGUF-Modelle: llama-cli für interaktive Chats, llama-completion für skriptgesteuerte Prompts und llama-server für eine OpenAI-kompatible HTTP-API.

Airtable für Entwickler und DevOps – Pläne, API, Webhooks und Go/Python-Beispiele

Airtable für Entwickler und DevOps – Pläne, API, Webhooks und Go/Python-Beispiele

Airtable – Grenzen des kostenlosen Plans, API, Webhooks, Go & Python.

Airtable ist am besten als eine Low-Code-Plattform für Anwendungen zu verstehen, die um eine kooperative „datenbankähnliche“ Tabellenansicht herum gebaut ist – ideal für die schnelle Erstellung von operativen Tools (interne Tracker, leichte CRM-Systeme, Inhaltspipelines, AI-Bewertungsqueues), bei denen Nicht-Entwickler eine freundliche Oberfläche benötigen, aber Entwickler auch eine API-Oberfläche für Automatisierung und Integration benötigen.