
Kostenoptimierung für LLM-Systeme: Wo das Geld tatsächlich hingeht
Setze Token gezielt dort ein, wo es wirklich zählt.
LLM-Kosten skalieren linear mit der Nutzung. Ein System, das 10.000 Anfragen pro Tag zu 0,01 USD pro Anfrage verarbeitet, kostet 100 USD täglich – 365 USD pro Jahr. Im Unternehmensumfeld belaufen sich diese Kosten auf über 10.000 USD.
Kostenoptimierung bedeutet nicht, Abstriche zu machen. Es geht darum, Tokens dort auszugeben, wo sie wirklich zählen.
Jeder verschwendete Token ist ein Token, den man für eine bessere Antwort hätte ausgeben können.
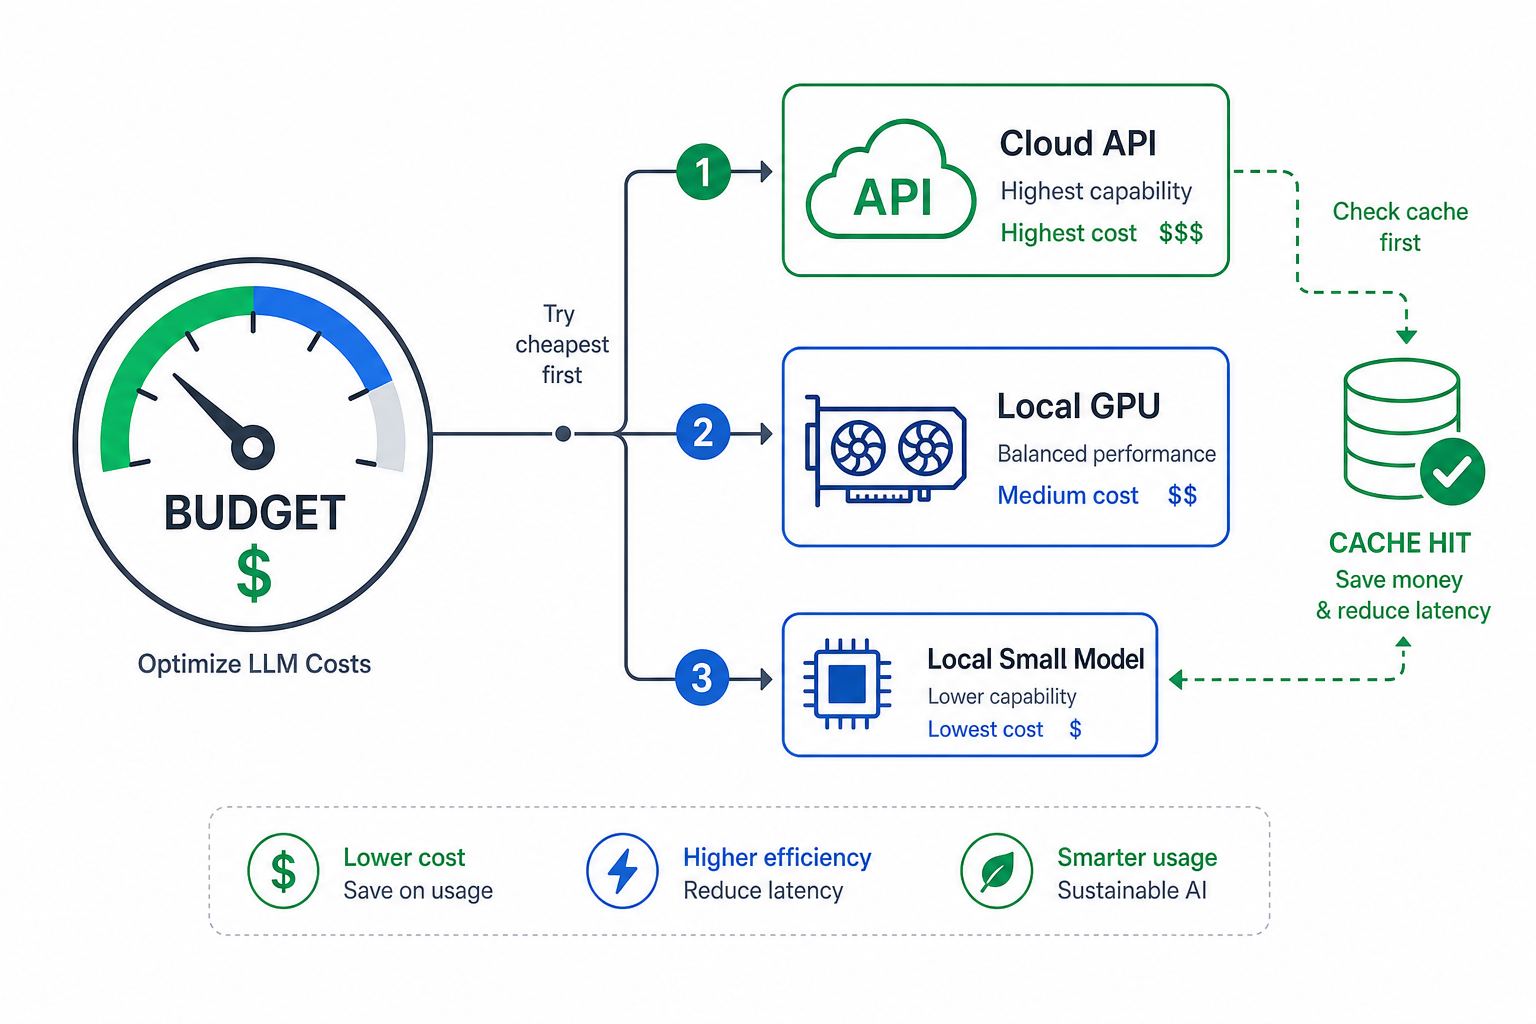
Token-Budgetierung
Der einfachste Weg, Kosten zu kontrollieren, ist das Setzen von Limits. Pro Sitzung, pro Aufgabe oder pro Tag.
Strategie 1: Budgets pro Sitzung
Budgets pro Sitzung sind unkompliziert:
class SessionBudget:
    def __init__(self, budget_tokens: int = 10000):
        self.budget = budget_tokens
        self.used = 0

    def allocate(self, tokens: int) -> bool:
        if self.used + tokens <= self.budget:
            self.used += tokens
            return True
        return False

    def remaining(self) -> int:
        return self.budget - self.used
Strategie 2: Budgets pro Aufgabe
Budgets pro Aufgabe sind nützlicher. Unterschiedliche Aufgaben erfordern unterschiedlich viel Kontext:
task_budgets:
  classify:
    max_tokens: 100
    model: qwen3-1.7b
  summarize:
    max_tokens: 500
    model: qwen3-8b
  code_review:
    max_tokens: 2000
    model: qwen2.5-coder-7b
  reason:
    max_tokens: 4000
    model: qwen3-32b
Strategie 3: Adaptive Budgets
Adaptive Budgets passen sich an an, was tatsächlich passiert. Wenn Klassifizierungsaufgaben konsequent 80 Tokens verbrauchen, sollte man aufhören, 100 zuzuweisen:
class AdaptiveBudget:
    def __init__(self):
        self.task_history = {}

    def allocate(self, task_type: str) -> int:
        if task_type in self.task_history:
            return int(self.task_history[task_type] * 1.5)
        return 1000

    def record(self, task_type: str, tokens_used: int):
        if task_type not in self.task_history:
            self.task_history[task_type] = tokens_used
        else:
            self.task_history[task_type] = (
                0.9 * self.task_history[task_type] + 0.1 * tokens_used
            )
Das exponentielle gleitende Mittel (Gewichtung 0,9) bedeutet, dass kürzliche Nutzung wichtiger ist als die Historie. Passen Sie die Gewichtung an die Volatilität Ihrer Workloads an.
API vs. lokale Inferenz
Lokale Inferenz ist im großen Maßstab günstiger. Der Break-even-Punkt hängt von Ihrer Hardware und den API-Tarifen ab.
| Modell | API (USD/Millionen Tokens) | Lokale Kosten/Stunde | Break-even |
|---|---|---|---|
| GPT-4o | 2,50 USD / 10,00 USD | — | N/A |
| Claude Sonnet 4 | 3,00 USD / 15,00 USD | — | N/A |
| Qwen2.5-72B | 0,50 USD / 2,00 USD | ca. 0,50 USD | ca. 4 Stunden/Tag |
| qwen3-32b | 0,30 USD / 1,20 USD | ca. 0,20 USD | ca. 2 Stunden/Tag |
| qwen3-8b | 0,10 USD / 0,40 USD | ca. 0,05 USD | ca. 1 Stunde/Tag |
Die Hardware-Berechnung:
| Hardware | Vorabkosten | Monatlicher Stromverbrauch | Break-even gegenüber API |
|---|---|---|---|
| RTX 3090 (gebraucht) | 600 USD | 15 USD | ca. 4 Monate |
| RTX 4090 | 1.500 USD | 20 USD | ca. 6 Monate |
| RTX 5080 | 1.000 USD | 18 USD | ca. 5 Monate |
| DGX Spark | 2.000 USD | 30 USD | ca. 8 Monate |
Bei mäßiger Nutzung – eine Stunde oder mehr pro Tag – amortisiert sich die lokale Inferenz. Bei hoher Nutzung sind die Ersparnisse erheblich. Der Haken ist das Vorabkapital. Eine RTX 5080 kostet 1.000 USD. Eine API-Rechnung kann man pausieren. Hardware nicht.
Diese Break-even-Berechnung setzt voraus, dass man frei wechseln kann, was oft die größere Unbekannte ist als die Hardwarekosten. Wenn Ihre Fine-Tuning-Daten, Evaluierungs-Harnesses und Tool-Schemata bereits um die API eines bestimmten Anbieters herum aufgebaut sind, besteht die eigentliche Migrationskosten aus dem Engineering-Aufwand, dieses aufzulösen – nicht aus dem Preis einer GPU. Datenanziehung: Die wahren Kosten von API-first AI behandelt diesen Lock-in-Mechanismus und eine Checkliste, um zu bewerten, wie tief man bereits darin steckt, bevor man diese Zahlen durchrechnet.
Fallback-Strategien
Wenn Ihr bevorzugtes Modell zu teuer oder zu langsam ist, weichen Sie auf etwas Günstigeres aus. Der Schlüssel ist zu wissen, wann die Qualität „gut genug“ ist.
Strategie 1: Qualität-basierter Fallback
Qualität-basierter Fallback probiert Modelle aus, bis die Ausgabe einen Schwellenwert erreicht:
class QualityFallback:
    def __init__(self, quality_threshold: float = 0.8):
        self.threshold = quality_threshold
        self.models = [
            {"model": "claude-sonnet-4", "cost": 0.015},
            {"model": "qwen2.5-72b", "cost": 0.002},
            {"model": "qwen3-32b", "cost": 0.001},
            {"model": "qwen3-8b", "cost": 0.0004},
        ]

    def route(self, prompt: str) -> str:
        for model_config in self.models:
            result = self.call_model(model_config["model"], prompt)
            if self.evaluate_quality(result) >= self.threshold:
                return result
        return self.call_model(self.models[0]["model"], prompt)
Das Problem ist die Bewertung selbst. Wie misst man Qualität, ohne ein anderes Modell aufzurufen? Einige Systeme verwenden einen kleinen Klassifizierer. Andere nutzen heuristische Prüfungen – Länge, Struktur, Vorhandensein von Schlüsselwörtern. Keine davon ist perfekt.
Strategie 2: Latenz-basierter Fallback
Latenz-basierter Fallback ist einfacher. Leiten Sie an das schnellste Modell weiter, das Ihr Zeitbudget erfüllt:
class LatencyFallback:
    def __init__(self, max_latency: float = 5.0):
        self.max_latency = max_latency
        self.models = [
            {"model": "qwen3-1.7b", "latency": 0.5},
            {"model": "qwen3-8b", "latency": 2.0},
            {"model": "qwen3-32b", "latency": 10.0},
            {"model": "claude-sonnet-4", "latency": 5.0},
        ]

    def route(self, prompt: str) -> str:
        for model_config in sorted(self.models, key=lambda x: x["latency"]):
            if model_config["latency"] <= self.max_latency:
                return self.call_model(model_config["model"], prompt)
        return self.call_model(self.models[0]["model"], prompt)
Caching
Caching ist die am meisten unterschätzte Kostenoptimierung. Identische Prompts passieren öfter, als man denkt – Klassifizierungsanfragen, FAQ-artige Abfragen, wiederholte Tool-Aufrufe.
Strategie 1: Prompt-Caching
Exaktes Prompt-Caching ist einfach:
import hashlib

class PromptCache:
    def __init__(self, max_size: int = 1000):
        self.cache = {}
        self.max_size = max_size

    def get(self, prompt: str) -> str | None:
        key = hashlib.sha256(prompt.encode()).hexdigest()
        return self.cache.get(key)

    def set(self, prompt: str, response: str):
        key = hashlib.sha256(prompt.encode()).hexdigest()
        if len(self.cache) >= self.max_size:
            self.cache.pop(next(iter(self.cache)))
        self.cache[key] = response
Strategie 2: Semantisches Caching
Semantisches Caching ist nützlicher. Es fängt Prompts ab, die sich unterscheiden, aber dasselbe bedeuten:
from sentence_transformers import SentenceTransformer

class SemanticCache:
    def __init__(self, similarity_threshold: float = 0.95):
        self.model = SentenceTransformer('all-MiniLM-L6-v2')
        self.cache = {}
        self.threshold = similarity_threshold

    def get(self, prompt: str) -> str | None:
        prompt_embedding = self.model.encode([prompt])[0]
        for cached_prompt, cached_response in self.cache.items():
            cached_embedding = self.model.encode([cached_prompt])[0]
            similarity = self.cosine_similarity(
                prompt_embedding, cached_embedding
            )
            if similarity >= self.threshold:
                return cached_response
        return None

    def set(self, prompt: str, response: str):
        self.cache[prompt] = response
Der Schwellenwert ist entscheidend. 0,95 ist aggressiv – nur sehr ähnliche Prompts werden abgeglichen. 0,85 ist nachsichtiger, birgt aber das Risiko, falsche Antworten zurückzugeben. Messen Sie Ihre Trefferquote und passen Sie den Wert an.
Antwort-Caching für häufige Abfragen lohnt sich ebenfalls. Wenn Benutzer wiederholt fragen „Wie ist das Wetter“ oder „Wie spät ist es“, cachen Sie das Muster, nicht nur den exakten Prompt:
class ResponseCache:
    def __init__(self):
        self.common_queries = {
            "what is the weather": "Check weather API",
            "what is the time": "Check system time",
            "who is the president": "Check current president",
        }

    def get(self, query: str) -> str | None:
        query_lower = query.lower()
        for common_query, response in self.common_queries.items():
            if common_query in query_lower:
                return response
        return None
Das ist nicht hochkomplex, aber es funktioniert. Häufige Abfragen sind häufig aus einem Grund.
Wann sich Optimierung lohnt
Optimierung ist wichtig, wenn Sie große Volumen verarbeiten, gemischte Workloads betreiben oder API-Kosten zahlen, die sich aufsummieren.
Sie ist nicht relevant, wenn Sie Prototypen bauen, ein einzelnes Modell verwenden oder geringe Volumina verarbeiten. Die Komplexität von Budgetierung, Fallback und Caching ist für ein System, das 100 Anfragen pro Tag macht, nicht lohnenswert.
Bringen Sie zuerst den grundlegenden Ablauf zum Laufen. Fügen Sie Optimierung hinzu, wenn die Rechnung eingeht.
Kompromisse
| Strategie | Kosten | Qualität | Komplexität |
|---|---|---|---|
| Keine Optimierung | Höchste | Konstant | Niedrigste |
| Token-Budgetierung | Mittel | Variabel | Mittel |
| Fallback-Modelle | Niedrig-Mittel | Variabel | Mittel |
| Caching | Niedrigste | Hoch (bei Cache-Treffern) | Mittel |
| Hybrid | Optimiert | Optimiert | Höchste |
Produktionsysteme laufen in der Regel hybrid. Budgetierung pro Sitzung, Fallback basierend auf Qualität oder Latenz, Caching was möglich ist. Die Komplexität ist real, aber auch die Ersparnisse.
Verwandte Artikel
- Datenanziehung: Die wahren Kosten von API-first AI – warum die oben genannte Break-even-Berechnung nur die Hälfte der Self-Hosting-Entscheidung ist
- Die effiziente Frontier offener Modelle im Jahr 2026 – die Modellgrößenökonomie hinter dem Break-even: ein 27B-Modell auf einer gemieteten 4090 im Vergleich zu aktuellen Sonnet-Token-Preisen
- Model Routing Strategien – fähigkeitsbasiertes, kostenbewusstes, latenzbewusstes Routing
- LLM-Guardrails in der Praxis – Eingabvalidierung, Ausgabefilterung, Sicherheit
- Multi-Modell-Systemdesign – Architektur für mehrere Modelle
- LLM-Architektur – Systemdesign-Pfeiler: Routing, Kosten, Guardrails und Orchestrierung
