
LLM-ASICs und spezielle Inferenz-Chips (warum sie wichtig sind)
ASICs und maßgeschneiderte Silizium-Chips erhöhen Geschwindigkeit und Effizienz der LLM-Inferenz
Die Zukunft der KI dreht sich nicht nur um intelligenter werdende Modelle. Sie bezieht sich auch auf Silizium-Verarbeitung, die genau dazu passt, wie diese Modelle tatsächlich bereitgestellt werden. Spezialisierte Hardware für LLM-Inferenz folgt dabei einem Weg, der an den Übergang des Bitcoin-Mining von GPUs zu speziell dafür entwickelten ASICs erinnert – allerdings mit strengeren Einschränkungen, da sich Modelle und Präzisionsverfahren ständig weiterentwickeln.
Für weitere Informationen zu Durchsatz, Latenz, VRAM und Benchmarks über verschiedene Laufzeitumgebungen und Hardware hinweg, siehe LLM-Leistung: Benchmarks, Engpässe & Optimierung.
 Elektrische Vorstellungskraft – Flux Text-zu-Bild-LLM.
Warum LLMs von inferenzspezifischer Hardware profitieren
Große Sprachmodelle haben die KI revolutioniert, doch jede flüssige Antwort basiert auf riesigen, vorhersehbaren Strömen aus Matrixmathe und Speicheraktivität. Da die Ausgaben für Inferenz wachsen – oft übertreffen sie im Laufe des Lebenszyklus eines Modells sogar die Trainingskosten – werden Chips, die für den Serving-Betrieb und nicht für jede mögliche Arbeitslast optimiert sind, wirtschaftlich attraktiv.
Die Analogie zum Bitcoin-Mining ist unvollkommen, aber lehrreich. Beide sind repetitive, klar umrissene Aufgaben, bei denen das Entfernen unnötiger Allzweckfunktionalität vom Chip die Durchsatzrate und die Joules pro nützlicher Operation erheblich steigern kann.
Was die Geschichte des Bitcoin-Minings über Inferenz-ASICs verrät
Das Bitcoin-Mining durchlief vier Generationen:
| Ära | Hardware | Hauptvorteil | Einschränkung |
|---|---|---|---|
| 2015–2020 | GPUs (CUDA, ROCm) | Flexibilität | Hoher Stromverbrauch, speicherlimitiert |
| 2021–2023 | TPUs, NPUs | Grob granuläre Spezialisierung | Immer noch trainingsorientiert |
| 2024–2025 | Transformer-ASICs | Auf Low-Bit-Inferenz optimiert | Begrenzte Allzwecktauglichkeit |
KI folgt einem ähnlichen Pfad. Jeder Übergang verbesserte die Leistung und Energieeffizienz um Größenordnungen.
Allerdings benötigen Inferenz-ASICs, anders als Bitcoin-ASICs (die nur SHA-256 berechnen), eine gewisse Flexibilität. Modelle entwickeln sich weiter, Architekturen ändern sich und Präzisschemata werden verbessert. Der Trick besteht darin, genau genug zu spezialisieren – die Kernmuster hartverdrahten, während man an den Rändern Anpassungsfähigkeit beibehält.
Wie LLM-Inferenz vom Training unterscheidet (und was Chips davon profitieren)
Inferenz-Workloads zeigen Muster, auf die spezialisierte Hardware gezielt reagieren kann:
- Geringe Präzision dominiert — 8-Bit, 4-Bit, sogar ternäre oder binäre Arithmetik funktionieren gut für die Inferenz
- Speicher ist der Engpass — Das Verschieben von Gewichten und KV-Caches verbraucht deutlich mehr Energie als die Berechnung selbst
- Latenz ist wichtiger als Durchsatz — Benutzer erwarten Tokens in unter 200 ms
- Massive Anfragengenauigkeit — Tausende gleichzeitiger Inferenzanfragen pro Chip
- Vorhersehbare Muster — Transformer-Schichten sind hochgradig strukturiert und können hartverdrahtet werden
- Dünnbesetztheits-Möglichkeiten (Sparsity) — Modelle nutzen zunehmend Techniken wie Pruning und MoE (Mixture-of-Experts)
Ein speziell für die Inferenz gebauter Chip kann diese Annahmen hartverdrahten, um eine 10- bis 50-mal bessere Leistung pro Watt gegenüber Allzweck-GPUs zu erzielen.
Wer entwickelt für LLMs optimiertes Inferenz-Silizium
Der Markt für Inferenz-ASICs umfasst etablierte Unternehmen, Wafer-Skalen-Designs und Start-ups, die auf transformer-förmiges Silizium setzen:
| Unternehmen | Chip / Plattform | Spezialisierung |
|---|---|---|
| Groq | LPU (Language Processing Unit) | Deterministischer Durchsatz für LLMs |
| Etched AI | Sohu ASIC | Hartverdrahteter Transformer-Engine |
| Tenstorrent | Grayskull / Blackhole | Generisches ML mit Mesh hoher Bandbreite |
| Taalas | HC1 (Llama 3.1 8B Produkt) / HC2 Roadmap | Modell-spezifisches „Hardcore“-Silizium; vereint Speicher und Compute |
| OpenAI × Broadcom | Eigener Inferenzchip | Gemutmaßte Einführung 2026 |
| Intel | Crescent Island | Nur für Inferenz konzipierte Xe3P GPU mit 160 GB HBM |
| Cerebras | Wafer-Scale Engine (WSE-3) | Massive On-Die Speicherbandbreite |
Ein Großteil davon ist bereits in produktiven Rechenzentren im Einsatz, nicht nur in Präsentationsfolien. Kleinere Teams wie d-Matrix, Rain AI, Mythic und Tenet verfolgen ebenfalls Architekturen, die für Low-Bit-Inferenz und strukturierte Dünnbesetztheit (Sparsity) optimiert sind.
Taalas HC1, Chat Jimmy und ultraschnelle Small-Model-Serving
Taalas ist ein jüngeres Beispiel für die Schule des „Nicht alles, aber fast alles spezialisieren“. Das Unternehmen argumentiert, dass die Grenze zwischen Speicher und Verarbeitung (Off-Chip-DRAM gegenüber On-Chip-SRAM) Kosten, Energieverbrauch und engineering-komplexität für die Inferenz dominiert, und dass modellspezifisches Silizium – was sie Hardcore Models nennen – diese Grenze zusammenbrechen lassen kann, wenn eine Bereitstellung bereit ist, die Gewichte und den Graphen zu fixieren.
Ihr erstes lieferbares Produkt, HC1, hat eine Variante von Llama 3.1 8B hartverdrahtet. Diese Wahl ist pragmatisch: Das Modell ist klein genug, um schnell in Betrieb genommen zu werden, ist offen dokumentiert und nützt immer noch für viele Automatisierungs-, Klassifizierungs- und Entwurfsaufgaben, bei denen die rohe Tiefe der Schlussfolgerung weniger wichtig ist als Latenz und Kosten. Taalas berichtet über etwa 16k–17k dekoderte Tokens pro Sekunde pro Benutzer für diese Konfiguration (die Vendor-Methodik und Vergleiche finden sich in ihrem Bericht), zusammen mit Behauptungen großer Gewinne bei Kapital- und Energieausgaben gegenüber konventionellen GPU-Stacks für dieselbe Modellklasse. Die Bauteile der ersten Generation nutzen aggressives gemischtes Low-Bit-Speicherverfahren; das Unternehmen beschreibt den Übergang zu standardisierten 4-Bit-Schwebekomma-Formaten auf HC2, um Spielraum bei der Qualität zurückzugewinnen.
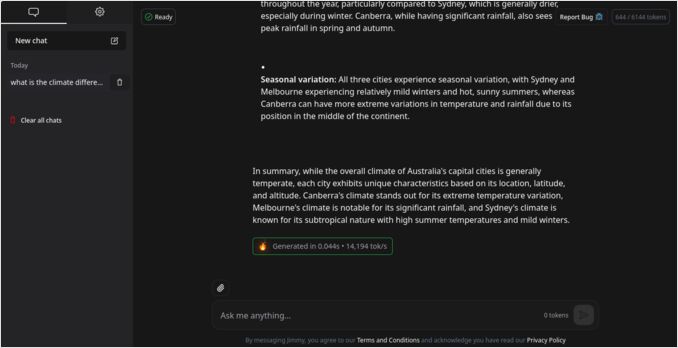
Für Entwickler, die spüren wollen, was diese Durchsatzklasse in der Praxis bedeutet, bietet Taalas einen kostenlosen Chatbot-Demo, Chat Jimmy, und stellt API-Zugriff über ein Antragsformular auf ihrer Website bereit. Es ist ausdrücklich ein Proof of Concept – kein Frontier-Assistent – aber es veranschaulicht eine reale Zielgruppe, die ein bescheidenes Modell bei „menschlicher Kognitionsgeschwindigkeit“ einem größeren Modell vorziehen kann, das sich schlampig oder teuer anfühlt.
Architektur eines Transformer-Inferenz-ASICs
Wie sieht ein für Transformer optimierter Chip unter der Haube tatsächlich aus?
+--------------------------------------+
|         Host-Schnittstelle           |
|   (PCIe / CXL / NVLink / Ethernet)   |
+--------------------------------------+
|  On-Chip-Interconnect (Mesh/Ring)    |
+--------------------------------------+
|  Compute-Tiles / Kerne               |
|   — Dichte Matrix-Multiplikations-Einheiten      |
|   — Low-Präzision (int8/int4) ALUs   |
|   — Dequant / Aktivierungs-Einheiten       |
+--------------------------------------+
|  On-Chip-SRAM & KV-Cache-Puffer     |
|   — Heiße Gewichte, fusionierte Caches        |
+--------------------------------------+
|  Quantisierung / Dequant-Pipelines    |
+--------------------------------------+
|  Scheduler / Controller              |
|   — Statischer Graph-Ausführungsmotor    |
+--------------------------------------+
|  Off-Chip-DRAM / HBM-Schnittstelle       |
+--------------------------------------+
Wichtige architektonische Merkmale umfassen:
- Compute-Kerne — Dichte Matrix-Multiplikations-Einheiten, optimiert für int8, int4 und ternäre Operationen
- On-Chip-SRAM — Große Puffer halten heiße Gewichte und KV-Caches, was teure DRAM-Zugriffe minimiert
- Streaming-Interconnects — Topologie im Mesh ermöglicht effizientes Skalieren über mehrere Chips hinweg
- Quantisierungsmodule — Echtzeit-Quantisierung/Dequantisierung zwischen Ebenen
- Compiler-Stack — Übersetzt PyTorch-/ONNX-Graphen direkt in chip-spezifische Mikro-Operationen
- Hartverdrahtete Attention-Kerne — Eliminiert Overhead durch Steuerfluss für Softmax und andere Operationen
Die Designphilosophie spiegelt Bitcoin-ASICs wider: Jeder Transistor dient der spezifischen Arbeitslast. Kein verschwendetes Silizium für Funktionen, die die Inferenz nicht braucht.
GPU- gegenüber ASIC-Benchmarks für LLM-Inferenz
Repräsentative öffentliche Zahlen zeigen, wie spezialisierte Inferenzhardware sich von Allzweck-GPU-Stacks auf denselben Modellfamilien absetzen kann (die Methodik und Batchannahmen für Ihre eigenen Workloads immer verifizieren):
| Modell | Hardware | Durchsatz (Tokens/s) | Zeit bis zum ersten Token | Leistungs-Multiplikator |
|---|---|---|---|---|
| Llama-2-70B | NVIDIA H100 (8x DGX) | ~80–100 | ~1,7 s | Basis (1×) |
| Llama-2-70B | Groq LPU | 241–300 | 0,22 s | 3–18× schneller |
| Llama-3.3-70B | Groq LPU | ~276 | ~0,2 s | Konstant 3× |
| Gemma-7B | Groq LPU | 814 | <0,1 s | 5–15× schneller |
| Llama-3.1-8B | Taalas HC1 (Vendor) | ~16k–17k dekod. t/s/Benutzer | — | Eigene Achse (fixierter 8B-Graph, kein 70B) |
Quellen: Groq.com, ArtificialAnalysis.ai, NVIDIA Developer Blog; die Taalas-HC1-Zahlen stammen aus dem Produktpost des Unternehmens.
Die auf Groq bezogenen Zeilen zeigen erhebliche Gewinne im Durchsatz und bei der Zeit bis zum ersten Token gegenüber einem High-End-GPU-Basiswert bei großen Modellen. Die Taalas-Zeile ist kein weiterer Multiplikator gegenüber jenen 70B-Zeilen; sie veranschaulicht, wie weit der pro Benutzer dekodieren kann, wenn das Modell und der Graph im Silizium fixiert sind, auf Kosten der Flexibilität.
Abwägungen bei der Spezialisierung von Inferenz-Silizium
Spezialisierung erkauft sich Leistung, führt aber zu produkt- und engineering-bezogenen Risiken zurück:
-
Flexibilität versus Effizienz. Ein vollständig fixierter ASIC raschert durch heutige Transformer-Modelle, könnte aber bei morgen Architekturen an Grenzen stoßen. Was passiert, wenn sich Attention-Mechanismen weiterentwickeln oder neue Modellfamilien auftauchen? Das ist keine Hypothese – State-Space-Modelle, Diffusion-Sprachmodelle und JEPA-Weltmodelle fordern bereits die Dominanz des Transformers auf der Modellseite heraus; siehe Was kommt nach LLMs, wo diese Architekturen hartverdrahtete Transformer-Silizium möglicherweise lassen.
-
Quantisierung und Genauigkeit. Geringere Präzision spart enorme Mengen an Energie, aber das Management von Genauigkeitsverlusten erfordert ausgefeilte Quantisierungsschemata. Nicht alle Modelle quantisieren sich reibungslos auf 4-Bit oder darunter.
-
Software-Ökosystem. Hardware ohne robuste Compiler, Kerne und Frameworks ist nutzlos. NVIDIA dominiert immer noch maßgeblich wegen des ausgereiften CUDA-Ökosystems. Neue Chip-Hersteller müssen stark in Software investieren.
-
Kosten und Risiko. Das Maskenlayout (Tape-out) eines Chips kostet mehrere Millionen Dollar und dauert 12–24 Monate. Für Start-ups ist dies eine enorme Wette auf architektonische Annahmen, die sich vielleicht nicht bewahrheiten werden.
Dennoch führen selbst 2× effizientere Lösungen bei Hyperskalen zu Milliarden an Einsparungen. Für Cloud-Anbieter mit Millionen von Inferenzanfragen pro Sekunde wird maßgeschneidertes Silizium zunehmend unverzichtbar.
Eine Wunschliste für einen LLM-Inferenz-Chip
| Merkmal | Ideale Spezifikation |
|---|---|
| Prozess | 3–5 nm Prozessknoten |
| On-Chip-SRAM | 100 MB+ fest gekoppelt |
| Präzision | Nativer int8 / int4 / ternärer Support |
| Durchsatz | 500+ Tokens/Sek. (70B-Modell) |
| Latenz | <100 ms Zeit bis zum ersten Token |
| Interconnect | Niedrige Latenz im Mesh oder optische Verbindungen |
| Compiler | PyTorch/ONNX → Mikrocode-Toolchain |
| Energie | <0,3 Joules pro Token |
Ausblick (2026–2030)
Man kann davon ausgehen, dass sich das Inferenz-Hardware-Umfeld in drei grobe Ebenen stratifizieren wird:
-
Trainingschips. High-End-GPUs wie NVIDIA B200 und AMD Instinct MI400 werden ihr Dominanz beim Training dank ihrer FP16/FP8-Flexibilität und ihrer massiven Speicherbandbreite weiter behalten.
-
Inferenz-ASICs. Hartverdrahtete, Low-Präzision-Transformer-Beschleuniger werden den Produktions-Serving bei Hyperskalern übernehmen, optimiert auf Kosten und Effizienz.
-
Edge-NPUs. Kleine, ultraeffiziente Chips werden quantisierte LLMs auf Smartphones, Fahrzeuge, IoT-Geräte und Roboter bringen und damit Geräteintelligenz ohne Cloud-Abhängigkeit ermöglichen.
Über die Hardware hinaus werden wir sehen:
- Hybride Cluster — GPUs für flexibles Training, ASICs (oder Wafer-Skalen-Inferenz-Engines) für effizientes Serving
- Inferenz-as-a-Service — Hyperscaler mischen erste Partei-Beschleuniger (AWS Inferentia, Google TPU und andere) mit GPUs
- Hardware-Software-Codesign — Modelle, die für Block-Dünnbesetztheit (Sparsity), MoE-Routing und quantisierungsfreundliche Ebenen geformt sind
- Modell- oder Familien-spezifisches Silizium — Firmen wie Taalas wetten, dass einige Bereitstellungen architektonische Flexibilität gegen extreme Kosten und Latenz auf einem bekannten Graphen tauschen
- Offene Inferenz-APIs — Druck, Serving-Schnittstellen portabel zu halten, auch wenn das Silizium nicht portabel ist
Abschließende Gedanken
Die „ASIC-isierung“ der KI-Inferenz ist bereits im Gange. So wie das Bitcoin-Mining von CPUs zu spezialisiertem Silizium evolviert ist, folgt auch der KI-Einsatz demselben Pfad.
Die nächste Revolution in der KI wird nicht um größere Modelle gehen – sie wird um bessere Chips gehen. Hardware, die für die spezifischen Muster der Transformer-Inferenz optimiert ist, wird bestimmen, wer KI wirtschaftlich in großem Maßstab bereitstellen kann.
So wie Bitcoin-Miner jede verschwendete Watt optimierten, wird Inferenzhardware jeden letzten FLOP pro Joule ausquetszen. Wenn dies geschieht, wird der eigentliche Durchbruch nicht in den Algorithmen liegen – er wird im Silizium liegen, das sie ausführt.
Die Zukunft der KI wird in Silizium graviert, ein Transistor nach dem anderen.
Für weitere Benchmarks, Hardwareauswahl und Leistungstuning, schauen Sie in unser Hub LLM-Leistung: Benchmarks, Engpässe & Optimierung.
Nützliche Links
- Groq Offizielle Benchmarks
- Taalas — Der Weg zu allgegenwärtiger KI (HC1, Roadmap, Philosophie)
- Chat Jimmy — Taalas Llama 3.1 8B Demo
- Taalas API-Zugriffs-Antragsformular
- Artificial Analysis - LLM-Leistungs-Rangliste
- NVIDIA H100 Technisches Briefing
- Etched AI - Transformer-ASIC-Ankündigung
- Cerebras Wafer-Scale Engine
- Preise der NVidia RTX 5080 und RTX 5090 in Australien - Oktober 2025
- LLM-Leistung und PCIe-Lanes: Wichtige Überlegungen
- Large Language Models Geschwindigkeitstest
- Vergleich der Eignung von NVidia-GPUs für KI
- Ist die Quadro RTX 5880 Ada 48GB gut?
