
Spekulatives Dekodieren: 20–50 % schnellere LLM-Inferenz
Schnellere LLM-Inferenz ohne Qualitätsverlust – Ein praktischer Leitfaden
Ein 70B-Modell erzeugt pro Vorwärtsdurchlauf ein einzelnes Token, wobei jeder Durchlauf Gewichte aus dem VRAM neu lädt, die Aufmerksamkeit über den gesamten Kontext berechnet und den Speicher synchronisiert. Zwischen den Tokens verbringt die GPU Zeit im Leerlauf, während sie darauf wartet, dass sequenzielle Abhängigkeiten aufgelöst werden.
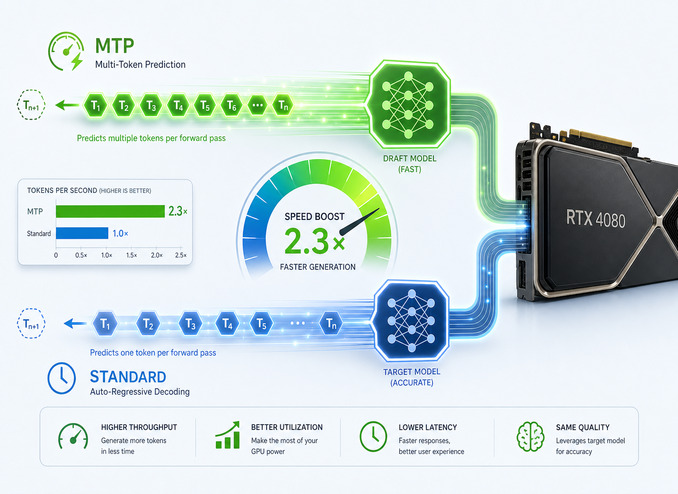
Auf einem H100 erzeugt ein 70B-Modell ein Token alle 30–50 ms. Die GPU verfügt über genügend Rechenkapazität, um mehrere Token parallel zu verarbeiten, doch die sequenzielle Abhängigkeit verhindert dies – jedes Token hängt vom vorherigen ab, und die Pipeline stockt.
Spekulatives Dekodieren (Speculative Decoding) umgeht diese Engstelle, indem es ermöglicht, mehrere Token in der Zeit zu generieren, die normalerweise für die Generierung eines einzelnen Tokens benötigt wird, ohne dabei die Ausgabeverteilung zu ändern. Die erhaltenen Token sind statistisch identisch zu den Ergebnissen des Standard-Autoregressiven Dekodierens; der einzige Unterschied liegt in der Geschwindigkeit ihrer Lieferung.
Dieser Guide behandelt die Mechanik, die 2026 verfügbaren Varianten, Kompromisse bei der Akzeptanzrate sowie die praktische Einrichtung in llama.cpp, vLLM, SGLang und TensorRT-LLM.
So funktioniert autoregressives Dekodieren (und warum es langsam ist)
Bevor man spekulatives Dekodieren verstehen kann, muss man die autoregressive Einschränkung verstehen, die es umgeht. Das Standard-Autoregressive-Generierungsverfahren verarbeitet Token sequenziell:
- Führe einen Vorwärtsdurchlauf durch das Modell mit dem aktuellen Kontext aus.
- Wahle das nächste Token aus der Ausgabeverteilung.
- Füge das Token dem Kontext hinzu.
- Wiederhole den Vorgang.
Jeder Schritt erfordert einen vollständigen Vorwärtsdurchlauf – das Laden der Gewichte aus dem VRAM, die Berechnung der Aufmerksamkeit über den gesamten Kontext und die Erzeugung eines einzelnen Tokens. Für ein Modell mit 70 Milliarden Parametern dauert dies auf einem H100 etwa 30–50 ms pro Token. Die GPU hat noch Rechenkapazität übrig – sie könnte mehr Arbeit parallel verarbeiten – aber die sequenzielle Abhängigkeit verhindert dies.
Die Lücke zwischen Rechenleistung und VRAM
Moderne GPUs bieten mehr FLOPs (Fließkommaberechnungen pro Sekunde), als für die Einzel-Token-Generierung benötigt werden. Daher ist die eigentliche Engstelle die Speicherbandbreite – die Gewichte müssen bei jedem Vorwärtsdurchlauf vom VRAM zu den Recheneinheiten gestreamt werden. Bei der Generierung eines Tokens nach dem anderen verbringt die GPU die meiste Zeit mit dem Warten auf Speichermigrationen statt mit nützlicher Berechnung.
Spekulatives Dekodieren adressiert dies, indem es der GPU mehr Arbeit pro Speichermigration verschafft. Statt eines Tokens pro Vorwärtsdurchlauf erzeugt es K Token pro Durchlauf und verteilt die Speicherkosten auf mehrere Ausgaben.
Der Draft-Verify-Mechanismus
Spekulatives Dekodieren arbeitet in wiederholten Draft-Verify-Zyklen. Ein schneller Draft-Mechanismus schlägt K Kandidaten-Token vor – sei es von einem kleinen Draft-Modell, einer N-Gramm-Nachschlage oder einem Prädiktionskopf, der an das Zielmodell angeschlossen ist – und das Zielmodell verifiziert alle K in einem einzigen Vorwärtsdurchlauf. Die Draft-Phase ist günstig und dauert typischerweise 5–20 % der Zeit des Vorwärtsdurchlaufs des Zielmodells, während die Verifikation jedes entworfenen Token mit dem vergleicht, was das Zielmodell erzeugt hätte. Dabei wird der längste übereinstimmende Präfix akzeptiert und ab der ersten Ablehnung wird neu gesampelt.
Die Verifikation von K Token kostet etwa so viel wie die autoregressive Generierung eines einzelnen Tokens. Wenn der Entwurf also korrekt ist, erhält man K Token für den Preis eines einzigen Verifikationsschrittes.
Ein konkretes Beispiel
Angenommen, das Draft-Modell schlägt 5 Token vor: ["I", " like", " cooking", " and", " traveling"]. Das Zielmodell verifiziert sie in einem einzigen Vorwärtsdurchlauf:
| Token | Entwurf (Draft) | Zielmodell einverstanden? |
|---|---|---|
| 1 | “I” | ✓ |
| 2 | " like" | ✓ |
| 3 | " cooking" | ✗ (Zielmodell würde „playing“ sagen) |
| 4 | " and" | — (nicht ausgewertet) |
| 5 | " traveling" | — (nicht ausgewertet) |
Das Zielmodell akzeptiert die Token 1 und 2, generiert dann „playing“ für Token 3 und erzeugt somit drei Token in einem Zyklus, anstatt drei separate Vorwärtsdurchläufe zu benötigen. Hätte der Entwurf bis Token 5 korrekt vorgelegen, hätte man fünf Token für den Kosten eines Verifikationsschrittes erhalten – eine 5-fache Beschleunigung allein in diesem Zyklus.
Die Verifikations-Engstelle
In der Praxis dominiert die Verifikation die Laufzeit – je nach Methode und Modellgröße macht sie 42–95 % des Zyklus aus. Der Vorwärtsdurchlauf des Zielmodells ist die Engstelle, und abgelehnte Token stellen vergeudete Rechenleistung dar.
Deshalb ist die Akzeptanzrate so wichtig. Jedes abgelehnte Token nach dem ersten ist verschwendete Verifikationsarbeit. Die besten spekulativen Dekodiermethoden maximieren die erwartete Anzahl akzeptierter Token pro Zyklus, nicht nur die rohe Akzeptanzrate.
Die mathematische Garantie
Eine der wichtigsten Eigenschaften des spekulativen Dekodierens ist, dass es Token aus derselben exakten Verteilung erzeugt wie das Standard-Autoregressive-Sampling aus dem Zielmodell. Der Verifikationsschritt verwendet Abweisungssampling (Rejection Sampling) – wenn der Entwurf Token x vorschlägt, berechnet das Zielmodell seine eigene Wahrscheinlichkeit p(x) und der Entwurf berechnet p_draft(x). Die Akzeptanzwahrscheinlichkeit lautet:
min(1, p(x) / p_draft(x))
Wenn das Zielmodell zustimmt (p(x) ≥ p_draft(x)), wird das Token immer akzeptiert. Wenn das Zielmodell nicht zustimmt, wird das Token mit einer Wahrscheinlichkeit akzeptiert, die proportional zum Verhältnis ist, und abgelehnte Token werden aus einer Restverteilung neu gesampelt:
r(x) = max(0, p(x) - p_draft(x)) / Σ max(0, p(y) - p_draft(y))
Dieses Verfahren garantiert, dass die Ausgabe-Sequenz exakt der Verteilung des Zielmodells folgt, weshalb spekulatives Dekodieren verlustfrei (lossless) ist. Das Draft-Modell beeinflusst nur die Geschwindigkeit, nicht die Qualität – die erhaltenen Token sind statistisch nicht von Standard-Dekodierung zu unterscheiden, mit derselben Perplexität und derselben Verteilung. Der einzige Unterschied ist die Latenz.
Strategien für Draft-Modelle
Der Draft-Mechanismus ist die Variable, die am meisten zählt. Verschiedene Ansätze haben unterschiedliche Kompromisse zwischen Einrichtungsaufwand, Akzeptanzrate und Beschleunigung.
Unabhängige Draft-Modelle
Der einfachste Ansatz lädt ein kleineres Modell neben dem Zielmodell – typischerweise ein 1B- bis 3B-Modell, das für ein 7B- bis 70B-Zielmodell entwurfet.
Vorteile:
- Konzeptuell einfach
- Funktioniert mit jedem Zielmodell
- Das Draft-Modell kann so abgestimmt werden, dass es die Verteilung des Zielmodells annähert
Nachteile:
- Erfordert das Laden eines zweiten Modells in den VRAM (1–4 GB, je nach Größe)
- Die Qualität des Draft-Modells bestimmt direkt die Akzeptanzrate
- Cross-Family-Entwürfe (z. B. Qwen, das für Llama entwurfet) funktionieren typischerweise schlecht
Faustregel: Verwenden Sie Modelle aus derselben Familie. Gemma 2 2B entwurfet gut für Gemma 2 27B. Llama 3.2 1B entwurfet gut für Llama 3.1 70B. Cross-Family-Entwürfe neigen dazu, niedrige Akzeptanzraten zu haben, da sich die Token-Verteilungen unterscheiden.
Passende Draft-Modelle finden
Nicht alle kleinen Modelle eignen sich als Draft-Modelle für ein gegebenes Zielmodell. Der entscheidende Faktor ist die Verteilungskongruenz – wie eng die Wahrscheinlichkeiten der Ausgabe des Draft-Modells mit denen des Zielmodells übereinstimmen.
| Zielmodell | Empfohlenes Draft | Familien-Match |
|---|---|---|
| Llama 3.1 70B | Llama 3.2 1B-3B | Gleich |
| Llama 3.1 8B | Llama 3.2 1B | Gleich |
| Qwen 3 27B | Qwen 3 0.6B-1.8B | Gleich |
| Gemma 2 27B | Gemma 2 2B | Gleich |
| Mixtral 8x7B | Phi-3 4B (auf Mixtral-Daten trainiert) | Cross (Vorsicht) |
Die goldene Regel: Wenn die Akzeptanzrate des Draft-Modells unter 50 % fällt, kann spekulatives Dekodieren tatsächlich langsamer machen. Der Overhead des laufenden Draft-Modells plus die Verifikation übersteigt den Nutzen, wenn die meisten Vorschläge abgelehnt werden.
EAGLE und EAGLE-3: Prädiktionsköpfe
EAGLE (Efficient Architecture Guided Language Model Estimation) eliminiert die Notwendigkeit eines separaten Draft-Modells. Stattdessen werden leichte autoregressive Prädiktionsköpfe an die internen Ebenen des Zielmodells angeschlossen.
So funktioniert EAGLE
EAGLE trainiert Prädiktionsköpfe, die verborgene Zustände (Hidden States) von den Zwischenebenen des Zielmodells entgegennehmen und zukünftige Token vorhersagen. Während der Inferenz:
- Führt das Zielmodell einen Vorwärtsdurchlauf durch seine Ebenen aus.
- Liest der EAGLE-Kopf an jeder Ebene den verborgenen Zustand und schlägt Token für zukünftige Positionen vor.
- Mehrere Köpfe arbeiten parallel, wobei jeder ein anderes zukünftiges Zeitschritt vorhersagt.
- Das Zielmodell verifiziert alle Vorschläge in einem einzigen Durchlauf.
Der Vorteil: EAGLE-Köpfe werden spezifisch darauf trainiert, die Verteilung des Zielmodells zu matchen. Sie sehen die internen Repräsentationen des Zielmodells direkt, was ihnen eine viel bessere Kongruenz verleiht als ein unabhängiges Draft-Modell.
Verbesserungen in EAGLE-3
EAGLE-3 (2025) verfeinert den Ansatz mit drei wesentlichen Änderungen:
- Ebenen-Auswahl: Anstatt Köpfe an jede Ebene anzuhängen, verwendet EAGLE-3 Bayes-Optimierung, um die optimale Ausgangsebene auszuwählen und Overhead zu reduzieren.
- Multi-Token-Vorhersage: Jeder Kopf sagt mehrere Token gleichzeitig vorher, wodurch die Entwurfstiefe erhöht wird, ohne proportional erhöhte Rechenkosten.
- Trainings-Effizienz: EAGLE-3 trainiert auf den eigenen Generierungsdaten des Zielmodells, was die Akzeptanzraten bei Workloads innerhalb der Verteilung (in-distribution) verbessert.
Akzeptanzraten: EAGLE-3 erzielt typischerweise Akzeptanzraten von 60–80 % bei In-Distribution-Workloads, im Vergleich zu 40–60 % bei unabhängigen Draft-Modellen. Bei Code-Generierungs-Workloads mit hoher Wiederholung kann die Akzeptanz 85 % übersteigen.
Einrichtung: EAGLE-3 erfordert vorgetrainede Köpfe für Ihr Zielmodell. NVIDIA stellt EAGLE-3-Köpfe für mehrere beliebte Modelle über TensorRT-LLM und die Sammlung „Speculative Decoding Modules“ auf HuggingFace bereit. Drittanbieter-Implementierungen existieren für vLLM und SGLang.
P-EAGLE: Parallel Drafting (März 2026)
Die Hauptbeschränkung von EAGLE-3 ist das autoregressive Drafting – jedes Draft-Token hängt vom vorherigen ab, sodass die Generierung von K Draft-Tokens K sequenzielle Vorwärtsdurchläufe durch den Draft-Kopf erfordert und der Draft-Overhead linear mit K wächst. P-EAGLE hebt diese Obergrenze auf, indem es alle K Draft-Tokens in einem einzigen Vorwärtsdurchlauf durch einen leichten 4-Ebenen-Drafter erzeugt, der darauf trainiert wurde, bis zu 10 Token parallel vorherzusagen.
Das Ergebnis: P-EAGLE liefert eine bis zu 1,69-fache Beschleunigung gegenüber vanilla EAGLE-3 bei realen Workloads auf NVIDIA B200. Der Vorteil wächst bei höheren K-Werten – dort, wo das sequenzielle Drafting von EAGLE-3 zur Engstelle wird, verursacht das parallele Drafting von P-EAGLE keine zusätzlichen Kosten.
Einrichtung in vLLM: Laden Sie einen vorgetraineten P-EAGLE-Kopf von HuggingFace herunter, setzen Sie "parallel_drafting": true in Ihrer vLLM-Konfiguration und verwenden Sie denselben --speculative-model-Flag – vLLM erledigt den Rest. P-EAGLE ist der aktuelle Stand der Technik für EAGLE-basiertes spekulatives Dekodieren, und wenn Sie 2026 EAGLE deployen, ist P-EAGLE die Variante, die Sie verwenden sollten.
N-Gramm-speekulatives Dekodieren
N-Gramm-speekulatives Dekodieren ersetzt ein neuronales Draft durch Mustervergleich mit der Prompt-Historie. Der Algorithmus sucht nach wiederholten N-Gramm-Sequenzen im Kontext; wenn die aktuelle Token-Sequenz einem zuvor gesehenen Muster entspricht, schlägt er die Token vor, die diesem Muster früher folgten – beispielsweise, wenn das Modell bereits def calculate_total(items): generiert hat und erneut auf def calculate_total( trifft, weiß es, dass die nächsten Token wahrscheinlich items): sein werden, basierend auf dem früheren Auftreten.
Die N-Gramm-Karten-Varianten (ngram-map-k, ngram-map-k4v) verwenden Hashtabellen für schnellere Nachschlagen statt linearer Scans, wobei der Hash-Schlüssel das aktuelle N-Gramm der Größe N ist und der Wert die Token-Sequenz ist, die folgte.
Vorteile:
- Null VRAM-Overhead – kein zusätzliches Modell zu laden (~16 MB für die Hashtabelle)
- Extrem schnell für repetitive Workloads (Code-Bearbeitung, Refactoring, Template-Generierung)
- Akzeptanzraten können 90 %+ erreichen bei Workloads mit hoher Selbstähnlichkeit
Nachteile:
- Unnützlich für neuartige Generierung – wenn das Muster nicht vorher aufgetreten ist, hat N-Gramm nichts vorzuschlagen
- Akzeptanzrate fällt auf nahezu null bei kreativen oder vielfältigen Workloads
- Begrenzte Entwurfstiefe (typischerweise 2–4 Token pro Match)
Am besten für: Code-Refactoring, Template-Ausfüllen, repetitive Dokumentation und jeden Workload, bei dem das Modell ähnliche Muster erneut besucht. Am schlechtesten für: kreatives Schreiben, offene Chats und Reasoning-Aufgaben.
Parameter-Einstellung
Die N-Gramm-Parameter sind wichtiger, als man denkt. Die Standardwerte funktionieren für Code, aber Text-Workloads benötigen Anpassung:
| Parameter | Standard | Code | Text | Hinweise |
|---|---|---|---|---|
size-n (Länge der Nachschlage) |
12 | 12-16 | 8-10 | Längere N-Gramm reduzieren False Positives, aber übersehen kürzere Muster |
size-m (Länge des Entwurfs) |
48 | 48 | 32 | Längere Entwürfe bedeuten mehr Token pro Match, aber auch mehr Ablehnungen |
min-hits |
1 | 1 | 2 | Höherer min-hits reduziert False Positives auf Kosten weniger Matches |
Für Text-Workloads reduzieren Sie size-n auf 8–10 und erhöhen Sie min-hits auf 2. Dies tauscht Match-Häufigkeit gegen höhere Akzeptanzraten pro Match ein.
Self-Spekulatives Dekodieren
Self-Spekulatives Dekodieren (auch LayerSkip oder Self-Speculation genannt) verwendet die eigene teilweise Berechnung des Modells als Entwurf, sodass kein separates Modell benötigt wird.
So funktioniert es
Anstatt das vollständige Modell für jedes Token auszuführen, führt self-spekulatives Dekodieren eine abgeschnittene Version aus – einige Transformer-Ebenen werden übersprungen –, um Draft-Tokens kostengünstig zu generieren, und das vollständige Modell verifiziert dann die Vorschläge.
Zum Beispiel könnte ein 32-Ebenen-Modell nur mit 16 Ebenen für das Drafting laufen und dann mit allen 32 Ebenen verifizieren. Der abgeschnittene Vorwärtsdurchlauf ist schneller, weil er weniger Ebenen verarbeitet, und die Draft-Tokens profitieren davon, dieselben anfänglichen Ebenen wie das Ziel zu sehen.
Vorteile:
- Keine zusätzlichen Modellgewichte zu laden
- Natürliche Kongruenz mit der Zielverteilung (gleiche Architektur, teilweise Ebenen)
- Funktioniert gut für Modelle mit erheblicher Redundanz in tieferen Ebenen
Nachteile:
- Erfordert Modifikationen des Inferenz-Engines, um teilweise Vorwärtsdurchläufe zu unterstützen
- KV-Cache-Komplikationen – der Entwurf verwendet einen teilweisen KV-Cache, der mit dem Cache des vollständigen Modells abgeglichen werden muss
- Akzeptanzraten sind typischerweise niedriger als bei EAGLE oder gut abgestimmten Draft-Modellen
llama.cpp-Implementierung: PR #18471 führte self-spekulatives Dekodieren ein, indem es die Kontexthistorie als Entwurf verwendet. Das Modell wiederholt Token aus seiner eigenen Generierungshistorie, um Fortsetzungen vorzuschlagen, was besonders effektiv für Coding-Workloads ist, in denen sich Muster innerhalb desselben Kontextfensters wiederholen.
MTP (Multi-Token Prediction)
MTP ist eine spezialisierte Form des spekulativen Dekodierens, die direkt in bestimmte Modell-Checkpoints integriert ist. Qwen 3.6 liefert sowohl Standard- als auch MTP-fähige GGUF-Varianten.
Unterschiede: MTP-Köpfe werden während des Trainings in die Modellarchitektur eingebaut. Das Modell trägt zusätzliche Prädiktionsköpfe, die mehrere zukünftige Token in einem einzigen Vorwärtsdurchlauf vorschlagen. Es gibt kein separates Draft-Modell – die MTP-Köpfe sind Teil des Zielmodells selbst.
Kompromisse:
- Kein Draft-Modell zu verwalten – MTP wird mit
--spec-type draft-mtp --spec-draft-n-max Naktiviert - MTP-Köpfe verursachen ~1–2 GB VRAM-Overhead
- Funktioniert am besten mit MoE-Architekturen (Qwen 3.6 35B-A3B), wo sparsames Routing die MTP-Köpfe günstig hält
Für detaillierte Benchmarks zu MTP im Vergleich zu Standard-Dekodierung über Qwen 3.6 27B und 35B, siehe Qwen 3.6 MTP vs Standard on 16GB GPU.
Akzeptanzraten: Was sie in der Praxis bedeuten
Die Akzeptanzrate (α) ist der wichtigste einzelne Indikator für die Leistung des spekulativen Dekodierens. Sie bestimmt, ob Sie eine Beschleunigung erhalten oder Overhead zahlen.
Die Beschleunigungsformel
Erwartete akzeptierte Token pro Verifikationsdurchlauf:
E[accepted] = α × K
Wobei K die Anzahl der pro Zyklus vorgeschlagenen Draft-Tokens ist. Wenn α = 0,7 und K = 5, akzeptieren Sie 3,5 Token pro Durchlauf – eine 3,5-fache Beschleunigung gegenüber dem Standard-Dekodieren (das 1 Token pro Durchlauf erzeugt).
Akzeptanzrate nach Methode
| Methode | Typischer α-Bereich | Bester Workload |
|---|---|---|
| Draft-Modell (gleiche Familie) | 40-60% | Allgemeiner Chat, Reasoning |
| Draft-Modell (cross-family) | 20-40% | Selten empfohlen |
| EAGLE-3 | 60-80% | Allgemeine Workloads, Code |
| P-EAGLE | 65-85% | Allgemeine Workloads, tiefere Spekulation |
| n-gram | 10-90%+ | Workload-abhängig (hoch bei repetitiv, nahe null bei neuartig) |
| MTP | 50-70% | Spezifisch für Qwen 3.6 Modelle |
| Self-spekulativ | 30-50% | Coding, repetitive Muster |
Wenn die Akzeptanzrate sinkt
Die Akzeptanzrate ist während einer Generierung nicht konstant. Sie variiert nach:
- Token-Position: Frühe Token neigen dazu, eine höhere Akzeptanz zu haben (mehr Kontext, weniger Unsicherheit). Spätere Token sinken, da das Modell vielfältigere Fortsetzungen erkundet.
- Workload-Typ: Code-Bearbeitung mit wiederholten Mustern sieht α > 80 %. Offenes kreatives Schreiben sieht α < 40 %.
- Temperatur: Höhere Temperatur erhöht die Divergenz zwischen Entwurf und Ziel und senkt die Akzeptanz. Spekulatives Dekodieren funktioniert am besten bei niedriger Temperatur (0,0–0,7).
Kritischer Schwellenwert: Wenn Ihre effektive Akzeptanzrate (α × K) unter 1,0 fällt, ist spekulatives Dekodieren langsamer als Standard-Dekodierung. Der Draft-Overhead plus die Verifikationszeit übersteigt die Kosten eines einzelnen autoregressiven Schrittes.
Spekulatives Dekodieren in Produktion: Was tatsächlich passiert
Forschungspapiere berichten über 2- bis 4-fache Beschleunigungen, aber Produktions-Benchmarks erzählen eine differenziertere Geschichte – Beschleunigungen schrumpfen mit der Batch-Größe, die Verifikation dominiert die Zykluszeit und keine einzelne Methode gewinnt bei jedem Workload.
Erkenntnisse aus SpecDecode-Bench (2026)
Eine systematische Bewertung von fünf SD-Varianten (n-gram, EAGLE, EAGLE-3, Draft-Model, MTP) in vLLM über vier Modelle und sechs Workloads ergab:
-
SD funktioniert, aber Beschleunigungen schrumpfen mit der Batch-Größe. Bei Batch-Größe 1 erzielt EAGLE bis zu 1,96x bei Llama-3-70B. Bei Batch-Größe 128 fällt dies auf 1,21x. Das System wird bei hoher Konkurrenz rechengebunden, und die GPU hat weniger Leerlauf-Kapazität, die für Spekulation übrig ist.
-
Verifikation dominiert die Laufzeit (42-95 %). Der Vorwärtsdurchlauf des Zielmodells ist die Engstelle. Die Reduzierung von verschwendeter Verifikation bei abgelehnten Token ist der vielversprechendste Ansatz für Verbesserungen.
-
Keine einzelne Methode gewinnt überall. EAGLE-3 ist die beste Allround-Wahl. Draft-Modell-Methoden glänzen, wenn das Zielmodell groß ist (70B+). N-Gramm ist optimal für Code-Bearbeitung und Aufgaben mit hoher Überlappung.
-
Oracle-Analyse offenbart eine Lücke. Die theoretische Obergrenze für kombinierte N-Gramm- und EAGLE-Strategien erreicht ~4,9x bei Code-Bearbeitungs-Workloads, aber aktuelle Implementierungen erreichen 2–3x. Es gibt Raum für Optimierung.
Praktische Beschleunigungserwartungen
| Szenario | Erwartete Beschleunigung |
|---|---|
| 70B-Modell, einzelne Anfrage, EAGLE-3 | 1,5-2,0x |
| 70B-Modell, Batch 32, EAGLE-3 | 1,2-1,5x |
| 8B-Modell, einzelne Anfrage, Draft-Modell | 1,3-1,8x |
| Code-Bearbeitung, n-gram | 2,0-4,0x (workload-abhängig) |
| Kreatives Schreiben, jede Methode | 1,0-1,3x (oft nicht lohnenswert) |
| MTP auf Qwen 3.6 27B, 16GB GPU | 1,5-1,7x |
| P-EAGLE auf B200, einzelne Anfrage | 2,0-3,0x |
Der Batch-Größen-Effekt ist kritisch. Bei kleinen Batches hat die GPU Leerlauf-Rechenleistung, die für Spekulation übrig ist. Bei großen Batches ist das System bereits gesättigt, und spekulatives Dekodieren fügt Overhead hinzu, ohne proportionalen Nutzen.
Überwachung in Produktion
Sie sollten die Akzeptanzrate in der Produktion tracken. Eine sinkende Akzeptanzrate signalisiert, dass Ihr Draft-Modell vom Ziel divergiert – entweder, weil der Workload sich geändert hat, oder weil das Draft-Modell neu trainiert werden muss.
Wichtige Metriken zur Überwachung:
- Akzeptanzrate pro Anfrage (sollte um Ihre Baseline stabil sein)
- Token pro Sekunde mit und ohne spekulatives Dekodieren (die tatsächliche Beschleunigung)
- Verifikationszeit als Prozentsatz der Zykluszeit (sollte 42-95 % betragen)
- Forward-Pass-Zeit des Draft-Modells (sollte < 20 % der Zeit des Zielmodells sein)
Wenn Ihre Akzeptanzrate unter 40 % fällt, deaktivieren Sie das spekulatives Dekodieren für diese Anfrage. Der Overhead ist es nicht wert.
Praktische Einrichtung
Die Wahl des Engines ist genauso wichtig wie die Draft-Strategie – siehe Ollama vs vLLM vs LM Studio and other local runtimes für die Handhabung von Batching, API-Kompatibilität und Durchsatz jedes Runtimes, bevor Sie einen Weg des spekulativen Dekodierens wählen.
llama.cpp
Für die allgemeine Server-Einrichtung und das Laden von GGUF, beginnen Sie mit dem llama.cpp Quickstart; die folgenden Flags fügen spekulatives Dekodieren darüber hinaus hinzu.
llama.cpp unterstützt mehrere spekulatives Dekodier-Methoden über das --spec-type-Flag:
# Draft-Modell (unabhängig)
llama-server \
  --model target-model.gguf \
  --draft-model draft-model.gguf \
  --spec-draft-n-max 4 \
  --parallel 1  # Pflicht: --parallel 1 für spekulatives Dekodieren

# n-gram
llama-server \
  --model target-model.gguf \
  --spec-type ngram-simple \
  --spec-ngram-simple-size-n 12 \
  --spec-ngram-simple-size-m 48

# n-gram (Einstellung für Text-Workload)
llama-server \
  --model target-model.gguf \
  --spec-type ngram-simple \
  --spec-ngram-simple-size-n 8 \
  --spec-ngram-simple-size-m 32 \
  --spec-ngram-simple-min-hits 2

# MTP (Qwen 3.6)
llama-server \
  --model Qwen3.6-27B-MTP.gguf \
  --spec-type draft-mtp \
  --spec-draft-n-max 2

# Self-spekulativ (Coding-Workloads)
llama-server \
  --model target-model.gguf \
  --spec-type draft-self
Kritische Flags:
--parallel 1— Spekulatives Dekodieren in llama.cpp erfordert Single-Batch-Modus. Dies ist eine aktuelle Einschränkung.--spec-draft-n-max— Anzahl der Draft-Tokens pro Zyklus. Beginnen Sie mit 3-5; höhere Werte erhöhen den VRAM-Druck.--spec-ngram-simple-size-n— Länge des N-Gramm für die Nachschlage. Standard 12 funktioniert gut für Code; reduzieren Sie auf 8 für Text.
Häufige Fehlerquellen:
--parallel 1vergessen — der Server ignoriert das spekulatives Dekodieren stillschweigend.- Verwendung von Cross-Family-Draft-Modellen — Akzeptanzraten kollabieren, was jeden Geschwindigkeitsvorteil negiert.
--spec-draft-n-maxzu hoch setzen — jedes zusätzliche Draft-Token kostet VRAM für den Draft-Puffer. Abnehmende Erträge setzen etwa bei 5-8 ein.
vLLM
Das vLLM Quickstart deckt die Basiseinrichtung ab; die folgenden Flags aktivieren spekulatives Dekodieren auf einem bestehenden vLLM-Server.
vLLM unterstützt spekulatives Dekodieren über die Flags --speculative-model und --speculative-num-steps:
# Draft-Modell
vllm serve target-model \
  --speculative-model draft-model \
  --speculative-num-steps 5 \
  --speculative-accept-length 5

# EAGLE-3
vllm serve target-model \
  --speculative-model EAGLE-target-model/ \
  --speculative-num-steps 7 \
  --speculative-draft-tensor-parallel-size 1

# P-EAGLE (paralleles Drafting)
vllm serve target-model \
  --speculative-model P-EAGLE-target-model/ \
  --speculative-num-steps 7 \
  --speculative-parallel-drafting true

# n-gram
vllm serve target-model \
  --speculative-method ngram \
  --speculative-num-steps 5 \
  --ngram-context-size 12
Das spekulatives Dekodieren von vLLM ist mit Continuous Batching integriert und funktioniert daher unter gleichzeitigen Workloads. Der Scheduler handhabt mehrere Token-Slots innerhalb eines einzelnen Vorwärtsdurchlaufs, und der Speicher-Manager handhabt den KV-Cache für sowohl Draft- als auch Zielmodell.
SGLang
SGLang unterstützt spekulatives Dekodieren über sein --speculative-algorithm-Flag:
python -m sglang.launch_server \
  --model-path target-model \
  --speculative-algorithm ngram \
  --ngram-context-size 12 \
  --ngram-max-candidate-tokens 6
Die RadixAttention-Architektur von SGLang paart sich gut mit spekulativem Dekodieren, da die Prefix-Caching die Verifikationskosten reduziert – das Zielmodell verwiedert gecachte Aufmerksamkeit für geteilte Präfixe, was jeden Verifikationsdurchlauf günstiger macht als einen kalten Vorwärtsdurchlauf.
TensorRT-LLM
TensorRT-LLM bietet produktionsreifes spekulatives Dekodieren mit Triton Inference Server. Die Einrichtung ist aufwendiger, bietet aber die beste Leistung auf NVIDIA-Hardware:
- Bauen Sie die TensorRT-Engine für beide Ziel- und Draft-Modelle.
- Konfigurieren Sie das Modell-Repository mit
model.yaml, die das spekulatives Dekodieren-Setup angibt. - Starten Sie Triton mit der LLM API / PyTorch-Backend.
TensorRT-LLM unterstützt sowohl Draft-Modell- als auch EAGLE-3-Varianten. Für Code-Generierungs-Workloads hat TensorRT-LLM mit N-Gramm-spekulativem Dekodieren eine Latenzreduzierung von 2-3x in produktiven Deployments demonstriert.
Wann spekulatives Dekodieren zu verwenden ist
Verwenden Sie es, wenn
- Große Zielmodelle (7B+): Der Overhead des Draft-Mechanismus wird über die Rechenleistung des Zielmodells amortisiert. Spekulatives Dekodien glänzt, wenn das Zielmodell langsam ist – je größer das Ziel, desto wertvoller die Beschleunigung.
- Workloads mit niedriger Temperatur: Spekulatives Dekodieren funktioniert am besten bei Temperatur 0,0-0,7, wo die Verteilung des Zielmodells konzentriert ist und der Entwurf eine bessere Chance hat zu matchen.
- Interaktive Anwendungen: Latenzsensible Workloads (Chat, Code-Vervollständigung, Agent-Tool-Aufrufe) profitieren am meisten. Batch-Verarbeitung, bei der die GPU bereits gesättigt ist, sieht weniger Nutzen.
- Code-Generierung und -Bearbeitung: Hohe Wiederholung in Code-Mustern macht N-Gramm- und Self-Spekulatives-Dekodieren besonders effektiv.
Übergehen Sie es, wenn
- Kleine Zielmodelle (< 3B): Der Overhead des Draft-Modells nähert sich der Zeit des Vorwärtsdurchlaufs des Zielmodells. Die Beschleunigung ist marginal oder negativ.
- Sampling mit hoher Temperatur: Bei Temperatur > 0,7 ist die Verteilung des Zielmodells zu breit, damit der Entwurf zuverlässig matchen kann.
- Kreatives Schreiben und offene Generierung: Niedrige Akzeptanzraten bei neuartigem Inhalt machen den Overhead nicht lohnenswert.
- Hohe Batch-Größen (> 32): Das System wird rechengebunden, und spekulatives Dekodieren fügt Overhead hinzu, ohne proportionalen Nutzen. SpecDecode-Bench zeigt, dass die Beschleunigung von 1,96x auf 1,21x fällt, wenn die Batch-Größe von 1 auf 128 steigt.
Methoden kombinieren
Fortgeschrittene Setups kombinieren mehrere spekulatives Dekodier-Strategien. Die Oracle-Analyse von SpecDecode-Bench zeigte, dass die adaptive Kombination von N-Gramm und EAGLE die Beschleunigung bei Code-Bearbeitungs-Workloads auf 4,9x treiben kann.
Die Idee ist, N-Gramm für Muster zu verwenden, die vorher aufgetreten sind, wo die Akzeptanz hoch und der Overhead nahe null ist, und auf EAGLE für neuartige Token zurückzufallen. In der Praxis erfordert dies Engine-Unterstützung für Multi-Methoden-Spekulation – vLLM und TensorRT-LLM haben experimentelle Unterstützung, aber produktionsreife Implementierungen sind noch im Reifeprozess.
Für jetzt ist die praktischste Kombination MTP + N-Gramm in llama.cpp. MTP handhabt die neuronale Spekulation, während N-Gramm repetitive Muster einfängt, die MTP verfehlt. Auf Qwen 3 27B erreicht diese Kombination 120 Token/Sekunde im Vergleich zu 67 Token/Sekunde Standard – eine 1,8-fache Beschleunigung.
Kostenbetrachtungen
Spekulatives Dekodieren tauscht Rechenleistung gegen Latenz. Die gesamte Rechenleistung pro Token ist etwa gleich – Sie führen einfach mehr Arbeit parallel statt sequenziell aus.
Auswirkung auf GPU-Kosten:
- Die Latenz für einzelne Anfragen verbessert sich um 20-50 %, was für interaktive Anwendungen wichtig ist.
- Der Durchsatz (Token/Sekunde über viele Anfragen) verbessert sich weniger – die GPU ist bei hohen Batch-Größen bereits gesättigt.
- Der VRAM-Verbrauch steigt um den Fußabdruck des Draft-Modells (1-4 GB für unabhängige Entwürfe, minimal für N-Gramm/EAGLE).
Cloud-Inferenz: Bei $2-4/Stunde pro H100 reduziert spekulatives Dekodieren die Latenz pro Anfrage, ohne die Kosten pro Token zu erhöhen. Für Batch-Verarbeitung, bei der die GPU bereits gesättigt ist, ist der Kosten-Nutzen minimal – Sie zahlen ohnehin für die gleiche GPU-Zeit.
Wann spekulatives Dekodien Geld spart: Interaktive Anwendungen, bei denen Sie pro Anfrage abrechnen und die Zeit bis zum ersten Token reduzieren wollen. Eine 2-fache Beschleunigung bedeutet, dass Ihre Benutzer die Hälfte so lange warten, und Sie können mehr Anfragen pro Sekunde auf derselben Hardware bedienen.
Wann es nicht spart: Batch-Verarbeitung, bei der Sie die GPU-Auslastung bereits maximieren. Die zusätzliche Rechenleistung des spekulativen Dekodierens erhöht nicht den Durchsatz – sie ändert nur das Latenzprofil.
Was kommt als Nächstes
Spekulatives Dekodieren reift von einer Forschungsneuheit zu einem Produktionsstandard. Die Frontier schiebt sich über die aktuellen Einschränkungen hinaus:
-
Modell-Level parallele Generierung: Spekulatives Dekodieren schiebt mehrere Token pro Vorwärtsdurchlauf auf der Inferenz-Schicht, ohne die Ausgabeverteilung anzufassen. Diffusions-Sprachmodelle setzen auf einen strukturell anderen Ansatz, indem sie mehrere Token pro Vorwärtsdurchlauf als Teil der Modellarchitektur selbst erzeugen. Siehe was nach LLMs kommt für einen Vergleich mit dem oben genannten Draft-Verify-Ansatz sowie mit State Space Modellen und JEPA-Weltmodellen am anderen Ende der Post-Transformer-Landschaft.
-
Spekulatives Spekulatives Dekodieren (SSD): Parallelisiert die Drafting- und Verifikationsstufen über separate Hardware. Das Draft-Modell läuft asynchron und spekuliert vorab für mehrere wahrscheinliche Verifikationsergebnisse. Frühe Ergebnisse zeigen bis zu 2-fache Beschleunigung gegenüber optimiertem spekulativem Dekodieren und 5-fache gegenüber autoregressivem Dekodieren. Noch nicht produktionsreif, aber die Richtung ist klar.
-
SpecSA (Sparse Speculative Verification): Kombiniert spekulatives Dekodieren mit dynamischer sparsamer Aufmerksamkeit. Verwandelt sparsame Aufmerksamkeit in einen verifikationsorientierten Workload und erreicht bis zu 3,49-fachen End-to-End-Durchsatz gegenüber autoregressiver sparsamer Dekodierung. Relevant für Long-Context-Modelle, bei denen sparsame Aufmerksamkeit bereits im Einsatz ist.
-
Adaptive Spekulation: Automatisches Umschalten zwischen N-Gramm, EAGLE und Draft-Modell-Methoden basierend auf Workload-Eigenschaften. Die Oracle-Analyse zeigt erhebliches ungenutztes Potenzial – aktuelle Implementierungen erreichen 2-3x, aber die theoretische Grenze liegt bei 4,9x.
-
Multimodales spekulatives Dekodieren: Erweiterung von Draft-Verify auf Vision-Language-Modelle und Videogenerierung. Frühe Umfragen zeigen, dass dieselben Prinzipien gelten, aber Verifikationsstrategien für nicht-textuelle Modalitäten angepasst werden müssen.
Entscheidungsrahmen
| Frage | Antwort | Empfehlung |
|---|---|---|
| Zielmodell-Größe? | < 3B | Spekulatives Dekodieren überspringen |
| Zielmodell-Größe? | 7-13B | N-Gramm oder self-spekulativ verwenden (niedriger Overhead) |
| Zielmodell-Größe? | 30B+ | Draft-Modell oder EAGLE-3 verwenden (größeres Ziel = mehr Nutzen) |
| Workload-Typ? | Code-Bearbeitung/Refactoring | N-Gramm + EAGLE Kombination |
| Workload-Typ? | Allgemeiner Chat | EAGLE-3 oder P-EAGLE |
| Workload-Typ? | Kreatives Schreiben | Spekulatives Dekodieren überspringen |
| Batch-Größe? | 1-4 (interaktiv) | Spekulatives Dekodieren hilft am meisten |
| Batch-Größe? | 32+ (Durchsatz) | Spekulatives Dekodieren hilft weniger |
| Temperatur? | 0.0-0.7 | Gut für spekulatives Dekodieren |
| Temperatur? | > 0.7 | Spekulatives Dekodieren überspringen |
| Hardware? | 16GB GPU | N-Gramm oder MTP verwenden (niedriger VRAM-Overhead) |
| Hardware? | 24GB+ GPU | Draft-Modell oder EAGLE-3 machbar |
| Engine? | vLLM | EAGLE-3 oder P-EAGLE (beste Integration) |
| Engine? | llama.cpp | N-Gramm oder MTP (einfachste Einrichtung) |
| Engine? | TensorRT-LLM | EAGLE-3 oder Draft-Modell (Produktionsreife) |
