슈퍼파워스 퀵스타트: 설치, 워크플로우, 및 시연
10개의 명령으로 강제되는 SDD 스킬
Superpowers는 뇌暴(brainstorming), 계획 수립, 서브에이전트 기반 구현, 엄격한 TDD(Test-Driven Development)를 강제하는 스펙 기반 개발 방법론 전체를 설치 가능한 Claude 스킬 패키지로 묶어 제공합니다.
10개의 명령으로 강제되는 SDD 스킬
Superpowers는 뇌暴(brainstorming), 계획 수립, 서브에이전트 기반 구현, 엄격한 TDD(Test-Driven Development)를 강제하는 스펙 기반 개발 방법론 전체를 설치 가능한 Claude 스킬 패키지로 묶어 제공합니다.
사용자가 직접 형태를 만들어야 하는 작은 코딩 에이전트
Pi Coding Agent는 기본 도구 4개를 갖추고 있으며, 대부분의 동작을 확장, 스킬 및 사용자 자체 워크플로에 맡기는 최소한의 오픈소스 터미널 코딩 하네스입니다.
AI 스택이 매월 더욱 강하게 고정되는 이유
모든 API 호출은 단순한 거래처럼 느껴집니다. 하지만 그 수가 쌓이면, 파인튜닝 데이터, 평가 하네스, 도구 스키마가 모두 하나의 벤더 주위에 형성되어, 벤더 전환이 더 이상 단순한 라우팅 변경이 아닌 상황이 됩니다.
소음이 발생하는 작업은 위임하고, 컨텍스트는 깨끗하게 유지하세요.
대부분의 Claude Code 세션이 느려지고 지저분해지는 이유는 동일합니다. 탐색적인 grep 실행, 로그 덤프, 그리고 “하나 더 확인해 보자"는 식의 파일 확인 작업들이 모두 메인 대화 창에 영구적으로 남기 때문입니다.
Ollama에서 vLLM으로 전환해야 하는 시점
Ollama는 로컬 언어 모델을 실행하는 가장 간편한 방법 중 하나이지만, 편리함은 로컬 실험이 더 나은 스케줄링과 관측 가능성이 필요한 공유 추론 서비스로 전환되는 순간을 가릴 수 있습니다.
컴파일된 지식의 신뢰성을 유지하세요
LLM 위키(Wiki)는 오래된 사실이 여전히 그럴듯해 보일 때, 모순이 정교하게 다듬어질 때, 그리고 생성된 요약이 원천 자료에서 벗어나면 실패합니다.
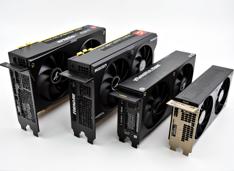
3개 벤더 간 AI GPU 비교
2026년 AI 하드웨어 시장은 크게 변화했습니다. NVIDIA, AMD, 인텔은 모두 로컬 대규모 언어 모델(LLM)과 AI 추론 워크로드를 처리할 수 있는 GPU를 필요로 하는 개발자들을 두고 치열한 경쟁을 벌이고 있습니다.
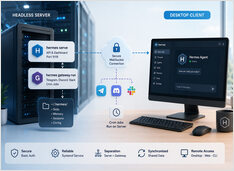
원격 데스크톱 액세스를 지원하는 Headless Hermes 서버
데스크톱 클라이언트에서 다른 머신의 헤드리스 서버에 Hermes 에이전트를 실행하고 연결하려면 두 개의 서버 프로세스와 하나의 클라이언트 연결이 필요합니다.
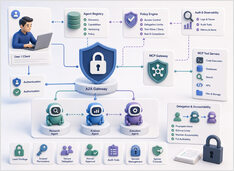
프로토콜 보안은 모델이 아닌 행위 주체를 규정합니다.
프롬프트 인젝션은 LLM 시스템에서 가장 많은 보안 관심을 받고 있으며, 주목받을 만하지만 에이전트가 도구를 호출하고 작업을 다른 에이전트에 위임하기 시작하면 이것이 유일한 문제는 아닙니다.
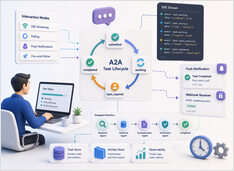
장기간 실행되는 A2A 작업은 채팅 세션보다 더 오래 지속됩니다.
대부분의 AI 에이전트 데모는 여전히 몇 가지 추가 단계를 거친 채팅 완성(chat completion)과 비슷하게 작동합니다. 프롬프트를 보내고 몇 초를 기다린 후, 하나의 응답으로 답변을 받습니다.
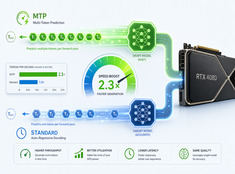
품질 저하 없이 더 빠른 LLM 추론 – 실용 가이드
70B 모델은 포워드 패스당 1개의 토큰을 생성하며, 각 패스에서는 VRAM에서 가중치를 다시 로드하고, 컨텍스트에 대한 어텐션을 계산하며, 메모리를 동기화합니다. 토큰 사이에는 GPU가 순차적인 의존성이 해결되기를 기다리며 유휴 상태(idle)에 있게 됩니다.
A2A는 사라진 것이 아닙니다. 다만 범용적으로 쓰이지 않을 뿐입니다.
구글의 에이전트 투 에이전트(Agent2Agent) 프로토콜, 즉 A2A는 첫해를 다소 혼란스럽게 보냈습니다.
AI 에이전트를 위한 신뢰할 수 있는 폴링 패턴
폴링 에이전트(Polling Agent)는 AI 어시스턴트 아키텍처에서 가장 화려하지는 않지만, 동시에 가장 유용한 구성 요소 중 하나입니다.
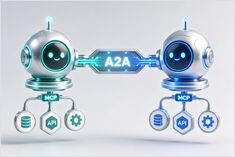
MCP는 에이전트에 도구를 제공하며, A2A는 에이전트에게 동료(피어)를 제공합니다.
AI 에이전트 아키텍처는 이제 두 가지 레이어로 분화되기 시작하고 있습니다.
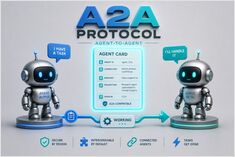
A2A는 에이전트를 네트워크 피어(network peers)로 전환합니다.
A2A 프로토콜(에이전트 투 에이전트 프로토콜)은 독립적인 AI 에이전트 시스템 간의 통신을 위한 개방형 표준입니다.