
의사 결정 LLM: 모델이 결정해야 할 때와 결정하지 않아야 할 때
모델은 제안하고, 시스템은 결정합니다.
에이전트 시스템 실무자에게 무엇이 깨지는지 물으면, 답은 드물게도 능력(capability)이 아닙니다. 실패는 더 조용하게 찾아옵니다: 모델은 판단하지만, 아무도 올바른 판단과 유창한 답변을 구별할 수 없는 것입니다.
모델은 제안하고, 시스템은 결정합니다.
에이전트 시스템 실무자에게 무엇이 깨지는지 물으면, 답은 드물게도 능력(capability)이 아닙니다. 실패는 더 조용하게 찾아옵니다: 모델은 판단하지만, 아무도 올바른 판단과 유창한 답변을 구별할 수 없는 것입니다.
자체 하드웨어에서 지속되는 Hermes 메모리.
자체 호스팅 AI 에이전트는 긴 컨텍스트 윈도우만으로는 충분하지 않습니다. 유용한 사실을 보존하고, 이전 결정을 검색하며, 프로젝트가 발전함에 따라 자신이 알고 있다고 생각하는 것을 재수정할 수 있는 방식이 필요합니다.
검색을 넘어 연구를 수행하는 셀프호스트 에이전트
Deep Research는 이제 단순히 검색 박스에 적용되는 모델이 아니라, 독자적인 소프트웨어 카테고리가 되었습니다. 이 글에서는 12가지 셀프호스팅 시스템과 그 뒤를支撑하는 리서치 아키텍처를 비교합니다.
기억 속에 남은 결론이 새로운 증거가 될 때
지속적 메모리는 에이전트를 매번 설명을 반복해야 하는 도구에서, 맥락을 앞으로 나르게 하는 존재로 바꿔놓습니다. 하지만 동시에 스테이트리스(stateless) 채팅에서는 피할 수 있는 실패 모드를 열어놓습니다. 하나의 해석이 메모리로 저장된 뒤 사실처럼 검색되고, 더 강한 버전을 정당화하는 근거가 될 수 있기 때문입니다.
제어된 작성(local write)이 가능한 로컬 Hermes 메모리
Mnemosyne은 Hermes Agent를 위한 로컬 우선(local-first) 기억(memory) 제공자(provider)로, 작업 기억(working memory), 구조화된 사실(structured facts), 시계열 데이터(temporal data), 그리고 에피소드적 히스토리(episodic history)를 로컬 SQLite에 저장합니다. 호스팅된 서비스도, 필수적인 네트워크 호출도 없으며, 비정상적으로 세밀한(write) 제어 권한을 제공합니다.
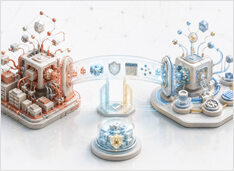
한 줄 import를 넘어선 안전한 전환
AI 어시스턴트 마이그레이션은 단순한 애플리케이션 설정 복사와는 다른 문제입니다. 가장 어려운 부분은 두 개의 게이트웨이가 동일한 봇으로 작동하지 않도록 하면서도, 정체성, 기억, 도구 동작, 예약된 작업, 그리고 메시지 접근 권한을 보존하는 것입니다.
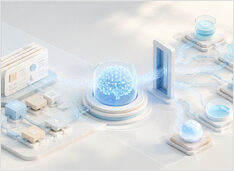
스킬, MCP 서버, 아니면 둘 다?
에이전트 스킬과 MCP 서버는 종종 AI 에이전트를 확장하는 경쟁적인 방식들로 제시됩니다. 그러나 이 프레임은 틀렸습니다: 스킬은 에이전트가 어떻게 작업해야 하는지를 가르치고, MCP 서버는 라이브 기능에 대한 거버넌스된 접근을 제공합니다.
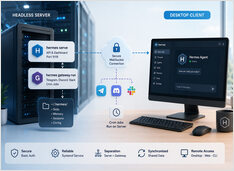
원격 데스크톱 액세스를 지원하는 Headless Hermes 서버
데스크톱 클라이언트에서 다른 머신의 헤드리스 서버에 Hermes 에이전트를 실행하고 연결하려면 두 개의 서버 프로세스와 하나의 클라이언트 연결이 필요합니다.
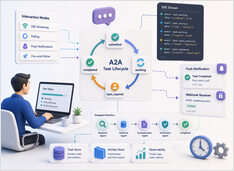
장기간 실행되는 A2A 작업은 채팅 세션보다 더 오래 지속됩니다.
대부분의 AI 에이전트 데모는 여전히 몇 가지 추가 단계를 거친 채팅 완성(chat completion)과 비슷하게 작동합니다. 프롬프트를 보내고 몇 초를 기다린 후, 하나의 응답으로 답변을 받습니다.
멀티 에이전트 파일럿의 40%가 실패합니다. 올바른 오케스트레이션 패턴을 선택하고, 실패로 이어지는 패턴을 피하는 방법에 대해 설명합니다.
2025년, 단일 에이전트 AI 시스템은 정점에 달했습니다 — LLM 하나에 프롬프트, 도구, 목표를 주면 제한된 범위 내의 작업에서 꽤 괜찮은 성과를 내ことができました.
A2A는 사라진 것이 아닙니다. 다만 범용적으로 쓰이지 않을 뿐입니다.
구글의 에이전트 투 에이전트(Agent2Agent) 프로토콜, 즉 A2A는 첫해를 다소 혼란스럽게 보냈습니다.
AI 에이전트를 위한 신뢰할 수 있는 폴링 패턴
폴링 에이전트(Polling Agent)는 AI 어시스턴트 아키텍처에서 가장 화려하지는 않지만, 동시에 가장 유용한 구성 요소 중 하나입니다.
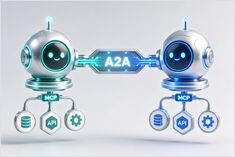
MCP는 에이전트에 도구를 제공하며, A2A는 에이전트에게 동료(피어)를 제공합니다.
AI 에이전트 아키텍처는 이제 두 가지 레이어로 분화되기 시작하고 있습니다.
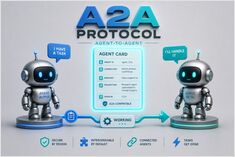
A2A는 에이전트를 네트워크 피어(network peers)로 전환합니다.
A2A 프로토콜(에이전트 투 에이전트 프로토콜)은 독립적인 AI 에이전트 시스템 간의 통신을 위한 개방형 표준입니다.
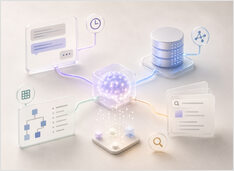
어시스턴트를 위한 작업 기억, 구조화 기억, 검색 기억
메모리는 어시스턴트를 반응형에서 지속형으로 바꾸지만, 동시에 많은 시스템이 조용히 부패하는 곳이기도 합니다. 최신 에이전트 메모리에 대해 단기 기억과 장기 기억의 이분법은 더 이상 충분하지 않다고 주장하는 조사가 있으며, OpenAI와 LangGraph SDK는 더 단순한 스택을 지시합니다 — 워킹 메모리(작업 메모리), 내구성 상태(durable state), 검색(retrieval).
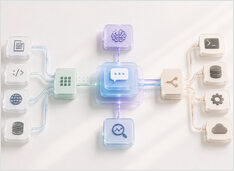
실제 생산성 어시스턴트는 어떻게 구축되는가.
프로덕션 AI 어시스턴트는 단순히 “프롬프트가 포함된 LLM"이 아닙니다. 사용자 의도를 수용하고, 상태를 유지하며, 검색 또는 실행 시점을 결정하고, 장애를 디버깅할 수 있도록 충분한 런타임 세부 정보를 노출하는 시스템입니다.