
플러그인 및 스킬을 활용한 OpenClaw 프로덕션 설정 패턴
실제 OpenClaw 시스템이 어떻게 구성되어 있는지
데모에서는 OpenClaw가 단순해 보입니다. 하지만 프로덕션 환경에서는 하나의 시스템으로 진화합니다.
실제 OpenClaw 시스템이 어떻게 구성되어 있는지
데모에서는 OpenClaw가 단순해 보입니다. 하지만 프로덕션 환경에서는 하나의 시스템으로 진화합니다.
클로드 구독은 더 이상 에이전트를 구동하지 않습니다
에이전트 실험의 물결을 이끈 조용한 루트가 이제 막혔습니다.
로컬 LLM을 활용한 자체 호스팅 AI 검색
Vane은 “인용과 함께 하는 AI 검색” 분야에서 가장 실용적인 선택지 중 하나입니다. 이는 라이브 웹 검색과 로컬 또는 클라우드 LLM을 결합하는 자체 호스팅형 답변 엔진으로, 전체 스택을 사용자의 통제 아래에 두는 것이 특징입니다.
로컬 모델 백엔드를 갖춘 에이전틱 코딩
Claude Code는 마케팅만 뛰어난 자동 완성 도구가 아닙니다. 이것은 에이전트 기반 코딩 도구입니다. 코드베이스를 읽고, 파일을 편집하며, 명령을 실행하고, 개발 도구와 통합됩니다.
개발자를 위한 Hermes Agent 설치 및 빠른 시작
Hermes Agent는 로컬 머신 또는 저가형 VPS에서 실행되는 셀프 호스팅, 모델 독립형 AI 어시스턴트입니다. 터미널 및 메신저 인터페이스를 통해 작동하며, 반복적인 작업을 재사용 가능한 스킬로 변환함으로써 시간이 지남에 따라 성능을 향상시킵니다.
TGI 를 설치하고 빠르게 배포하며 더 빠르게 디버깅하세요.
Text Generation Inference(TGI) 는 매우 특유의 에너지를 지니고 있습니다. 추론 분야에서 가장 새로운 기술은 아니지만, 이미 프로덕션 환경에서 발생하는 문제를 잘 이해하고 있습니다.
16GB VRAM에서 llama.cpp의 토큰 처리 속도(테이블)
여기서는 16GB VRAM을 갖춘 GPU에서 구동되는 여러 LLM의 속도를 비교하고, 자가 호스팅에 가장 적합한 모델을 선택하는 과정을 다루고 있습니다.
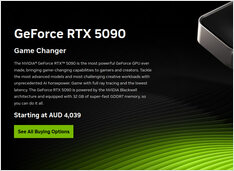
호주에서는 RTX 5090 가 품귀 현상을 보이고 가격이 비쌉니다.
호주에 RTX 5090 재고가 있습니다. 마침내. 하지만 하나를 찾아도 현실과 동떨어진 프리미엄 가격을 지불해야 합니다.
공용 포트를 사용하지 않는 원격 Ollama 접근
Ollama 는 로컬 데몬 (daemon) 으로 취급될 때 가장 행복해합니다: CLI 와 애플리케이션이 루프백 HTTP API 와 통신하며, 나머지 네트워크는 Ollama 의 존재를 전혀 알지 못합니다.
GPU 및 영구 저장 기능을 갖춘 Compose 우선 Ollama 서버
Ollama는 베어 메탈(bare metal) 환경에서도 훌륭하게 작동합니다. 서비스처럼 다룰 때 더 재미가 생깁니다: 안정적인 엔드포인트, 고정된 버전, 영속적 저장소, 그리고 사용 가능하거나 불가능한 GPU.
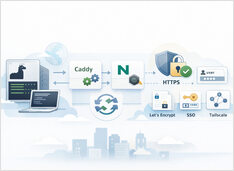
스트리밍 응답을 깨뜨리지 않고 HTTPS를 사용한 Ollama
리버스 프록시 뒤에 Ollama 를 실행하는 것은 HTTPS, 선택적 접근 제어, 예측 가능한 스트리밍 동작을 얻는 가장 간단한 방법입니다.
RAG 임베딩 - Python, Ollama, OpenAI API.
검색 증강 생성 (RAG)을 공부 중이시라면, 이 섹션에서는 텍스트 임베딩이 무엇인지, 검색 및 검색 (retrieval) 과 어떻게 연관되는지, 그리고 Ollama 또는 OpenAI 호환 HTTP API(많은 llama.cpp 기반 서버에서 제공하는 방식) 를 사용하여 Python에서 두 가지 일반적인 로컬 설정을 호출하는 방법을 쉽게 설명합니다.
SGLang 로 오픈 모델을 빠르게 제공하세요.
SGLang 은 단일 GPU 에서 분산 클러스터에 이르기까지 저지연 및 고휘도 추론을 제공하도록 설계된 대규모 언어 모델 및 멀티모달 모델용 고성능 서비스 프레임워크입니다.
클라이언트 변경 없이 로컬 LLM을 핫스왑하세요.
가까운 미래에는 vLLM, llama.cpp 등 다양한 스택을 여러 포트에서 동시에 관리하게 될 것입니다. 하지만 다운스트림의 모든 시스템은 여전히 단일 /v1 기반 URL을 요구합니다. 그렇지 않으면 포트, 프로필, 일회용 스크립트를 계속 치환하는 수고스러운 일이 반복됩니다. llama-swap은 이러한 스택 앞단에 배치되는 /v1 프록시입니다.
대부분의 로컬 AI 설정은 모델과 런타임으로 시작합니다.
Ultrawork 를 실행할 때 실제로 어떤 일이 일어나는지 알아봅니다.
Oh My Opencode 는 “가상의 AI 개발 팀"을 약속합니다. Sisyphus 가 전문가들을 지휘하고, 작업이 병렬로 실행되며, 마법 같은 ultrawork 키워드가 모든 것을 활성화합니다.