
2026년 LLM 성능: 벤치마크, 병목 현상 및 최적화
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.
자체 호스팅 LLM으로 데이터와 모델을 제어하세요
자체 호스팅 LLM은 데이터, 모델 및 추론을 당신의 통제 하에 유지하며, 팀, 기업, 국가를 위한 **AI 주권**으로 가는 실용적인 경로를 제시합니다.
RTX 4080 (16GB VRAM)에서 LLM 속도 테스트
로컬에서 대규모 언어 모델(Large Language Models, LLM)을 실행하면 개인 정보 보호, 오프라인 사용성, 그리고 제로 API 비용을 얻을 수 있습니다. 이 벤치마크는 RTX 4080에서 Ollama를 통해 실행된 14가지 인기 LLM의 성능을 RTX 4080으로 측정하기에서 무엇을 기대할 수 있는지를 정확히 보여줍니다.
2026년 10월 트렌딩 Go 저장소
Go 생태계는 지속적으로 번성하고 있으며, 이번 달 트렌딩 목록은 AI 에이전트 인프라 중심으로 구성되어 있습니다. 이 개요는 이번 달 GitHub의 주요 트렌딩 Go 저장소들을 분석합니다.
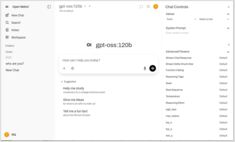
로컬 LLM용 셀프호스트드 ChatGPT 대안
Open WebUI는 대형 언어 모델(LLM)과 상호작용하기 위한 강력하고 확장 가능하며 기능적인 셀프 호스팅 웹 인터페이스입니다.
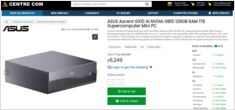
지금 호주 현지 소매업체의 실제 AUD 가격
NVIDIA DGX Spark (GB10 Grace Blackwell) 은 이제 주요 PC 판매점에서 재고 상태로 호주에서도 구매 가능 합니다. 전 세계 DGX Spark 가격과 가용성 을 지켜보셨다면, 호주의 가격은 저장 구성과 판매처에 따라 6,249 호주 달러에서 7,999 호주 달러 사이임을 알게 되시면 흥미로워하실 것입니다.
로컬 LLM로 Cognee 테스트 - 실제 결과
Cognee는 문서에서 지식 그래프를 구축하기 위한 Python 프레임워크입니다. 하지만 이 프레임워크는 자가 호스팅된 모델과 호환됩니까?
BAML과 Instructor를 활용한 타입 안전한 LLM 출력
프로덕션 환경에서 대규모 언어 모델(LLM)을 사용할 때 구조화되고 타입 안전(structured, type-safe)한 출력을 얻는 것은 매우 중요합니다. 두 가지 인기 있는 프레임워크인 BAML과 Instructor는 이 문제를 해결하는 서로 다른 접근 방식을 취합니다.
자체 호스팅된 Cognee를 위한 LLM에 대한 고찰
Best LLM for Cognee을 선택할 때는 그래프 생성 품질, 환상 발생 비율, 하드웨어 제약 조건 사이에서 균형을 유지해야 합니다.
Cognee는 Ollama를 통해 32B 이상의 저환상 모델을 사용하여 우수한 성능을 보입니다. 그러나 중간 규모의 모델도 가벼운 설정에 적합합니다.
Python과 Ollama를 활용한 AI 검색 에이전트 구축
Ollama의 Python 라이브러리에 이제 네이티브 Ollama 웹 검색 기능이 추가되었습니다. 몇 줄의 코드만으로 웹의 실시간 정보를 활용하여 로컬 LLM을 강화할 수 있으며, 이는 환각(hallucination)을 줄이고 정확도를 높이는 데 도움이 됩니다.
Go와 Ollama로 AI 검색 에이전트 만들기
Ollama의 웹 검색 API는 실시간 웹 정보를 활용하여 로컬 LLM을 보완할 수 있습니다. 이 가이드에서는 단순한 API 호출부터 전체 기능을 갖춘 검색 에이전트까지, Go에서 웹 검색 기능을 구현하는 방법을 보여드립니다.
2026년 최고의 로컬 LLM 호스팅 도구 비교. API 성숙도, 하드웨어 지원, 도구 호출 및 실전 사용 사례.
로컬에서 LLM을 실행하는 것은 이제 개발자, 스타트업, 심지어 엔터프라이즈 팀들에게도 현실적인 선택지가 되었습니다. 그러나 올바른 도구, 즉 Ollama, vLLM, LM Studio, LocalAI 또는 기타 도구를 선택하는 것은 목표에 달려 있습니다:
오픈 모델로 저비용 하드웨어에서 엔터프라이즈 AI 배포
AI 의 민주화는 이제 현실이 되었습니다. Llama, Mistral, Qwen 과 같은 오픈소스 LLM 이 독점 모델들과 경쟁할 수준에 도달함에 따라, 팀들은 소비자용 하드웨어를 활용한 AI 인프라 구축 을 통해 비용을 절감하면서도 데이터 프라이버시와 배포에 대한 완전한 통제를 유지할 수 있게 되었습니다.
GPT-OSS 120b의 세 AI 플랫폼에서의 벤치마크
저는 Ollama에서 실행되는 GPT-OSS 120b의 성능 테스트 결과를 NVIDIA DGX Spark, Mac Studio, RTX 4080 세 가지 플랫폼에서 확인해보았습니다. Ollama 라이브러리에서 제공하는 GPT-OSS 120b 모델의 크기는 65GB로, RTX 4080의 16GB VRAM에 맞지 않으며, 더 최근의 RTX 5080에도 맞지 않습니다.
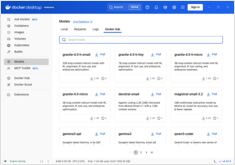
로컬 LLM용 Docker Model Runner와 Ollama 비교
로컬에서 대규모 언어 모델(LLM) 실행 는 프라이버시, 비용 관리 및 오프라인 기능을 위해 점점 더 인기를 끌고 있습니다. 2025년 4월에 Docker가 Docker Model Runner (DMR), AI 모델 배포를 위한 공식 솔루션을 도입하면서 상황은 크게 변화했습니다.