
오픈코드(OpeCode) 퀵스타트: 설치, 설정 및 실행 가이드
Oh My Opencode 를 설치하고 더 빠르게 배포하세요.
Oh My Opencode 는 OpenCode 를 **멀리 에이전트 코딩 하네스 (multi-agent coding harness)**로 변신시킵니다. 오케스트레이터가 작업을 병렬로 실행하는 전문 에이전트에게 위임합니다.
Oh My Opencode 를 설치하고 더 빠르게 배포하세요.
Oh My Opencode 는 OpenCode 를 **멀리 에이전트 코딩 하네스 (multi-agent coding harness)**로 변신시킵니다. 오케스트레이터가 작업을 병렬로 실행하는 전문 에이전트에게 위임합니다.
OpenCode LLM 테스트 — 코딩 및 정확도 통계
로컬 호스팅된 Ollama 및 llama.cpp 기반 LLM들과 OpenCode가 어떻게 작동하는지 테스트해 보았습니다. 비교를 위해 OpenCode Zen의 일부 무료 모델도 추가했습니다.
시시포스와 그 전문 에이전트 팀을 소개합니다.
OpenCode 의 가장 큰 능력 향상은 전담 에이전트 (specialised agents) 에서 비롯됩니다: 오케스트레이션, 계획, 실행, 연구의 의도적인 분리입니다.
CLI 설치, 플래그, 헤드리스, 로컬 모델
OpenHands는 샌드박스 내에서 파일을 편집하고 명령을 실행하는 오픈소스 코딩 에이전트입니다. 이 CLI 퀵스타트는 2026년 10월 26일에 패키지 1.16.0 버전으로 검증되었습니다.
분산형 로컬 AI 를 통해 OpenAI 호환 API 를 LocalAI 로 몇 분 안에 자체 호스팅하세요.
LocalAI 는 자신의 하드웨어 (노트북, 워크스테이션, 온프레미스 서버) 에서 AI 워크로드를 실행하기 위해 설계된 자체 호스팅, 로컬 우선 추론 서버로, OpenAI API 와의 호환성을 제공하여 기존 도구를 그대로 사용할 수 있도록 합니다.
프로미스스(Prometheus) 와 그라파나(Grafana) 를 활용한 LLM 모니터링
LLM 추론은 “단순한 또 하나의 API"처럼 보이지만, 지연 시간이 급증하고 대기열이 쌓이며 GPU 메모리가 95% 사용되는데도 명확한 원인을 파악할 수 없게 되면 상황이 달라집니다.
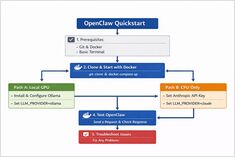
로컬에 Ollama를 사용하여 OpenClaw 설치
OpenClaw는 Ollama와 같은 로컬 LLM 런타임이나 Claude Sonnet과 같은 클라우드 기반 모델과 함께 실행하도록 설계된 셀프 호스팅(Self-hosted) AI 어시스턴트입니다.
AWS S3, Garage, MinIO - 개요 및 비교
AWS S3는 여전히 오브젝트 스토리지의 “기본” 기준선으로 자리 잡고 있습니다. 이 서비스는 완전 관리형이며, 강력한 일관성을 제공하며, 극도로 높은 내구성 및 가용성을 위해 설계되었습니다. Garage와 MinIO는 자가 호스팅 방식의 S3 호환 대안입니다. Garage는 가볍고, 지리적으로 분산된 소규모~중규모 클러스터를 위해 설계된 반면, MinIO는 대규모 배포 환경에서의 광범위한 S3 API 기능 지원과 높은 성능을 강조합니다.
몇 분 안에 Docker에서 Garage 실행하기
Garage은 소규모에서 중간 규모 배포에 적합한 오픈소스, 자체 호스팅, S3 호환 오브젝트 스토리지 시스템으로, 강력한 내구성과 지리 분산에 중점을 두고 설계되었습니다.
자체 호스팅 LLM으로 데이터와 모델을 제어하세요
자체 호스팅 LLM은 데이터, 모델 및 추론을 당신의 통제 하에 유지하며, 팀, 기업, 국가를 위한 **AI 주권**으로 가는 실용적인 경로를 제시합니다.
RTX 4080 (16GB VRAM)에서 LLM 속도 테스트
로컬에서 대규모 언어 모델(Large Language Models, LLM)을 실행하면 개인 정보 보호, 오프라인 사용성, 그리고 제로 API 비용을 얻을 수 있습니다. 이 벤치마크는 RTX 4080에서 Ollama를 통해 실행된 14가지 인기 LLM의 성능을 RTX 4080으로 측정하기에서 무엇을 기대할 수 있는지를 정확히 보여줍니다.
2026년 10월 트렌딩 Go 저장소
Go 생태계는 지속적으로 번성하고 있으며, 이번 달 트렌딩 목록은 AI 에이전트 인프라 중심으로 구성되어 있습니다. 이 개요는 이번 달 GitHub의 주요 트렌딩 Go 저장소들을 분석합니다.
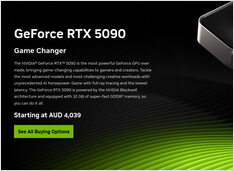
2025년 1월 GPU 및 RAM 가격 확인
오늘 우리는 최상위 소비자용 GPU와 RAM 모듈을 살펴보겠습니다.
구체적으로는
RTX-5080 및 RTX-5090 가격, 그리고 32GB (2x16GB) DDR5 6000을 살펴보겠습니다.
로컬 LLM용 셀프호스트드 ChatGPT 대안
Open WebUI는 대형 언어 모델(LLM)과 상호작용하기 위한 강력하고 확장 가능하며 기능적인 셀프 호스팅 웹 인터페이스입니다.
2026년 vLLM 설치, 서빙 및 튜닝
vLLM은 UC 버클리 스카이 컴퓨팅 랩(Sky Computing Lab)이 개발한 대규모 언어 모델(LLM)을 위한 고처리량, 메모리 효율적인 추론 및 서빙 엔진입니다.