
Docker 모델 러너에 NVIDIA GPU 지원 추가
NVIDIA CUDA 지원을 통해 Docker 모델 실행기에서 GPU 가속을 활성화하세요.
Docker Model Runner은 AI 모델을 로컬에서 실행하는 Docker의 공식 도구이지만,
Docker Model Runner에서 NVidia GPU 가속 기능 활성화
은 특정 설정이 필요합니다.
NVIDIA CUDA 지원을 통해 Docker 모델 실행기에서 GPU 가속을 활성화하세요.
Docker Model Runner은 AI 모델을 로컬에서 실행하는 Docker의 공식 도구이지만,
Docker Model Runner에서 NVidia GPU 가속 기능 활성화
은 특정 설정이 필요합니다.

헤드리스 CMS 비교 - 기능, 성능 및 사용 사례
올바른 헤드리스 CMS를 선택하는 것은 콘텐츠 관리 전략을 성공적으로 만들거나 망하게 만들 수 있습니다.
개발자가 콘텐츠 중심 애플리케이션을 구축하는 방식에 영향을 미치는 세 가지 오픈소스 솔루션을 비교해 보겠습니다.

자체 호스팅된 AI 기반 백업에 저장된 사진
Immich는 사진 및 영상 관리에 대한 완전한 제어권을 제공하는 혁신적인 오픈소스, 자체 호스팅 솔루션입니다. 구글 포토와 경쟁할 수 있는 기능을 갖추고 있으며, AI 기반 얼굴 인식, 스마트 검색, 자동 모바일 백업을 포함하여 데이터를 개인 서버에서 안전하게 보호합니다.
검색, 인덱싱 및 분석을 위한 Elasticsearch 명령어
Elasticsearch 은 Apache Lucene 를 기반으로 구축된 강력한 분산 검색 및 분석 엔진입니다. 이 종합적인 치트시트는 Elasticsearch 클러스터 작업을 위한 필수 명령어, 모범 사례 및 빠른 참고 자료를 다룹니다.
GPT-OSS 120b의 세 AI 플랫폼에서의 벤치마크
저는 Ollama에서 실행되는 GPT-OSS 120b의 성능 테스트 결과를 NVIDIA DGX Spark, Mac Studio, RTX 4080 세 가지 플랫폼에서 확인해보았습니다. Ollama 라이브러리에서 제공하는 GPT-OSS 120b 모델의 크기는 65GB로, RTX 4080의 16GB VRAM에 맞지 않으며, 더 최근의 RTX 5080에도 맞지 않습니다.
Docker Model Runner 명령어의 빠른 참조
Docker Model Runner (DMR)은 2025년 4월에 도입된 Docker의 공식 솔루션으로, 로컬에서 AI 모델을 실행하는 데 사용됩니다. 이 가이드는 모든 필수 명령, 구성 및 최선의 실천 방법을 위한 빠른 참조를 제공합니다.
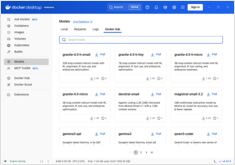
로컬 LLM용 Docker Model Runner와 Ollama 비교
로컬에서 대규모 언어 모델(LLM) 실행 는 프라이버시, 비용 관리 및 오프라인 기능을 위해 점점 더 인기를 끌고 있습니다. 2025년 4월에 Docker가 Docker Model Runner (DMR), AI 모델 배포를 위한 공식 솔루션을 도입하면서 상황은 크게 변화했습니다.
GNOME Boxes를 사용한 Linux용 간단한 가상 머신 관리
현대 컴퓨팅 환경에서 가상화는 개발, 테스트, 여러 운영 체제의 실행에 필수적인 요소가 되었습니다. Linux 사용자들이 가상 머신을 관리하는 데 간단하고 직관적인 방법을 원한다면, GNOME Boxes는 기능성을 희생하지 않고 사용 편의성을 중시하는 가벼운 사용자 친화적인 옵션으로 두드러집니다.
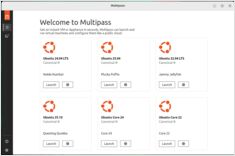
다중 패스 설치, 설정 및 필수 명령어
Multipass은 Linux, Windows, macOS에서 Ubuntu 클라우드 인스턴스를 쉽게 생성하고 관리할 수 있는 가벼운 가상 머신 관리자입니다.
구글과 빙을 넘어 다른 검색 엔진을 탐색해 보세요.
구글이 전 세계 시장 점유율의 90% 이상을 차지하며 검색 엔진 시장을 지배하고 있지만, 다양한 접근 방식을 제공하는 대체 검색 엔진들이 성장하고 있는 생태계가 존재합니다.
ASIC과 맞춤형 실리콘은 LLM 추론 속도와 효율성을 높입니다
내용을 소유하고, 자신의 정체성을 통제하세요.
가용성, 6개국의 실제 소매 가격, 그리고 Mac Studio와의 비교
**NVIDIA DGX Spark**는 실제로 존재하며, 2025년 10월 15일부터 판매가 시작되어 통합 NVIDIA AI 스택과 함께 로컬 LLM 작업이 필요한 CUDA 개발자를 대상으로 하고 있습니다. 미국 소비자 권장 정가(MSRP)는 3,999달러이며, 영국/독일/일본의 소매 가격은 부가가치세(VAT)와 유통 채널에 따라 더 높은 편입니다. 호주/한국의 공개 스티커 가격은 아직 널리 게시되지 않았습니다.
Gemini - 웹의 가볍고 안전한 대안
Gemini 프로토콜(Gemini 프로토콜)은 인터넷 커뮤니케이션의 근본 원칙으로 돌아가는 것으로, 점점 복잡해지는 현대 웹의 대안으로 가볍고, 보안이 강하고, 개인정보 보호에 중점을 두고 있습니다.
Ollama를 Go와 통합하기: SDK 가이드, 예제 및 프로덕션 베스트 프랙티스
이 가이드에서는 Ollama용 Go SDK에 대한 포괄적인 개요를 제공하고 기능 세트를 비교합니다.
두 모델의 속도, 파라미터 및 성능 비교
다음은 Qwen3:30b와 GPT-OSS:20b 비교 내용입니다. 지시 따름 능력(instruction following)과 성능 파라미터, 사양 및 속도에 초점을 맞추었습니다.