Llm

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

Por qué el contexto de 128K falla con 16 GB

Un modelo puede publicitar una ventana de contexto de 128K y aun así fallar en 40K tokens en una GPU de 16 GB. El límite de la arquitectura nunca prometió que los pesos, la caché KV, los búferes de cálculo y el compositor del escritorio cabrían en tu tarjeta al mismo tiempo.
Introducción a Superpowers: instalación, flujo de trabajo y prueba

Introducción a Superpowers: instalación, flujo de trabajo y prueba

Habilidades SDD forzadas, instaladas con un solo comando.

Superpowers empaqueta una metodología completa basada en especificaciones en habilidades de Claude instalables, imponiendo la lluvia de ideas, la planificación, la implementación dirigida por subagentes y una estricta TDD (Desarrollo Dirigido por Pruebas), en lugar de dejar esa estructura a tu criterio.

Gravedad de los datos: el verdadero costo de la IA con enfoque en la API

Gravedad de los datos: el verdadero costo de la IA con enfoque en la API

«Por qué tu pila de IA se vuelve más pegajosa cada mes.»

Cada llamada a una API se siente como una transacción simple… hasta que se acumulan tantas que tus datos de afinamiento, tus arneses de evaluación y tus esquemas de herramientas quedan moldeados en torno a un solo proveedor, y cambiar deja de ser un simple cambio de ruteo.

Subagentes de Claude Code: configuración, configuración y cuándo usarlos

Subagentes de Claude Code: configuración, configuración y cuándo usarlos

Delega el trabajo ruidoso y mantén tu contexto limpio.

La mayoría de las sesiones de Claude Code se vuelven lentas y desordenadas por la misma razón: cada búsqueda exploratoria con grep, cada volcado de registros y cada “déjame revisar un archivo más” permanece en la conversación principal para siempre.

De Ollama a vLLM: cuándo migrar tu servidor local de LLM

De Ollama a vLLM: cuándo migrar tu servidor local de LLM

Cuándo migrar de Ollama a vLLM

Ollama es una de las formas más sencillas de ejecutar un modelo de lenguaje local, pero la comodidad puede ocultar el momento en que un experimento local se convierte en un servicio de inferencia compartido que necesita una mejor planificación y observabilidad.

Mantener especificaciones, pruebas y código sincronizados en el desarrollo de IA

Mantener especificaciones, pruebas y código sincronizados en el desarrollo de IA

Evita que los agentes de IA se desvíen de las especificaciones, las pruebas y el código.

Los agentes de codificación con IA implementan características rápidamente, pero las especificaciones, las pruebas y el código se desvían silenciosamente entre sí. Esta guía cubre un modelo de trazabilidad, el mapeo de especificación a prueba y de especificación a código, y las verificaciones de integración continua (CI) que detectan la desviación antes de una fusión.

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

Comparativa de GPUs de IA entre tres proveedores

El panorama del hardware para IA ha cambiado significativamente en 2026, con NVIDIA, AMD e Intel compitiendo por los desarrolladores que necesitan GPUs capaces de ejecutar modelos de lenguaje grandes (LLM) locales y cargas de trabajo de inferencia de IA.

Decodificación especulativa: inferencia de LLM 20-50 % más rápida

Decodificación especulativa: inferencia de LLM 20-50 % más rápida

Inferencia más rápida de LLM sin pérdida de calidad: una guía práctica

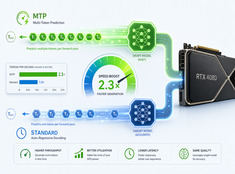
Un modelo de 70B genera un token por pasada hacia adelante (forward pass), y cada pasada recarga los pesos desde la VRAM, calcula la atención a través del contexto y sincroniza la memoria. Entre tokens, la GPU se queda inactiva mientras espera a que se resuelvan las dependencias secuenciales.